
-
-
-
ઉદ્યોગ દ્વારા
-
ઉપયોગના કેસ દ્વારા
-
-
કંપની
કસ્ટમ વેક વર્ડ ટ્રેનિંગ ડેટા સાથે હંમેશા સાંભળતી વૉઇસ એપ્લિકેશનો બનાવો. ઉચ્ચ શોધ ચોકસાઈ, ઓછા ખોટા સક્રિયકરણો.
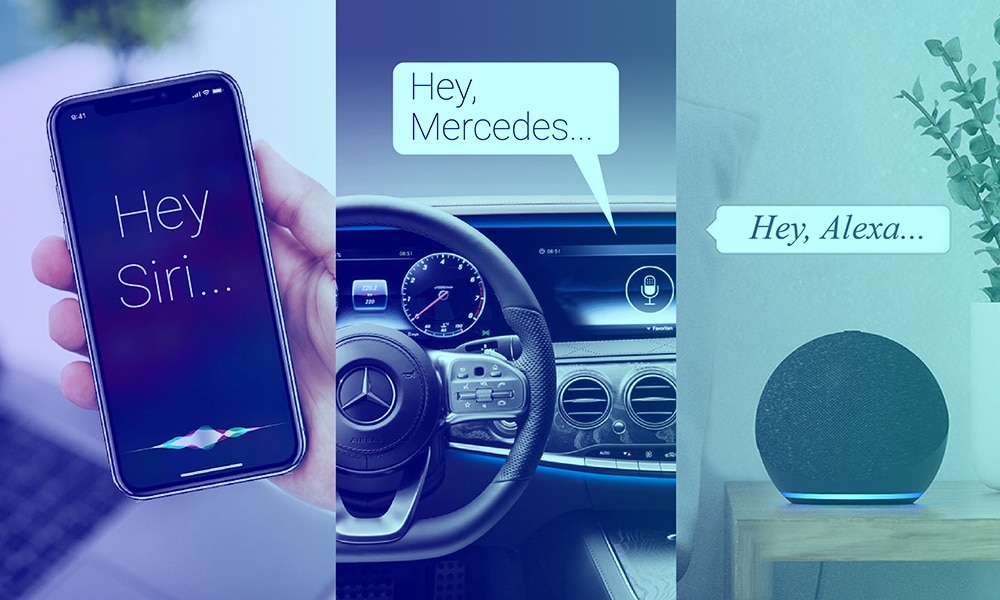
વોઇસ આસિસ્ટન્ટ્સે ગ્રાહકોના તેમના ઉપકરણો સાથે ક્રિયાપ્રતિક્રિયા કરવાની રીતમાં નાટ્યાત્મક પરિવર્તન લાવ્યું છે. તેમણે વપરાશકર્તાઓ માટે ઉત્પાદનો અને સેવાઓનું ઝડપી અને કાર્યક્ષમ રીતે અન્વેષણ કરવાનું સરળ બનાવ્યું છે. જો કે, શું વોઇસ એપ્લિકેશન સાંભળી રહી છે? આ એપ્લિકેશનોને ઉચ્ચ ગતિમાં મૂકવા માટે, તેમને જાગૃત કરવાની અને વેક વર્ડ્સની મદદથી નિષ્ક્રિયથી સક્રિય શ્રવણમાં સંક્રમણ કરવાની જરૂર છે. 'એલેક્સા' અને "હે સિરી" વિશ્વના બે સૌથી લોકપ્રિય વેક શબ્દો છે.
2024 સુધીમાં, ડિજિટલ વોઇસ આસિસ્ટન્ટની સંખ્યા 8.4 અબજ યુનિટ સુધી પહોંચવાની આગાહી છે - જે વિશ્વની વસ્તી કરતા વધુ છે.
વોઇસ આસિસ્ટન્ટ એપ માર્કેટનું કદ 2021 માં $2.8 બિલિયનથી વધીને 2026 માં $11.2 બિલિયન થવાની ધારણા છે , જે 32.4% ના CAGR પર છે.
વેક વર્ડ એ 'હે સિરી', 'ઓકે ગુગલ' અને 'એલેક્સા' જેવા ચોક્કસ શબ્દ અથવા વાક્ય છે; જે ઉચ્ચારણ સમયે પ્રતિસાદ આપવા માટે વૉઇસ-એક્ટિવેટેડ ડિવાઇસને સક્રિય કરવા માટે રચાયેલ છે. જો કે, હંમેશા સાંભળતો વેક વર્ડ જે ઉપકરણ સાથે સ્થાનિક રીતે સંકલિત હોય છે તે પ્રતિભાવ સમયને નાટકીય રીતે ઘટાડે છે અને ઇન્ટરનેટ કનેક્શન વિના પણ વેક વર્ડની ઓળખ અને પ્રક્રિયા ચોકસાઈમાં વધારો કરે છે. શૈપ 100+ ભાષાઓ, વિવિધ ઉચ્ચારો, વય જૂથો અને વાસ્તવિક દુનિયાના અવાજ વાતાવરણમાં વેક વર્ડ તાલીમ ડેટા એકત્રિત કરે છે જેથી શોધ ચોકસાઈ મહત્તમ થાય અને ખોટા સક્રિયકરણો ઓછા થાય. તેઓ આ તરીકે પણ ઓળખાય છે:
Shaip ની હંમેશા સાંભળતી વેક વર્ડ તાલીમ સાથે, તમારા વોઇસ આસિસ્ટન્ટ મોડેલ્સ હંમેશા વેક વર્ડ સાંભળવા માટે ટ્યુન કરેલા હોય છે, પરંતુ વાસ્તવમાં ક્લાઉડ પર ડેટા રેકોર્ડ કર્યા વિના અથવા ટ્રાન્સમિટ કર્યા વિના. Shaip સાથે ભાગીદારી કરવાથી તમને નિષ્ણાતો સાથે કામ કરવાનો ફાયદો મળે છે. વોઇસ આસિસ્ટન્ટ તાલીમ વિકસાવવામાં AI અને ML ટેકનોલોજીનો ઉપયોગ કરીને અમારા વ્યાપક અનુભવ સાથે, અમે તમને ગોપનીયતા જોખમોને દૂર કરવામાં, વપરાશકર્તા અનુભવ સુધારવામાં, વિકાસ ખર્ચ ઘટાડવામાં અને સ્કેલેબિલિટી વધારવામાં મદદ કરીએ છીએ.
Shaip સંપૂર્ણપણે બ્રાન્ડેડ વેક શબ્દો માટે તાલીમ ડેટા બનાવે છે જેથી ગ્રાહકો તમારા બ્રાન્ડ નામનો ઉપયોગ કરે - સામાન્ય સહાયક નહીં. દરેક ડેટાસેટ તમારા ચોક્કસ સક્રિયકરણ શબ્દસમૂહ સાથે ટ્યુન થયેલ છે, દરેક ક્રિયાપ્રતિક્રિયા સાથે બ્રાન્ડ રિકોલને મજબૂત બનાવે છે અને તમારા પોતાના ઇકોસિસ્ટમમાં વૉઇસ અનુભવ રાખે છે.
શેપ હંમેશા સાંભળતા વેક વર્ડ મોડેલ્સને સપોર્ટ કરે છે જે ક્લાઉડ પર ઑડિયો રેકોર્ડ કર્યા વિના અથવા ટ્રાન્સમિટ કર્યા વિના ઉપકરણ પર ચાલે છે. ઉપકરણ પર વેક વર્ડ તાલીમ ડેટા લેટન્સી ઘટાડે છે, ગોપનીયતાનું જોખમ ઘટાડે છે અને ઇન્ટરનેટ કનેક્શન વિના પણ શોધને વિશ્વસનીય રીતે કાર્યરત રાખે છે.
શૈપ 100+ ભાષાઓ અને પ્રાદેશિક ઉચ્ચારો - સ્કોટિશ, કેનેડિયન, ઓસ્ટ્રેલિયન, ભારતીય અંગ્રેજી અને તેનાથી આગળ - માં વેક શબ્દ ઉચ્ચારણો એકત્રિત કરે છે જેથી બિન-મૂળ બોલનારાઓ માટે નીચું થવાને બદલે વૈશ્વિક વપરાશકર્તા પાયા પર શોધ ચોકસાઈ જાળવી રાખવામાં આવે.
શૈપ શાંત, ઘોંઘાટીયા, કારમાં, બહાર અને દૂરના ક્ષેત્રમાં વેક વર્ડ ડેટા કેપ્ચર કરે છે. વાસ્તવિક દુનિયાના એકોસ્ટિક ભિન્નતા પર તાલીમ જ્યારે વપરાશકર્તાઓ દૂરથી અથવા પૃષ્ઠભૂમિ અવાજમાં બોલે છે ત્યારે ખોટા અસ્વીકાર ઘટાડે છે.
વેક શબ્દ ઉપરાંત, શેપ ઉચ્ચારણ અને શબ્દસમૂહ-સ્પોટિંગ ડેટા પ્રદાન કરે છે જેથી ઉપકરણો ઓછી વિલંબતા સાથે લાંબા સમય સુધી કુદરતી-ભાષાના આદેશો પર પ્રક્રિયા કરે. એમ્બેડેડ કીવર્ડ શોધ ડેટા ઉચ્ચ ચોકસાઈ અને ગોપનીયતા માટે ઓન-બ્રાઉઝર અને ઓન-ચિપ પ્રોસેસિંગને સપોર્ટ કરે છે.
વિવિધ ધ્વનિઓ સામાન્ય રીતે વધુ સ્પષ્ટ હસ્તાક્ષર બનાવે છે અને પરિણામોમાં વધુ સારી ચોકસાઈ સુનિશ્ચિત કરે છે. તેથી, તમારા ડેટામાંથી એવા શબ્દસમૂહો પસંદ કરો જે વિવિધ ધ્વનિ ઉત્પન્ન કરે છે.
"હાય," "હેલો," "હે," અથવા "ઓકે" જેવા ઉપસર્ગ લગાવીને વેક શબ્દોને વધુ અસરકારક બનાવો. તે વેક શબ્દને અસ્પષ્ટ રાખશે અને નિયમિત ભાષણમાં ટ્રિગર શબ્દનો ઉપયોગ કરતી વખતે કોઈ આકસ્મિક મેળ ન થાય તેની ખાતરી કરશે.
તમારા વેક શબ્દોને ઓછામાં ઓછા છ ધ્વનિઓનું મિશ્રણ બનાવો જે મશીન દ્વારા સરળતાથી ઓળખી શકાય અને માણસો દ્વારા સરળતાથી બોલી શકાય. ઉદાહરણ તરીકે, "એલેક્સા" માં છ ફેનોમ છે જ્યારે "ઓકે ગૂગલ" માં આઠ ફેનોમ છે.
તમારા જાગવાના શબ્દ તરીકે એક પણ શબ્દ વાપરવાની ભૂલ ન કરો. જાગવાના શબ્દો એટલા લાંબા હોવા જોઈએ કે તે સ્પષ્ટ દેખાય.
ખાતરી કરો કે તમે જે ટ્રિગર શબ્દો બનાવો છો તે સરળ અને અનન્ય હોવા જોઈએ જેથી તેઓ સરળતાથી યાદ રહી શકે.
લાંબા બહુ-શબ્દવાળા જાગવાના શબ્દસમૂહો ઉચ્ચારવામાં મુશ્કેલ હોય છે અને પ્રક્રિયાને બિનજરૂરી રીતે મુશ્કેલ બનાવે છે.
સામાન્ય રીતે વેક વર્ડ મોડેલને વિવિધ ઉચ્ચારણોની સંખ્યા ઓળખવા માટે તાલીમ આપવામાં આવે છે, જેથી તે વિવિધ આમંત્રણોનો પ્રતિસાદ આપી શકે. જોકે, ઘણા બધા અલગ વેક વર્ડ હોવાને કારણે સ્પીચ પાઇપલાઇન સક્રિય થઈ શકે છે, જેનાથી તમને ખબર નહીં પડે કે વપરાશકર્તાએ કયો ઉચ્ચારણ બોલ્યો છે.
અવાજ, અંતર અને ઉચ્ચારો અને ભાષામાં ભિન્નતા જેવા પરિબળો તમારા AI મોડેલ માટે સચોટ હોટવર્ડ શોધને વધુ મુશ્કેલ અને જટિલ બનાવે છે.

વૉઇસ ટેક્નોલોજીમાં અમારો અનુભવ અમને હંમેશા સાંભળવા યોગ્ય વેક શબ્દો અને બ્રાન્ડેડ વેક શબ્દસમૂહો ઝડપથી વિકસાવવામાં મદદ કરે છે. કુદરતી ભાષા પ્રક્રિયા સમજણ સાથે વૉઇસ ઓળખ સાથે, ML અલ્ગોરિધમ્સ વાણીને ટ્રાન્સક્રાઇબ કરવામાં અને વૉઇસ આદેશોને અસરકારક રીતે ચલાવવામાં મદદ કરે છે.

બ્રાન્ડેડ શબ્દના કસ્ટમાઇઝેશનને સુનિશ્ચિત કરવા માટે અમે વેક વર્ડ પ્રોટોટાઇપિંગ ઝડપથી વિકસાવવા પર ધ્યાન કેન્દ્રિત કરીએ છીએ. પ્રોટોટાઇપ ખ્યાલના પુરાવા તરીકે કાર્ય કરે છે અને સચોટ તાલીમ, બજારમાં ઝડપી સમય, ઝડપી પરીક્ષણ અને જોખમો દૂર કરવામાં મદદ કરે છે.

એક અસાધારણ વૉઇસ સહાયક સાથે અવિરત વૃદ્ધિ અને ગ્રાહક જોડાણનો અનુભવ કરો. અમે બહુભાષી વાણી ઓળખ ક્ષમતાઓ પ્રદાન કરીએ છીએ જેથી એપ્લિકેશન ઉચ્ચ-ઘોંઘાટવાળા વાતાવરણમાં પણ શબ્દો અને શબ્દસમૂહોને સચોટ રીતે શોધી શકે.
તે મહત્વપૂર્ણ વપરાશકર્તા ડેટા જેમ કે તેમની ઓળખ, મૂળ દેશ, ઉંમર, લિંગ, ભાષા, ઉચ્ચારો, વગેરે એકત્રિત કરવાની એક રીત છે. વધુ સચોટ પરિણામો પ્રાપ્ત કરવા માટે વપરાશકર્તા-લક્ષી અલ્ગોરિધમ્સને સુધારવા માટે ડેટા વિવિધતાનો ઉપયોગ થાય છે.
ડેટા સામાન્ય રીતે બિલ્ટ-ઇન પૂર્વગ્રહો પેદા કરે છે. તેથી, જ્યારે આપણે વિવિધ સ્ત્રોતોમાંથી ડેટા એકત્રિત કરીએ છીએ, ત્યારે પરિણામોમાં પૂર્વગ્રહ નોંધપાત્ર રીતે ઓછો થાય છે.
અહીં ડેટા વિવિધતાના કેટલાક પરિમાણો છે જેને શેપ વેક શબ્દો અને અન્ય વાતચીત આદેશો બનાવતી વખતે સંબોધે છે.

| રેસ અને એથ્નિસિટી | હિન્દુ, મુસ્લિમ, ખ્રિસ્તી, આફ્રિકન્સ, યુરોપિયનો |
| શિક્ષણનું સ્તર | સ્નાતક, સ્નાતક, પીએચ.ડી., માસ્ટર્સ |
| દેશ | ચીન, જાપાન, ભારત, કોરિયા, દુબઈ, નાઈજીરીયા, યુએસએ, કેનેડા |
| સેક્સ | પુરુષ સ્ત્રી |
| ઉંમર | ૧૦ વર્ષથી ઓછી ઉંમર, ૧૦-૧૫, ૧૫-૨૫, ૨૫-૪૫, ૪૫ વર્ષ અને તેથી વધુ ઉંમરના |
| ભાષા | અંગ્રેજી, જાપાનીઝ, ટર્કિશ, ચાઇનીઝ, થાઈ, હિન્દી |
| પર્યાવરણ | શાંત, ઘોંઘાટીયા, પૃષ્ઠભૂમિ સંગીત, પૃષ્ઠભૂમિ અવાજ/ભાષણ, ઇન્ડોર, આઉટડોર, થિયેટર, સ્ટેડિયમ, કાફેટેરિયા, કારમાં, ઓફિસ, શોપિંગ મોલ, ઘરનો અવાજ, સીડી, શેરી/રસ્તો, દરિયા કિનારે (પવન) |
| ઉચ્ચારો (અંગ્રેજી) | સ્કોટિશ અંગ્રેજી, વેલ્શ અંગ્રેજી, હિબર્નો-અંગ્રેજી, કેનેડિયન અંગ્રેજી, ઓસ્ટ્રેલિયન અંગ્રેજી, ન્યુઝીલેન્ડ અંગ્રેજી |
| બોલવાની શૈલી | ઝડપી/સામાન્ય/ધીમી ગતિ, ઉચ્ચ/સામાન્ય/સોફ્ટ વોલ્યુમ, ઔપચારિક/કેઝ્યુઅલ |
| ઉપકરણની સ્થિતિ | હેન્ડહેલ્ડ, ડેસ્કટોપ |
સ્પીકર્સ, ટીવી અને ઉપકરણો માટે શબ્દ ડેટા જાગૃત કરો જે તાત્કાલિક સક્રિય થવા જોઈએ અને પૃષ્ઠભૂમિ ચેટરને નકારી કાઢવો જોઈએ.
હેન્ડ્સ-ફ્રી ઇન-કેબિન સહાયકો માટે દૂર-ક્ષેત્ર, અવાજ-મજબૂત વેક વર્ડ ડેટાસેટ્સ.
હંમેશા ચાલુ, બેટરી-સંકુચિત ઉપકરણો માટે ઓછા-ફૂટપ્રિન્ટ વેક વર્ડ ડેટા.
ભાષાઓ અને બોલીઓમાં સહાયકોને સ્થાનિક બનાવવા માટે કસ્ટમ વેક શબ્દ અને ઉચ્ચારણ ડેટા.
હેન્ડ્સ-ફ્રી ક્લિનિકલ અને દર્દી સેટિંગ્સ માટે ગોપનીયતા-પ્રથમ, ઉપકરણ પર વેક વર્ડ ડેટા.
ક્લાઉડ વિના રીઅલ ટાઇમમાં પ્રતિસાદ આપતા રોબોટ્સ માટે મલ્ટિમોડલ વેક વર્ડ અને કમાન્ડ ડેટા.
Shaip તમારી સાથે મળીને ધ્વન્યાત્મક રીતે અલગ, બ્રાન્ડ-સંરેખિત વેક શબ્દ પસંદ કરે છે અને સંગ્રહ માર્ગદર્શિકા વ્યાખ્યાયિત કરે છે.
શેપનું વૈશ્વિક કાર્યબળ જરૂરી ભાષાઓ, ઉચ્ચારો, ઉંમર, ઉપકરણો અને ઘોંઘાટ વાતાવરણમાં વેક શબ્દ રેકોર્ડ કરે છે.
દરેક ઉચ્ચારણ તમારા સ્વીકૃતિ માપદંડો અનુસાર લખાયેલું, લેબલ થયેલ અને ગુણવત્તા-ચકાસાયેલ છે.
શેપ તમારા મોડેલ પાઇપલાઇન માટે ફોર્મેટ કરેલ સ્ટ્રક્ચર્ડ, પોલિસી-નિયંત્રિત વેક વર્ડ ટ્રેનિંગ ડેટા પહોંચાડે છે.
તમારી AI પહેલને અસરકારક રીતે ઉપયોગમાં લેવા માટે, તમારે મોટા પ્રમાણમાં વિશિષ્ટ તાલીમ ડેટાસેટ્સની જરૂર પડશે. Shaip એ બજારમાં ખૂબ જ ઓછી કંપનીઓમાંની એક છે જે નિયમનકારી/GDPR આવશ્યકતાઓનું પાલન કરીને વિશ્વ-સ્તરીય, વિશ્વસનીય તાલીમ ડેટા સુનિશ્ચિત કરે છે.
કસ્ટમ માર્ગદર્શિકાના આધારે વિશ્વભરના 100+ દેશોમાંથી કસ્ટમ-બિલ્ટ ડેટાસેટ્સ (ટેક્સ્ટ, સ્પીચ, છબી, વિડિઓ) બનાવો, ક્યુરેટ કરો અને એકત્રિત કરો.
30,000+ અનુભવી અને પ્રમાણિત યોગદાનકર્તાઓના અમારા વૈશ્વિક કાર્યબળનો લાભ લો. લવચીક કાર્ય સોંપણી અને રીઅલ-ટાઇમ કાર્યબળ ક્ષમતા, કાર્યક્ષમતા અને પ્રગતિ દેખરેખ.
અમારું માલિકીનું પ્લેટફોર્મ અને કુશળ કાર્યબળ AI તાલીમ ડેટાસેટ્સ એકત્રિત કરવા માટે નિર્ધારિત ગુણવત્તા ધોરણોને પૂર્ણ કરવા અથવા તેનાથી વધુ કરવા માટે બહુવિધ ગુણવત્તા નિયંત્રણ પદ્ધતિઓનો ઉપયોગ કરે છે.
અમારી પ્રક્રિયા એપ્લિકેશન અને વેબ ઇન્ટરફેસથી સીધા જ સરળ કાર્ય વિતરણ, સંચાલન અને ડેટા કેપ્ચર દ્વારા સંગ્રહ પ્રક્રિયાને સુવ્યવસ્થિત કરે છે.
ગોપનીયતાને અમારી પ્રાથમિકતા બનાવીને સંપૂર્ણ ડેટા ગુપ્તતા જાળવીએ છીએ. અમે ખાતરી કરીએ છીએ કે ડેટા ફોર્મેટ નીતિ દ્વારા નિયંત્રિત અને સાચવવામાં આવે.
ગ્રાહક ડેટા સંગ્રહ માર્ગદર્શિકાના આધારે ઉદ્યોગ-વિશિષ્ટ સ્ત્રોતોમાંથી એકત્રિત કરાયેલ ક્યુરેટેડ ડોમેન-વિશિષ્ટ ડેટા.
શેપ વિશ્વભરના વિવિધ પ્રેક્ષકોને પૂરી પાડવા માટે વૉઇસ-સક્ષમ તકનીકોને સક્ષમ બનાવવા માટે 150+ થી વધુ ભાષાઓમાં એન્ડ-ટુ-એન્ડ સ્પીચ/ઑડિઓ ડેટા કલેક્શન સેવાઓ પ્રદાન કરે છે.
તમે જે ચેટબોટ સાથે વાતચીત કરી છે તે એક અદ્યતન વાતચીત AI સિસ્ટમ પર ચાલે છે જે તાલીમ પામેલ, પરીક્ષણ કરાયેલ અને ટનબંધ સ્પીચ રેકગ્નિશન ડેટાસેટ્સનો ઉપયોગ કરીને બનાવવામાં આવેલ છે. તે ટેકનોલોજી પાછળની મૂળભૂત પ્રક્રિયા છે જે મશીનોને બુદ્ધિશાળી બનાવે છે.
ઉચ્ચારણ તાલીમની જરૂરિયાત એટલા માટે ઊભી થાય છે કારણ કે બધા ગ્રાહકો સ્ક્રિપ્ટેડ ફોર્મેટમાં તેમના વૉઇસ સહાયકો સાથે વાતચીત કરતી વખતે અથવા પ્રશ્નો પૂછતી વખતે ચોક્કસ શબ્દો અથવા શબ્દસમૂહોનો ઉપયોગ કરતા નથી.
વિશ્વ-અગ્રણી AI ઉત્પાદનો બનાવવા માટે ટીમોને સશક્ત બનાવવી.


વેક વર્ડ એ એક ચોક્કસ શબ્દ અથવા વાક્ય છે - જેમ કે "એલેક્સા," "ઓકે ગૂગલ," અથવા કસ્ટમ બ્રાન્ડેડ વાક્ય - જે વૉઇસ-સક્ષમ ઉપકરણને સક્રિય કરે છે અને તેને નિષ્ક્રિયથી સક્રિય શ્રવણમાં ફેરવે છે. ઉપકરણ સતત વેક વર્ડ માટે સ્થાનિક રીતે સાંભળે છે અને વેક વર્ડ શોધાયા પછી જ વિનંતી પર પ્રક્રિયા કરવાનું શરૂ કરે છે.
વેક વર્ડ ટ્રેનિંગ ડેટા એ બોલાતી રેકોર્ડિંગ્સનો લેબલ થયેલ સમૂહ છે જેનો ઉપયોગ મોડેલને તેના સક્રિયકરણ શબ્દસમૂહને ઓળખવાનું શીખવવા માટે થાય છે. અસરકારક વેક વર્ડ ટ્રેનિંગ ડેટા ઘણા સ્પીકર્સ, ઉચ્ચારો, ઉંમર, ઉપકરણો અને અવાજની સ્થિતિઓને આવરી લે છે જેથી મોડેલ સમાન અવાજવાળી વાણીને નકારી કાઢતી વખતે વિશ્વસનીય રીતે ટ્રિગર થાય.
વેક વર્ડ એક નાનું, હંમેશા સાંભળતું શોધ મોડેલ ચલાવીને કાર્ય કરે છે જે લક્ષ્ય શબ્દસમૂહ માટે આવનારા ઑડિઓને સ્કેન કરે છે. જ્યારે મોડેલ વેક વર્ડ સાથે પૂરતા વિશ્વાસ સાથે મેળ ખાય છે, ત્યારે ઉપકરણ સક્રિય થાય છે અને વાણી ઓળખ અને કુદરતી ભાષા પ્રક્રિયાનો ઉપયોગ કરીને વપરાશકર્તાની વિનંતી પર પ્રક્રિયા કરવાનું શરૂ કરે છે.
એક મજબૂત કસ્ટમ વેક શબ્દ વિવિધ ફોનિમનો ઉપયોગ કરે છે, જેમાં ઓછામાં ઓછા ત્રણ થી ચાર સિલેબલ હોય છે, અને ખોટા સક્રિયકરણ ઘટાડવા માટે સામાન્ય રોજિંદા શબ્દો ટાળે છે. "હે" અથવા "ઓકે" જેવા ઉપસર્ગ ઉમેરવાથી વિશિષ્ટતામાં સુધારો થાય છે. શેપ પ્રોજેક્ટ સેટઅપ દરમિયાન વેક શબ્દો પસંદ કરવામાં અને માન્ય કરવામાં મદદ કરે છે.
હા. ઓન-ડિવાઇસ વેક વર્ડ ડિટેક્શન સ્થાનિક રીતે સક્રિયકરણ મોડેલ ચલાવે છે, તેથી ઑડિઓ રેકોર્ડ થતો નથી અથવા ક્લાઉડ પર મોકલવામાં આવતો નથી. આ લેટન્સી ઘટાડે છે, ગોપનીયતાનું રક્ષણ કરે છે અને ડિટેક્શનને ઑફલાઇન કાર્યરત રાખે છે. Shaip ખાસ કરીને ઓન-ડિવાઇસ અને એમ્બેડેડ ડિપ્લોયમેન્ટ માટે યોગ્ય તાલીમ ડેટા એકત્રિત કરે છે.
શેપ ૧૦૦+ ભાષાઓમાં અને ૧૦૦+ દેશોમાં વૈશ્વિક કાર્યબળમાંથી મેળવેલા પ્રાદેશિક ઉચ્ચારોની વિશાળ શ્રેણીમાં વેક વર્ડ તાલીમ ડેટા એકત્રિત કરે છે. આ પહોળાઈ બિન-મૂળ બોલનારાઓ માટે ચોકસાઈના અંતરને ઘટાડે છે અને વૈશ્વિક ઉત્પાદન લોન્ચને સમર્થન આપે છે.
શેપ બહુવિધ ગુણવત્તા-નિયંત્રણ પાસ - ટ્રાન્સક્રિપ્શન સમીક્ષા, સ્વીકૃતિ માપદંડ અને કાર્યબળ દેખરેખ - લાગુ કરે છે જેથી ડેટાસેટ્સ ડિલિવરી પહેલાં લક્ષ્ય ચોકસાઈને પૂર્ણ કરે. વૈવિધ્યસભર, ઉચ્ચ-ગુણવત્તાવાળા ડેટા ડિપ્લોય્ડ મોડેલમાં ખોટા-સ્વીકાર અને ખોટા-અસ્વીકાર દર બંને ઘટાડે છે.
જાગવાનો શબ્દ ઉપકરણને સક્રિય કરે છે; ઉચ્ચારણ એ પછી આવતી બોલાતી વિનંતી છે. જાગવાનો શબ્દ શોધ એ હંમેશા ચાલુ રહેતું એક સાંકડી કાર્ય છે, જ્યારે ઉચ્ચારણ સમજણમાં વિવિધ કુદરતી-ભાષાના શબ્દસમૂહોનું અર્થઘટન શામેલ છે. શૈપ જાગવાનો શબ્દ શોધ અને ઉચ્ચારણ સંગ્રહ બંને માટે તાલીમ ડેટા પ્રદાન કરે છે.
ઉચ્ચારણ એ એક વાક્ય છે જે વપરાશકર્તા વૉઇસ-કમાન્ડ સૉફ્ટવેરને વિનંતી કરવા માટે બોલે છે. સોફ્ટવેર ઉચ્ચારણમાંથી વપરાશકર્તાના ઉદ્દેશ્યને ઓળખે છે અને તે મુજબ પ્રતિસાદ આપે છે. સંપૂર્ણ વાક્યથી વિપરીત, ઉચ્ચારણ એ વાણીનું એકમ છે જે સંપૂર્ણ વિચાર વ્યક્ત કરી શકતું નથી અને ઘણીવાર તેમાં વિરામ હોય છે. ઉદાહરણો: "મને નવીનતમ મૂવી બતાવો - ગયા અઠવાડિયે રિલીઝ થયેલી," અથવા "શું 22મી સ્ટ્રીટ પરની દુકાન હવે ખુલ્લી છે?"
ઇન્વોકેશન નામ એ એક કીવર્ડ છે જેનો ઉપયોગ વૉઇસ સોફ્ટવેરમાં ચોક્કસ "કૌશલ્ય" ને ટ્રિગર કરવા માટે થાય છે. તેમાં લોકો અથવા સ્થાનોના નામ શામેલ હોઈ શકે છે અને તેને ક્રિયા, આદેશ અથવા પ્રશ્ન સાથે જોડી શકાય છે. દરેક કસ્ટમ કૌશલ્યને શરૂ કરવા માટે એક ઇન્વોકેશન નામની જરૂર હોય છે.
જાગવાના શબ્દોને ટ્રિગર શબ્દો, ગરમ શબ્દો, સક્રિયકરણ શબ્દો, આહવાન શબ્દો, જાગવાના શબ્દસમૂહો અને ઉચ્ચારણો પણ કહેવામાં આવે છે.
એલેક્સા તેના વેક વર્ડને શોધવા માટે ઘણા બિલ્ટ-ઇન માઇક્રોફોનનો ઉપયોગ કરે છે અને બેકગ્રાઉન્ડ નોઇઝને ફિલ્ટર કરે છે. ખોટા હકારાત્મક અને નકારાત્મકને રોકવા માટે, તે "એલેક્સા" શોધ્યા પછી જ સક્રિય શ્રવણ શરૂ કરે છે.

અમારી સાઇટ પર તમારા અનુભવને સુધારવા માટે અમે કૂકીઝનો ઉપયોગ કરીએ છીએ. અમારી સાઇટનો ઉપયોગ કરીને, તમે કૂકીઝ માટે સંમતિ આપો છો.
નીચે તમારી કૂકી પસંદગીઓનું સંચાલન કરો:
આવશ્યક કૂકીઝ મૂળભૂત કાર્યોને સક્ષમ કરે છે અને વેબસાઇટના યોગ્ય કાર્ય માટે જરૂરી છે.
ગૂગલ ટેગ મેનેજર કોડમાં ફેરફાર કર્યા વિના તમારી વેબસાઇટ પર માર્કેટિંગ ટેગ્સના સંચાલનને સરળ બનાવે છે.
આંકડાકીય કૂકીઝ અનામી રીતે માહિતી એકત્રિત કરે છે. આ માહિતી અમને સમજવામાં મદદ કરે છે કે મુલાકાતીઓ અમારી વેબસાઇટનો ઉપયોગ કેવી રીતે કરે છે.
ગૂગલ એનાલિટિક્સ એક શક્તિશાળી સાધન છે જે જાણકાર માર્કેટિંગ નિર્ણયો માટે વેબસાઇટ ટ્રાફિકને ટ્રેક અને વિશ્લેષણ કરે છે.
સેવા URL: policies.google.com (નવી વિંડોમાં ખુલે છે)
માર્કેટિંગ કૂકીઝનો ઉપયોગ વેબસાઇટના મુલાકાતીઓને અનુસરવા માટે થાય છે. તેનો હેતુ એવી જાહેરાતો બતાવવાનો છે જે વ્યક્તિગત વપરાશકર્તા માટે સંબંધિત અને આકર્ષક હોય.
ગૂગલ એડ્સ એક ઓનલાઈન જાહેરાત પ્લેટફોર્મ છે જે વ્યવસાયોને ગૂગલ સર્ચ પરિણામો અને ભાગીદાર સાઇટ્સ પર પ્રદર્શિત લક્ષિત જાહેરાતો બનાવવા માટે સક્ષમ બનાવે છે.
સેવા URL: policies.google.com (નવી વિંડોમાં ખુલે છે)
હબસ્પોટ એક ઓલ-ઇન-વન માર્કેટિંગ, સેલ્સ અને ગ્રાહક સેવા પ્લેટફોર્મ છે જે વ્યવસાય વૃદ્ધિને સુવ્યવસ્થિત કરે છે.
સેવા URL: legal.hubspot.com (નવી વિંડોમાં ખુલે છે)
તમે અમારી કૂકી નીતિ અને ગોપનીયતા નીતિમાં વધુ માહિતી મેળવી શકો છો.