OCR તાલીમ ડેટા અને ટીકા સેવાઓ

ML/AI માટે OCR તાલીમ ડેટા સેવાઓ અને ડેટાસેટ્સ

કસ્ટમ ડેટા કલેક્શન, નિષ્ણાત એનોટેશન અને શેલ્ફની બહારના OCR ડેટાસેટ્સ - ઇન્વોઇસ, રસીદો, હસ્તલેખન, કોષ્ટકો અને બહુભાષી દસ્તાવેજો - 99% ચોકસાઈથી નોંધાયેલા છે* જેથી તમારા મોડેલો કોઈપણ દસ્તાવેજ, કોઈપણ ભાષામાં વાંચી શકે.

ઓપ્ટિકલ કેરેક્ટર રેકગ્નિશન
વૈશ્વિક પ્રમાણિત યોગદાનકર્તાઓ
100 K+
ચોકસાઈ SLA
0 %+
ભાષા સપોર્ટેડ છે
10 +
ઇન-હાઉસ ગ્લોબલ વર્કફોર્સ
1000 +
🔒 HIPAA સુસંગત
GDPR તૈયાર
✅️ ISO 27001 પ્રમાણિત
✅️ SOC 2 ટ્રેડી
OCR તાલીમ ડેટા શું છે - અને શા માટે Shaip

ઉત્પાદન ચોકસાઈ માટે બનાવેલ OCR ડેટાસેટ્સ અને ડેટા એનોટેશન સેવાઓ

OCR તાલીમ ડેટા એ દસ્તાવેજ છબીઓનો એક લેબલ થયેલ સમૂહ છે - સ્કેન, ફોટા અને પ્રિન્ટેડ અથવા હસ્તલિખિત ટેક્સ્ટના PDF - સચોટ ટેક્સ્ટ ટ્રાન્સક્રિપ્શન અને બાઉન્ડિંગ-બોક્સ એનોટેશન સાથે જોડાયેલ છે. મશીન-લર્નિંગ મોડેલો આ છબી-થી-ટેક્સ્ટ ડેટામાંથી દસ્તાવેજોને સંપાદનયોગ્ય, મશીન-વાંચી શકાય તેવા ટેક્સ્ટમાં ફેરવવાનું શીખે છે.

તમે દસ્તાવેજ-સમજણ મોડેલને ફાઇન-ટ્યુન કરી રહ્યા હોવ અથવા શરૂઆતથી ઓપ્ટિકલ કેરેક્ટર રેકગ્નિશન બનાવી રહ્યા હોવ, તમારા લેબલવાળા ડેટાની ગુણવત્તા તમારી ચોકસાઈની ટોચમર્યાદા નક્કી કરે છે. શેપ ડોમેન-એક્સપર્ટ એનોટેટર્સને સાબિત સિક્સ સિગ્મા QA પ્રક્રિયા અને સુરક્ષિત, સુસંગત પ્લેટફોર્મ સાથે જોડે છે - ઇન્વોઇસ, રસીદ, હસ્તલેખન અને બહુભાષી OCR ડેટા પહોંચાડે છે જેના પર તમારા મોડેલો વિશ્વાસ કરી શકે છે, તેને ઘરઆંગણે બનાવવાના ખર્ચના એક ભાગ પર.

Ocr તાલીમ ડેટા
અમે શું ઓફર કરે છે

OCR ડેટા સેવાઓ: સંગ્રહ, ટીકા અને અપ્રચલિત ડેટાસેટ્સ

📥

1. કસ્ટમ OCR ડેટા સંગ્રહ

અમે 60+ દેશોમાં વાસ્તવિક દુનિયાની પરિસ્થિતિઓ અને એજ કેસોમાં, તમારા ચોક્કસ વિશિષ્ટતા - ઇન્વોઇસ, રસીદો, ID, હસ્તલેખન અને બહુભાષી સ્કેન - અનુસાર દસ્તાવેજ છબીઓ એકત્રિત કરીએ છીએ અને એકત્રિત કરીએ છીએ.

🖍️

2. OCR ડેટા એનોટેશન સેવાઓ

ડોમેન નિષ્ણાતો દ્વારા અક્ષર-, શબ્દ- અને પંક્તિ-સ્તરનું ટેક્સ્ટ ટ્રાન્સક્રિપ્શન વત્તા બાઉન્ડિંગ-બોક્સ, ચતુર્ભુજ અને બહુકોણ લેબલિંગ, મલ્ટી-રાઉન્ડ સિક્સ સિગ્મા QA સાથે.

📦

૩. ઑફ-ધ-શેલ્ફ OCR ડેટાસેટ્સ

આજે જ તૈયાર, ગુણવત્તા-ચકાસાયેલ OCR ડેટાસેટ્સ - હસ્તલેખન ઓળખ, રસીદ અને ઇન્વોઇસ, ટેબલ અને બહુભાષી દસ્તાવેજ ડેટા - ને પ્રોટોટાઇપ અને બેન્ચમાર્ક ઝડપી બનાવવા માટે લાઇસન્સ આપો.

OCR ઉપયોગના કિસ્સાઓ

ઇન્વોઇસ અને રસીદ OCR ડેટા

ઇન્વોઇસ OCR અને રસીદ OCR માટે લેબલ થયેલ લાઇન આઇટમ્સ, કુલ, કર અને વિક્રેતા ક્ષેત્રો - એકાઉન્ટ્સ-ચુકવણીપાત્ર અને ખર્ચ ઓટોમેશનને પાવરિંગ.

હસ્તલેખન ઓળખ ડેટાસેટ્સ

ICR અને કર્સિવ-રેકગ્નિશન મોડેલ્સ માટે ઘણા લેખકો, શૈલીઓ અને ભાષાઓમાં ફ્રીસ્ટાઇલ હસ્તલિખિત ટેક્સ્ટ ડેટાસેટ્સ.

કોષ્ટક OCR ડેટાસેટ્સ

જટિલ કોષ્ટકો અને સંરચિત કોષ્ટક દસ્તાવેજોમાંથી પંક્તિ, સ્તંભ અને કોષ-સ્તરનું નિષ્કર્ષણ.

ID અને KYC દસ્તાવેજ OCR

ઓળખ ચકાસણી અને KYC માટે કી-વેલ્યુ એનોટેશન સાથે પાસપોર્ટ, લાઇસન્સ અને ID કાર્ડ.

ફોર્મ અને ટિકિટ OCR ડેટા

ફિલ્ડ-લેવલ લેબલિંગ અને કી-વેલ્યુ એક્સટ્રેક્શન સાથે ફ્લાઇટ ટિકિટ, એપ્લિકેશન અને સ્ટ્રક્ચર્ડ ફોર્મ.

દ્રશ્ય ટેક્સ્ટ ઓળખ ડેટાસેટ્સ

કુદરતી, વાસ્તવિક દુનિયાની છબી પરિસ્થિતિઓમાં કેપ્ચર કરાયેલા સાઇનેજ, લેબલ્સ અને ઉત્પાદન ટેક્સ્ટ.

મુખ્ય વિશેષતાઓ: શા માટે શેઇપનું ટેબલ OCR પસંદ કરવું?

  • રીઅલ-ટાઇમ દસ્તાવેજ પ્રક્રિયા: ભૂલો દૂર કરો અને ખરેખર જે મહત્વનું છે તેના પર ધ્યાન કેન્દ્રિત કરો - તમારા વ્યવસાયનો વિકાસ.
  • કોઈપણ સ્ત્રોતમાંથી ડેટા કેપ્ચર કરો: PDF, સ્કેન, પેપર ડોક્સ, ઇમેઇલ્સ, API અને વધુ - ફોર્મેટની વિશાળ શ્રેણીમાંથી ડેટા વિના પ્રયાસે આયાત કરો.
  • શ્રેષ્ઠ ચોકસાઈ: અમારા OCR API નું લાખો દસ્તાવેજો પર વ્યાપકપણે પરીક્ષણ અને પૂર્વ-પ્રશિક્ષણ કરવામાં આવ્યું છે, જે અસાધારણ વિશ્વસનીયતા સુનિશ્ચિત કરે છે.
  • કાર્યપ્રવાહને સરળ બનાવો: ફાઇલ આયાત, ડેટા ફોર્મેટિંગ, માન્યતા, મંજૂરીઓ, નિકાસ અને એકીકરણને હેન્ડલ કરવા માટે સ્વચાલિત પ્રક્રિયાઓ બનાવો.
  • સમય અને પૈસા બચાવો: બિનકાર્યક્ષમ મેન્યુઅલ કાર્યોમાં વિતાવેલો સમય ઓછો કરો અને ખર્ચાળ ડેટા એન્ટ્રી ભૂલો ટાળો.
  • સીમલેસ એકીકરણ: કાર્યક્ષમ ડેટા સંગ્રહ, નિકાસ, સંગ્રહ, બુકકીપિંગ અને વધુ માટે તમારા હાલના સાધનો સાથે Shaip OCR ને કનેક્ટ કરો.
  • ઉત્પાદકતામાં વધારો: તમારી ટીમને મુખ્ય પ્રવૃત્તિઓ પર ધ્યાન કેન્દ્રિત કરવા માટે સશક્ત બનાવો જ્યારે શેપ બાકીનું સંચાલન કરે છે, જેનાથી તમારી સંસ્થાની ઉત્પાદકતામાં વધારો થાય છે!

ઑફ-ધ-શેલ્ફ કેટલોગ

લાઇસન્સ માટે તૈયાર ઑફ-ધ-શેલ્ફ OCR ડેટાસેટ્સ

પૂર્વ-નિર્મિત, ગુણવત્તા-ચકાસાયેલ OCR ડેટાસેટ્સ જેને તમે આજે લાઇસન્સ આપી શકો છો - હસ્તલેખન, રસીદ અને ઇન્વોઇસ, ટેબલ, બહુભાષી અને દ્રશ્ય-ટેક્સ્ટ ડેટા - અથવા કસ્ટમ OCR ડેટાસેટ બિલ્ડ માટે પ્રારંભિક બિંદુ તરીકે તેનો ઉપયોગ કરી શકો છો.

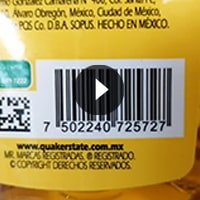
બારકોડ સ્કેનિંગ વિડિઓ ડેટાસેટ

બહુવિધ ભૌગોલિક સ્થળોએથી 5-30 સેકન્ડના સમયગાળા સાથે બારકોડના 40k વિડિઓઝ

બારકોડ સ્કેનિંગ વિડિઓ ડેટાસેટ

ઉપયોગ કેસ: ઑબ્જેક્ટ રેકગ્નિશન મોડેલ

ફોર્મેટ: વિડિઓઝ

વોલ્યુમ: ૫૫,૦૦૦+

ટીકા: ના

ઇન્વોઇસ, PO, રસીદો છબી ડેટાસેટ

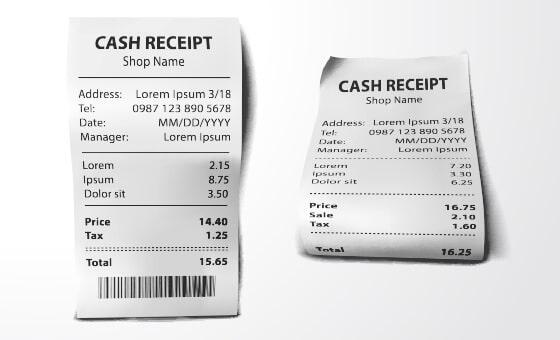
રસીદો, ઇન્વોઇસ, ખરીદી ઓર્ડરની 15.9k છબીઓ 5 ભાષાઓમાં એટલે કે અંગ્રેજી, ફ્રેન્ચ, સ્પેનિશ, ઇટાલિયન અને ડચ.

ઇન્વોઇસ પો રસીદો છબી ડેટાસેટ

ઉપયોગ કેસ: ડૉક. ઓળખ મોડેલ

ફોર્મેટ: છબીઓ

વોલ્યુમ: ૫૫,૦૦૦+

ટીકા: ના

જર્મન અને યુકે ઇન્વોઇસ છબી ડેટાસેટ

જર્મન અને યુકે ઇન્વોઇસની 45 છબીઓ વિતરિત કરી

જર્મન અને યુકે ઇન્વોઇસ છબી ડેટાસેટ

ઉપયોગ કેસ: ઇન્વોઇસ રીકોગ. મોડેલ

ફોર્મેટ: છબીઓ

વોલ્યુમ: ૫૫,૦૦૦+

ટીકા: ના

વાહન લાઇસન્સ પ્લેટ ડેટાસેટ

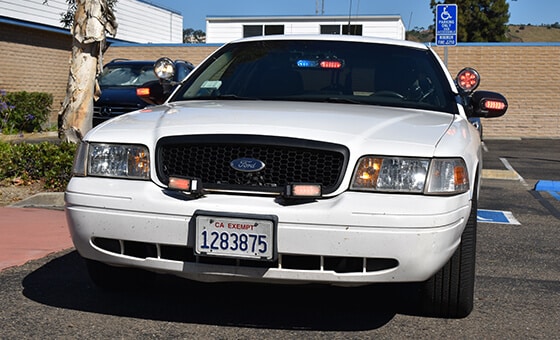
વિવિધ ખૂણાઓથી વાહન લાઇસન્સ પ્લેટની 3.5k છબીઓ

વાહન લાઇસન્સ પ્લેટ ડેટાસેટ

ઉપયોગ કેસ: નંબર પ્લેટ ઓળખ

ફોર્મેટ: છબીઓ

વોલ્યુમ: ૫૫,૦૦૦+

ટીકા: ના

હસ્તલિખિત દસ્તાવેજ છબી ડેટાસેટ

અંગ્રેજી, ફ્રેન્ચ, સ્પેનિશ, જર્મન, ઇટાલિયન, પોર્ટુગીઝ અને કોરિયન ભાષામાં 90 દસ્તાવેજો એકત્રિત અને ટિપ્પણી કર્યા.

હસ્તલિખિત દસ્તાવેજ છબી ડેટાસેટ

ઉપયોગ કેસ: OCR મોડેલ

ફોર્મેટ: છબીઓ

વોલ્યુમ: ૫૫,૦૦૦+

ટીકા: હા

OCR માટે દસ્તાવેજ ડેટાસેટ

ચિહ્નો, સ્ટોરફ્રન્ટ્સ, બોટલ્સ, દસ્તાવેજો, પોસ્ટર્સ, ફ્લાયર્સમાંથી જાપાનીઝ, રશિયન અને કોરિયન ભાષાઓમાં 23.5 હજાર દસ્તાવેજો.

ocr માટે દસ્તાવેજ ડેટાસેટ

ઉપયોગનો કેસ: બહુભાષી OCR મોડેલ

ફોર્મેટ: છબીઓ

વોલ્યુમ: ૫૫,૦૦૦+

ટીકા: હા

યુરોપિયન રસીદ છબી ડેટાસેટ

મુખ્ય યુરોપિયન શહેરોમાંથી પ્રાપ્તિની 11.5k+ છબીઓ

યુરોપિયન રસીદ છબી ડેટાસેટ

ઉપયોગનો કેસ: ઑબ્જેક્ટ શોધ મોડેલ

ફોર્મેટ: છબીઓ

વોલ્યુમ: ૫૫,૦૦૦+

ટીકા: ના

ઇન્વોઇસ/રસીદ ડેટાસેટ

બહુવિધ ભાષાઓમાં 75+ રસીદો

ઇન્વોઇસ રસીદ ડેટાસેટ

ઉપયોગ કેસ: રસીદ AI મોડેલ્સ

ફોર્મેટ: છબીઓ

વોલ્યુમ: ૫૫,૦૦૦+

ટીકા: ના

ઉદ્યોગ દ્વારા

ઉદ્યોગ-વિશિષ્ટ OCR ડેટા સોલ્યુશન્સ

🏥

આરોગ્યસંભાળ અને તબીબી OCR

પ્રિસ્ક્રિપ્શન, લેબ-રિપોર્ટ અને મેડિકલ-ફોર્મ ડેટાસેટ્સ — ક્લિનિકલ ડોક્યુમેન્ટ AI માટે HIPAA-સુસંગત હેન્ડલિંગ.

🏦

બેંકિંગ અને ફિનટેક OCR

નાણાકીય દસ્તાવેજ ડેટા નિષ્કર્ષણ માટે ઇન્વોઇસ, બેંક-સ્ટેટમેન્ટ, ચેક અને KYC-દસ્તાવેજ ડેટા.

🚚

લોજિસ્ટિક્સ અને સપ્લાય-ચેઇન OCR

શિપિંગ અને ફ્રેઇટ ઓટોમેશન માટે કન્સાઇનમેન્ટ નોટ્સ, ડિલિવરી સ્લિપ અને લેડિંગના બિલ.

🛡️

વીમા દસ્તાવેજ OCR

દાવા ફોર્મ, પોલિસી દસ્તાવેજો અને હસ્તલિખિત સબમિશન જે સ્કેલ પર લેબલ થયેલ છે.

🛒

રિટેલ અને સીપીજી ઓસીઆર

ખર્ચ, વફાદારી અને મર્ચેન્ડાઇઝિંગ AI માટે રસીદ, કિંમત-ટેગ અને શેલ્ફ-લેબલ ડેટા.

⚖️

કાનૂની અને જાહેર ક્ષેત્રનો OCR

દસ્તાવેજ પ્રક્રિયા કાર્યક્રમો માટે કરાર, રેકોર્ડ અને આર્કાઇવલ-સ્કેન ડિજિટાઇઝેશન ડેટાસેટ્સ.

અમારી પ્રક્રિયા

અમારી OCR ડેટા એનોટેશન અને ગુણવત્તા-ખાતરી પ્રક્રિયા

OCR ચોકસાઈ કેવી રીતે પ્રાપ્ત થાય છે? યોગ્ય એનોટેશન પ્રકારો વત્તા બહુ-રાઉન્ડ માનવ QA દ્વારા. અમે બાઉન્ડિંગ-બોક્સ, ચતુર્ભુજ અને બહુકોણ એનોટેશનનો ઉપયોગ કરીને અક્ષર, શબ્દ અને પંક્તિ સ્તરે લેબલ કરીએ છીએ, પછી ડિલિવરી પહેલાં દરેક બેચને ચકાસીએ છીએ - 99% ચોકસાઈને લક્ષ્ય બનાવીને.*

1

OCR ડેટા સંગ્રહ

દસ્તાવેજના પ્રકારો, ભાષાઓ અને ધારના કેસ વ્યાખ્યાયિત કરો; સુસંગત દસ્તાવેજ છબીઓ મેળવો અથવા એકત્રિત કરો.

૧️

OCR ડેટા એનોટેશન

પ્રશિક્ષિત નિષ્ણાતો દ્વારા અક્ષર/શબ્દ/પંક્તિ ટેક્સ્ટ ટ્રાન્સક્રિપ્શન + બાઉન્ડિંગ-બોક્સ, ક્વોડ અને બહુકોણ લેબલિંગ.

3

બહુ-રાઉન્ડ QA

સ્વતંત્ર સમીક્ષા અને સિક્સ સિગ્મા તપાસ તમારા SLA સામે અક્ષર અને શબ્દ ભૂલ દર માપે છે.

4

ડિલિવરી અને મોડેલ સપોર્ટ

તમારા મોડેલ-તૈયાર ફોર્મેટમાં મોકલો; પ્રતિસાદ પર સુધારો કરો અને સમય જતાં ડેટાસેટ કવરેજનો વિસ્તાર કરો.

સફળ વાર્તાઓ

Ocr ટેક્સ્ટ શોધ અને ટ્રાન્સક્રિપ્શન એનોટેશન

OCR ટેક્સ્ટ ડિટેક્શન અને ટ્રાન્સક્રિપ્શન એનોટેશન

શેપે એક એન્ડ-ટુ-એન્ડ OCR એનોટેશન પાઇપલાઇન બનાવી - 10+ ટેક્સ્ટ સ્ત્રોતોમાં અક્ષર-સ્તર ટ્રાન્સક્રિપ્શન સાથે શબ્દ-સ્તર બાઉન્ડિંગ બોક્સ, વક્ર સાઇનેજ, ઝાંખા રસીદો, હસ્તાક્ષર અને મિશ્ર સ્ક્રિપ્ટોનો સામનો કરવો. પાંચ એટ્રિબ્યુટ સ્તરો અને ડ્યુઅલ QA એ 99% ચોકસાઈ સાથે ઉત્પાદન-તૈયાર ડેટાસેટ્સ પહોંચાડ્યા.

શા માટે શેપ પસંદ કરો

શા માટે તમારા OCR ડેટા પાર્ટનર તરીકે Shaip ને પસંદ કરો?

શેપે દરેક મોડલિટીમાં AI તાલીમ ડેટા સોર્સિંગ, એકત્રિત અને એનોટેટ કરવામાં વર્ષો વિતાવ્યા છે. ઓપ્ટિકલ કેરેક્ટર રેકગ્નિશન માટે, તેનો અર્થ એ છે કે તમે રાતોરાત ઊંડાણ બનાવી શકતા નથી - વૈશ્વિક પહોંચ, ડોમેન કુશળતા, એન્ટરપ્રાઇઝ-ગ્રેડ સુરક્ષા અને દરેક OCR ડેટાસેટ પાછળ માલિકીનું ટૂલિંગ.

🌍

વૈશ્વિક પહોંચ

60+ દેશોમાંથી 65+ ભાષાઓમાં 70+ વિષયોમાં ડેટા સોર્સ અને ક્યુરેટ કરવામાં આવ્યો છે - મોટાભાગના વિક્રેતાઓ જે કવરેજનો મેળ ખાતા નથી.

🎓

ડોમેન-નિષ્ણાત કાર્યબળ

૩૦,૦૦૦+ પ્રશિક્ષિત ટીકાકારો અને ઉદ્યોગ નિષ્ણાતો ચોક્કસ, સંદર્ભ-જાગૃત OCR ટીકા પહોંચાડે છે, સામાન્ય લેબલિંગ નહીં.

🔐

એન્ટરપ્રાઇઝ સુરક્ષા અને પાલન

GDPR, HIPAA, CCPA, ISO 9001:2015, ISO 27001 અને SOC 2 પ્રકાર II — NDAs અને સુરક્ષિત ડેટા હેન્ડલિંગ સાથે, શરૂઆતથી અંત સુધી.

🧩

માલિકીનું પ્લેટફોર્મ

શેપ મેનેજ , શેપ વર્ક અને શેપ ઇન્ટેલિજન્સ પ્રોજેક્ટ દેખરેખ, વૈશ્વિક કાર્યબળ સંકલન અને સ્વચાલિત ડેટા માન્યતા ચલાવે છે.

💸

ઝડપી અને ઓછી કિંમત

જાતે બનાવવાના ખર્ચના થોડા અંશે ગુણવત્તાયુક્ત ડેટા મેળવો — અને તમારા મોડેલોને ઝડપથી બજારમાં લાવો.

તમે બેન્ચમાર્ક કરી શકો તેવી ગુણવત્તા

છ સિગ્મા QA અને માપી શકાય તેવા ચોકસાઈ લક્ષ્યો (અક્ષર અને શબ્દ ભૂલ દર) એટલે કે ઉત્પાદનમાં તમે વિશ્વાસ કરી શકો તેવો ડેટા.

ચાલો આજે તમારી OCR તાલીમ ડેટા જરૂરિયાતોની ચર્ચા કરીએ.

ડેટા કલેક્શનથી લઈને એનોટેશન, લાઇસન્સિંગ અને વેલિડેશન સુધી - અમે તમને ઝડપથી માર્કેટિંગ કરવામાં મદદ કરીશું, જેના પર તમે વિશ્વાસ કરી શકો તેવા ડેટાનો ઉપયોગ કરીશું.

અમારો સંપર્ક કરો

OCR, અથવા ઓપ્ટિકલ કેરેક્ટર રેકગ્નિશન, એક એવી ટેકનોલોજી છે જે છબીઓ અથવા સ્કેન કરેલા દસ્તાવેજોમાં છાપેલા અથવા હસ્તલિખિત ટેક્સ્ટને મશીન-રીડેબલ ટેક્સ્ટમાં રૂપાંતરિત કરે છે. તે રસીદો, ઇન્વોઇસ અને ફોર્મ્સ જેવા વિવિધ ફોર્મેટમાં પેટર્ન અને અક્ષરોને ઓળખવા માટે લેબલવાળા ડેટાસેટ્સ સાથે AI મોડેલોને તાલીમ આપીને કાર્ય કરે છે.

દસ્તાવેજ પ્રક્રિયા, ડેટા નિષ્કર્ષણ અને ડિજિટાઇઝેશન જેવા કાર્યોને સ્વચાલિત કરવા માટે OCR મહત્વપૂર્ણ છે. તે વ્યવસાયોને સમય બચાવવા, ભૂલો ઘટાડવા અને ભૌતિક અથવા સ્કેન કરેલા દસ્તાવેજોના મોટા જથ્થાને હેન્ડલ કરવામાં કાર્યક્ષમતા સુધારવામાં મદદ કરે છે.

મશીન લર્નિંગ વિવિધ ડેટાસેટ્સ સાથે મોડેલોને તાલીમ આપીને OCR ને વધારે છે, જે તેમને ફોન્ટ્સ, હસ્તલેખન શૈલીઓ, લેઆઉટ અને ભાષાઓમાં વિવિધતાને હેન્ડલ કરવામાં સક્ષમ બનાવે છે. સમય જતાં, મોડેલો ઓળખ દરને સામાન્ય બનાવવા અને સુધારવાનું શીખે છે.

OCR રસીદો, ઇન્વોઇસ, હસ્તલિખિત ફોર્મ, પાસપોર્ટ, મેડિકલ લેબલ્સ, ટિકિટ અને સ્કેન કરેલા PDF અથવા છબીઓમાં જટિલ કોષ્ટકો જેવા દસ્તાવેજોની વિશાળ શ્રેણી પર પ્રક્રિયા કરી શકે છે.

ટેબલ OCR સ્કેન કરેલા દસ્તાવેજો, PDF અથવા છબીઓમાંના કોષ્ટકોમાંથી સ્ટ્રક્ચર્ડ ડેટા કાઢે છે. તે પંક્તિઓ અને કૉલમ્સને એક્સેલ જેવા મશીન-વાંચી શકાય તેવા ફોર્મેટમાં રૂપાંતરિત કરે છે, જે ડેટા પ્રોસેસિંગને ઝડપી અને વધુ સચોટ બનાવે છે.

OCR નો ઉપયોગ આરોગ્યસંભાળ, નાણાં અને ઈકોમર્સ જેવા ઉદ્યોગોમાં વ્યાપકપણે થાય છે. તે તબીબી રેકોર્ડ્સ, ઇન્વોઇસ, રસીદો અને અન્ય દસ્તાવેજોમાંથી ડેટા નિષ્કર્ષણને સ્વચાલિત કરે છે, જેનાથી તમામ ક્ષેત્રોમાં કાર્યક્ષમતામાં સુધારો થાય છે.

બહુભાષી OCR મોડેલોને વિવિધ ભાષાઓ, બોલીઓ અને ફોન્ટ શૈલીઓને આવરી લેતા ડેટાસેટ્સ સાથે તાલીમ આપવામાં આવે છે. આનાથી તેઓ વિવિધ સ્ક્રિપ્ટો અને ટાઇપોગ્રાફીમાં ટેક્સ્ટને સચોટ રીતે ઓળખી અને પ્રક્રિયા કરી શકે છે.

OCR મોડેલ્સને તાલીમ આપવા માટે વિવિધ હસ્તલેખન, ફોન્ટ્સ, લેઆઉટ અને ભાષાઓનું સંચાલન કરવું જરૂરી છે. તબીબી રસીદો અથવા બહુભાષી સામગ્રી જેવા જટિલ દસ્તાવેજોને ઓળખવામાં ચોકસાઈ સુનિશ્ચિત કરવી એ પણ એક મુખ્ય પડકાર છે.

શેપ ઉચ્ચ-ગુણવત્તાવાળા, ક્લાયન્ટ-વિશિષ્ટ OCR ડેટાસેટ્સ પ્રદાન કરે છે, જેમાં રસીદો, ઇન્વોઇસ, હસ્તલિખિત ફોર્મ્સ અને બહુભાષી દસ્તાવેજોનો સમાવેશ થાય છે. આ ડેટાસેટ્સ મહત્તમ ચોકસાઈ અને વિશ્વસનીયતા સુનિશ્ચિત કરવા માટે ક્યુરેટેડ, એનોટેટેડ અને માન્ય કરવામાં આવે છે.

શેપના OCR તાલીમ ઉકેલો ખૂબ જ સ્કેલેબલ છે અને અસાધારણ ચોકસાઈ પ્રદાન કરવા માટે રચાયેલ છે. તેમની પ્રક્રિયા અદ્યતન AI સાધનોને માનવ કુશળતા સાથે જોડે છે, જે મોટા ડેટાસેટ્સ સાથે પણ વિશ્વસનીય પરિણામોની ખાતરી આપે છે.

કિંમત જરૂરી ડેટાસેટના પ્રકાર, વોલ્યુમ અને જટિલતા પર આધાર રાખે છે. કસ્ટમાઇઝ્ડ કિંમત માટે, વ્યવસાયો તેમની ચોક્કસ જરૂરિયાતોની ચર્ચા કરવા માટે સીધા શેપનો સંપર્ક કરી શકે છે.