વોઇસ એઆઈ માટે ઓડિયો એનોટેશન અને સ્પીચ લેબલિંગ સેવાઓ

૧૫૦+ ભાષાઓમાં ઉત્પાદન માટે તૈયાર ઓડિયો ડેટાસેટ્સ — સ્પીચ લેબલિંગ, ટ્રાન્સક્રિપ્શન, સ્પીકર ડાયરાઇઝેશન અને એકોસ્ટિક ઇવેન્ટ ટેગિંગ, નિષ્ણાત એનોટેટર્સ દ્વારા વિતરિત.

ઓડિયો ટીકા

ઑડિયો ઍનોટેશન શું છે?

ઑડિઓ ઍનોટેશન એ ઑડિઓ ફાઇલમાં બોલાતા શબ્દો, ધ્વનિઓ, સ્પીકર્સ, લાગણીઓ અને એકોસ્ટિક ઇવેન્ટ્સને લેબલ કરવાની પ્રક્રિયા છે જેથી મશીન લર્નિંગ મોડેલ્સ - ઓટોમેટિક સ્પીચ રેકગ્નિશન (ASR), વૉઇસ આસિસ્ટન્ટ્સ, કન્વર્ઝેશનલ AI અને જનરેટિવ વૉઇસ AI - વાસ્તવિક દુનિયાના અવાજનું અર્થઘટન કરી શકે. Shaip 150+ ભાષાઓમાં ઑડિઓ ઍનોટેશનને મેનેજ્ડ સેવા તરીકે પહોંચાડે છે, જેમાં પ્રશિક્ષિત ભાષાશાસ્ત્રી ઍનોટેટર્સને AI-સહાયિત ટૂલિંગ અને 6-સિગ્મા ગુણવત્તા માળખા સાથે જોડવામાં આવે છે.

અમારી કુશળતા

કસ્ટમ ઑડિઓ લેબલિંગ / ટીકા હવે દૂરનું સ્વપ્ન નથી.

શરૂઆતથી જ સ્પીચ અને ઑડિઓ લેબલિંગ સેવાઓ શૈપની ખાસિયત રહી છે. અમારા અત્યાધુનિક ઑડિઓ અને સ્પીચ લેબલિંગ સોલ્યુશન્સ સાથે વાતચીત AI, ચેટબોટ્સ અને સ્પીચ રેકગ્નિશન એન્જિન વિકસાવો, તાલીમ આપો અને તેમાં સુધારો કરો. અનુભવી પ્રોજેક્ટ મેનેજમેન્ટ ટીમ સાથે વિશ્વભરના લાયક ભાષાશાસ્ત્રીઓનું અમારું નેટવર્ક કલાકો સુધી બહુભાષી ઑડિઓ એકત્રિત કરી શકે છે અને વૉઇસ-સક્ષમ એપ્લિકેશનોને તાલીમ આપવા માટે મોટા પ્રમાણમાં ડેટાની ટીકા કરી શકે છે. અમે ઑડિઓ ફોર્મેટમાં ઉપલબ્ધ અર્થપૂર્ણ આંતરદૃષ્ટિ કાઢવા માટે ઑડિઓ ફાઇલોનું ટ્રાન્સક્રાઇબ પણ કરીએ છીએ. હવે ઑડિઓ અને સ્પીચ લેબલિંગ તકનીક પસંદ કરો જે તમારા ધ્યેયને શ્રેષ્ઠ રીતે અનુકૂળ હોય અને વિચારમંથન અને તકનીકી બાબતો શૈપ પર છોડી દો.

ઓડિયો ટ્રાન્સક્રિપ્શન

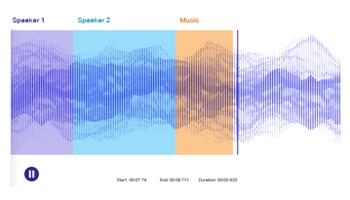
સ્પીચ ટ્રાન્સક્રિપ્શન અને ટાઇમસ્ટેમ્પિંગ

ASR અને STT મોડેલ તાલીમ માટે તૈયાર, સ્પીકર ID અને શબ્દ-સ્તરના ટાઇમસ્ટેમ્પ સાથે વર્બેટિમ, નોન-વર્બેટિમ અને ફોનેટિક ટ્રાન્સક્રિપ્શન. ઉત્પાદન-ગ્રેડ ડેટાસેટ્સ માટે JSON, TextGrid, ELAN, CTM અને કસ્ટમ સ્કીમામાં આઉટપુટ.
સ્પીચ લેબલિંગ

સ્પીચ લેબલિંગ

સ્પીચ અથવા ઑડિઓ લેબલિંગ એ એક પ્રમાણભૂત એનોટેશન તકનીક છે જે અવાજોને અલગ કરવા અને ચોક્કસ મેટાડેટા સાથે લેબલિંગ કરવાની ચિંતા કરે છે. આ તકનીકનો સાર ઑડિઓના ટુકડામાંથી અવાજોની ઓન્ટોલોજીકલ ઓળખ અને તાલીમ ડેટાસેટ્સને વધુ સમાવિષ્ટ બનાવવા માટે તેમને સચોટ રીતે એનોટેટ કરવાનો સમાવેશ થાય છે.
ઑડિઓ વર્ગીકરણ

એકોસ્ટિક ઇવેન્ટ અને સાઉન્ડ વર્ગીકરણ

પર્યાવરણીય ધ્વનિ ઓળખ, દેખરેખ, આગાહી જાળવણી અને ક્લિનિકલ શ્વસન AI માટે નોન-સ્પીચ ઑડિઓ - એલાર્મ, ઉધરસ, ગોળીબાર, મશીન અવાજ, ટ્રાફિક, પગલાં - લેબલ્સ. સિંગલ-લેબલ અથવા મલ્ટિ-લેબલ, ક્લાયંટ સ્કીમા અને ઑડિઓસેટ-સુસંગત નિકાસ સાથે ગોઠવાયેલ કસ્ટમ વર્ગીકરણ સાથે.
બહુભાષી ઓડિયો ડેટા સેવાઓ

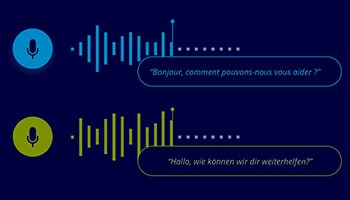
બહુભાષી ઑડિઓ એનોટેશન

૧૫૦+ ભાષાઓ અને બોલીઓમાં મૂળ બોલનારા ટીકાકારો - જેમાં ઓછા સંસાધન અને ભારતીય ભાષાઓનો સમાવેશ થાય છે - કોડ-સ્વિચ્ડ રેકોર્ડિંગ્સ, પ્રાદેશિક ઉચ્ચારો અને સાંસ્કૃતિક રીતે વિશિષ્ટ પરિભાષાનું સંચાલન કરે છે. જ્યાં વૈશ્વિક અવાજ AI ડિપ્લોયમેન્ટને ભાષાકીય કવરેજની જરૂર હોય ત્યાં ઉપયોગી છે જે ફક્ત અંગ્રેજી અથવા સિંગલ-લોકેલ વિક્રેતાઓ ટકાવી શકતા નથી.
કુદરતી ભાષા ઉચ્ચારણ

નેચરલ લેંગ્વેજ ઉચ્ચારણ (NLU) અને ઇન્ટેન્ટ એનોટેશન

બોલી, અર્થપૂર્ણ અને ભાવના સ્તરો સાથે બોલાતી ભાષા પર ઉદ્દેશ્ય, એન્ટિટી અને સ્લોટ ટેગિંગ. ડેટાસેટ ફોર્મેટ ચેટબોટ્સ, IVR સિસ્ટમ્સ, વૉઇસ સહાયકો અને વાસ્તવિક વાતચીતને હેન્ડલ કરવા માટે તાલીમ પામેલા જનરેટિવ વૉઇસ એજન્ટ્સને શક્તિ આપે છે, જેમાં એક જ ઉચ્ચારણમાં બે અથવા વધુ ભાષાઓમાં કોડ-સ્વિચિંગનો સમાવેશ થાય છે.
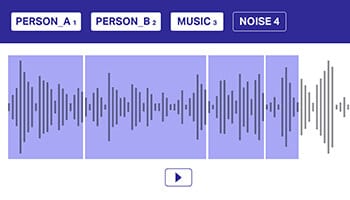
મલ્ટી-લેબલ એનોટેશન

મલ્ટી-લેબલ
ટીકા

મોડેલોને ઓવરલેપ થતા ઓડિયો સ્ત્રોતોને અલગ પાડવામાં મદદ કરવા માટે બહુવિધ લેબલ્સનો આશરો લઈને ઓડિયો ડેટાની ટીકા કરવી મહત્વપૂર્ણ છે. આ અભિગમમાં, ઓડિયો ડેટાસેટ એક અથવા ઘણા વર્ગોનો હોઈ શકે છે, જેને વધુ સારી રીતે નિર્ણય લેવા માટે મોડેલને સ્પષ્ટ રીતે પહોંચાડવાની જરૂર છે.
સ્પીકર ડાયરાઇઝેશન

સ્પીકરની ડાયરાઇઝેશન અને ઓળખ

સીમા શોધ જે લાંબા-સ્વરૂપ રેકોર્ડિંગ્સ - કોલ સેન્ટર વાતચીતો, ક્લિનિકલ સલાહ, મીટિંગ્સ - ને પ્રતિ વક્તા એકરૂપ ભાગોમાં વિભાજીત કરે છે. ઉપયોગના કિસ્સામાં જરૂરી હોય ત્યાં લિંગ, વય-બેન્ડ અને ભાષા ટેગિંગનો સમાવેશ થાય છે, જે મોડેલોને મલ્ટી-સ્પીકર વાતાવરણમાં ભાષણને સચોટ રીતે એટ્રિબ્યુટ કરવામાં મદદ કરે છે.

ફોનેટિક્સ ટ્રાન્સક્રિપ્શન

ધ્વન્યાત્મક ટ્રાન્સક્રિપ્શન

નિયમિત ટ્રાન્સક્રિપ્શનથી વિપરીત જે ઑડિઓને શબ્દોના ક્રમમાં રૂપાંતરિત કરે છે, ધ્વન્યાત્મક ટ્રાન્સક્રિપ્શન નોંધે છે કે શબ્દો કેવી રીતે ઉચ્ચારવામાં આવે છે અને ધ્વન્યાત્મક પ્રતીકોનો ઉપયોગ કરીને અવાજોને દૃષ્ટિની રીતે રજૂ કરે છે. ધ્વન્યાત્મક ટ્રાન્સક્રિપ્શન ઘણી બોલીઓમાં એક જ ભાષાના ઉચ્ચારણમાં તફાવતને નોંધવાનું સરળ બનાવે છે.

જનરેટિવ અને મલ્ટિમોડલ AI માટે ઓડિયો એનોટેશન

જનરેટિવ વોઇસ AI માટે સ્પેશિયાલિસ્ટ લેબલિંગ, ઓડિયો આઉટપુટ માટે RLHF, ટેક્સ્ટ અથવા વિડિયો સાથે સ્પીચને જોડતો મલ્ટિમોડલ ટ્રેનિંગ ડેટા અને TTS ડેટાસેટ તૈયારી. વાતચીત અને વોઇસ-ક્લોનિંગ મોડેલ્સને ફાઇન-ટ્યુન કરવા માટે પ્રોમ્પ્ટ-રિસ્પોન્સ ઓડિયો જોડીઓ, પસંદગી રેન્કિંગ અને સ્ટાઇલ/ટોન લેબલ્સનો સમાવેશ થાય છે.
ઑડિઓ વર્ગીકરણના પ્રકારો

ધ્વનિશાસ્ત્ર ડેટા વર્ગીકરણ

અવાજોને રેકોર્ડિંગ વાતાવરણ - શાળાઓ, ઘરો, કાફે, જાહેર પરિવહન, વાહનો - દ્વારા વર્ગીકૃત કરવામાં આવે છે જેથી વાણી ઓળખ, વર્ચ્યુઅલ સહાયકો, ઑડિઓ લાઇબ્રેરીઓ અને સર્વેલન્સ સિસ્ટમ્સને તાલીમ આપી શકાય જેને ફક્ત શબ્દો જ નહીં, પણ સંદર્ભને ઓળખવાની જરૂર હોય.

સંગીત સિવાયના, ભાષણ સિવાયના અવાજો જેવા કાર્યક્રમો - હોર્ન, સાયરન, ગોળીબાર, કાચ તોડવો, બાળકો રમતા, મશીનરી - ને સુરક્ષા AI, આગાહી જાળવણી અને સ્માર્ટ-સિટી ડિપ્લોયમેન્ટ માટે લેબલ કરવામાં આવે છે જ્યાં પેટર્ન-આધારિત વર્ગીકરણ લાગુ પડતું નથી.

 સંગીત લાઇબ્રેરીઓ, ભલામણ સિસ્ટમ્સ, કૉપિરાઇટ શોધ અને સામગ્રી મોડરેશન માટે શૈલી, વાદ્ય, મૂડ, ટેમ્પો અને એન્સેમ્બલ લેબલ્સ. શૈલીઓ અથવા મૂડને આવરી લેતા ટ્રેક માટે મલ્ટિ-લેબલ ટેગિંગ શામેલ છે.

ઉદ્દેશ્ય અને અર્થ ઉચ્ચારણ સ્તરે - બોલી, અર્થશાસ્ત્ર, તાણ, સ્વર - મેળવવા માટે પાવર ચેટબોટ્સ, વૉઇસ સહાયકો અને વાતચીત AI દ્વારા કાઢવામાં આવે છે જે ફક્ત શું કહેવામાં આવે છે તેના પર નહીં, પણ કંઈક કેવી રીતે કહેવામાં આવે છે તેના પર પ્રતિક્રિયા આપે છે.

માનવ બુદ્ધિ દ્વારા સંચાલિત સ્પીચ અને ઑડિઓ એનોટેશન ટૂલ

લાંબા સમય સુધી ડેટા એકત્રિત કરવા છતાં, મશીન લર્નિંગ મોડેલો પાસેથી સંદર્ભ અને સુસંગતતા જાતે જ સમજવાની અપેક્ષા રાખવામાં આવતી નથી. જો સ્વ-શિક્ષણ NLP મોડેલો તૈનાત કરવામાં આવે તો પણ, તાલીમના પ્રારંભિક તબક્કા અથવા તેના બદલે દેખરેખ હેઠળના શિક્ષણ માટે તેમને મેટાડેટા-સ્તરવાળા ઑડિઓ સંસાધનો સાથે ફીડ કરવાની જરૂર પડશે.

આ તે જગ્યા છે જ્યાં શેપ સ્ટાન્ડર્ડ ઉપયોગના કિસ્સાઓ મુજબ, AI અને ML સેટઅપ્સને તાલીમ આપવા માટે અત્યાધુનિક ડેટાસેટ્સ ઉપલબ્ધ કરાવીને ભૂમિકા ભજવે છે. અમારા વ્યાવસાયિક કાર્યબળ અને નિષ્ણાત ટીકાકારોની ટીમ હંમેશા સંબંધિત ભંડારોમાં સ્પીચ ડેટાને લેબલ અને વર્ગીકૃત કરવા માટે કાર્યરત છે.

ભાષણ ટીકા
  • ગ્રેન્યુલર ઓડિયો ડેટા સાથે કુદરતી ભાષા પ્રક્રિયા સેટઅપ્સને સમૃદ્ધ બનાવો
  • રૂબરૂ અને દૂરસ્થ એનોટેશન સુવિધાઓનો અનુભવ કરો
  • મલ્ટિ-લેબલ એનોટેશન, હેન્ડ્સ-ઓન જેવી શ્રેષ્ઠ અવાજ દૂર કરવાની તકનીકોનું અન્વેષણ કરો

શેપને તમારા વિશ્વસનીય ઓડિયો એનોટેશન પાર્ટનર તરીકે પસંદ કરવાના કારણો

લોકો

લોકો

સમર્પિત અને પ્રશિક્ષિત ટીમો:

  • ડેટા ક્રિએશન, લેબલિંગ અને QA માટે 30,000+ સહયોગીઓ
  • પ્રમાણિત પ્રોજેક્ટ મેનેજમેન્ટ ટીમ
  • અનુભવી ઉત્પાદન વિકાસ ટીમ
  • ટેલેન્ટ પૂલ સોર્સિંગ અને ઓનબોર્ડિંગ ટીમ

પ્રક્રિયા

પ્રક્રિયા

ઉચ્ચતમ પ્રક્રિયા કાર્યક્ષમતા આના દ્વારા સુનિશ્ચિત થાય છે:

  • મજબૂત 6 સિગ્મા સ્ટેજ-ગેટ પ્રક્રિયા
  • 6 સિગ્મા બ્લેક બેલ્ટની સમર્પિત ટીમ - મુખ્ય પ્રક્રિયા માલિકો અને ગુણવત્તા પાલન
  • સતત સુધારણા અને પ્રતિસાદ લૂપ

પ્લેટફોર્મ

પ્લેટફોર્મ

પેટન્ટ કરાયેલ પ્લેટફોર્મ નીચેના ફાયદાઓ પ્રદાન કરે છે:

  • વેબ-આધારિત એન્ડ-ટુ-એન્ડ પ્લેટફોર્મ
  • દોષરહિત ગુણવત્તા
  • ઝડપી TAT
  • સીમલેસ ડિલિવરી

તમારે ઓડિયો ડેટા લેબલિંગ / એનોટેશન શા માટે આઉટસોર્સ કરવું જોઈએ

સમર્પિત ટીમ

એવો અંદાજ છે કે ડેટા વૈજ્ઞાનિકો તેમનો 80% થી વધુ સમય ડેટા ક્લિનિંગ અને ડેટા તૈયારીમાં વિતાવે છે. આઉટસોર્સિંગ સાથે, તમારી ડેટા વૈજ્ઞાનિકોની ટીમ મજબૂત અલ્ગોરિધમના વિકાસને ચાલુ રાખવા પર ધ્યાન કેન્દ્રિત કરી શકે છે અને કામનો કંટાળાજનક ભાગ અમારા પર છોડી દે છે.

સારી ગુણવત્તા

સમર્પિત ડોમેન નિષ્ણાતો, જેઓ દિવસ-દર-દિવસની ટીકા કરે છે, તેઓ - કોઈપણ દિવસે - એવી ટીમની તુલનામાં શ્રેષ્ઠ કાર્ય કરશે, જેને તેમના વ્યસ્ત સમયપત્રકમાં ટીકા કાર્યોને સમાયોજિત કરવાની જરૂર હોય છે. કહેવાની જરૂર નથી કે તે વધુ સારું આઉટપુટ આપે છે.

માપનીયતા

સરેરાશ મશીન લર્નિંગ (ML) મોડેલ માટે પણ ડેટાના મોટા હિસ્સાને લેબલ કરવાની જરૂર પડશે, જેના માટે કંપનીઓને અન્ય ટીમો પાસેથી સંસાધનો મેળવવાની જરૂર પડશે. અમારા જેવા ડેટા એનોટેશન કન્સલ્ટન્ટ્સ સાથે, અમે ડોમેન નિષ્ણાતો પ્રદાન કરીએ છીએ જે તમારા પ્રોજેક્ટ્સ પર સમર્પિતપણે કામ કરે છે અને તમારા વ્યવસાયના વિકાસ સાથે કામગીરીને સરળતાથી વધારી શકે છે.

આંતરિક પક્ષપાત દૂર કરો

AI મોડેલો નિષ્ફળ જવાનું કારણ એ છે કે ડેટા સંગ્રહ અને ટીકા પર કામ કરતી ટીમો અજાણતાં પૂર્વગ્રહ રજૂ કરે છે, અંતિમ પરિણામને વિકૃત કરે છે અને ચોકસાઈને અસર કરે છે. જો કે, ડેટા એનોટેશન વિક્રેતા ધારણાઓ અને પૂર્વગ્રહને દૂર કરીને સુધારેલી ચોકસાઈ માટે ડેટાની ટીકા કરવાનું વધુ સારું કામ કરે છે.

સેવાઓ આપવામાં આવે છે

વ્યાપક AI સેટઅપ્સ માટે નિષ્ણાત છબી ડેટા સંગ્રહ ફક્ત હાથ પર જ ઉપલબ્ધ નથી. Shaip ખાતે, તમે મોડેલ્સને સામાન્ય કરતાં વધુ વ્યાપક બનાવવા માટે નીચેની સેવાઓનો પણ વિચાર કરી શકો છો:

ટેક્સ્ટ એનોટેશન

ટેક્સ્ટ એનોટેશન સેવાઓ

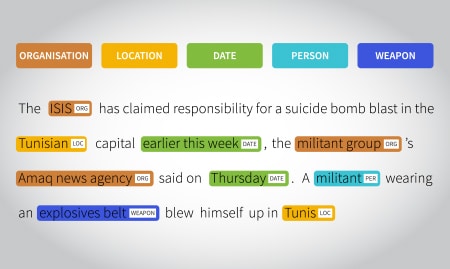
અમે એન્ટિટી એનોટેશન, ટેક્સ્ટ વર્ગીકરણ, સેન્ટિમેન્ટ એનોટેશન અને અન્ય સંબંધિત સાધનોનો ઉપયોગ કરીને સંપૂર્ણ ડેટાસેટ્સ એનોટેટ કરીને ટેક્સ્ટ્યુઅલ ડેટા તાલીમ તૈયાર કરવામાં નિષ્ણાત છીએ.
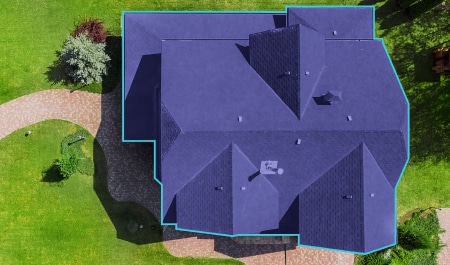
છબી ટીકા

છબી એનોટેશન સેવાઓ

અમને લેબલિંગ, સેગ્મેન્ટેડ ઇમેજ ડેટાસેટ્સ, કોમ્પ્યુટર વિઝન મોડેલ્સને તાલીમ આપવા માટે ગર્વ છે. કેટલીક સંબંધિત તકનીકોમાં સીમા ઓળખ અને છબી વર્ગીકરણનો સમાવેશ થાય છે.
વિડિઓ ટીકા

વિડિઓ એનોટેશન સેવાઓ

શેપ કમ્પ્યુટર વિઝન મોડેલ્સને તાલીમ આપવા માટે ઉચ્ચ કક્ષાની વિડિઓ લેબલિંગ સેવાઓ પ્રદાન કરે છે.
અહીંનો ઉદ્દેશ્ય પેટર્ન ઓળખ, ઑબ્જેક્ટ શોધ અને વધુ જેવા સાધનોનો ઉપયોગ કરીને ડેટાસેટ્સને ઉપયોગી બનાવવાનો છે.
ફીચર્ડ ક્લાયન્ટ્સ

વિશ્વ-અગ્રણી AI ઉત્પાદનો બનાવવા માટે ટીમોને સશક્ત બનાવવી.

ઓડિયો એનોટેશન નિષ્ણાતોને ઓન-બોર્ડ મેળવો.

હવે બુદ્ધિશાળી AI માટે સારી રીતે સંશોધિત, દાણાદાર, વિભાજિત અને મલ્ટી-લેબલવાળા ઓડિયો ડેટાસેટ્સ તૈયાર કરો.

ઑડિઓ ઍનોટેશન એ ઑડિઓ ફાઇલમાં બોલાતા શબ્દો, ધ્વનિઓ, સ્પીકર્સ, લાગણીઓ અને એકોસ્ટિક ઇવેન્ટ્સને લેબલ કરવાની પ્રક્રિયા છે જેથી મશીન લર્નિંગ મોડેલો વાસ્તવિક દુનિયાના અવાજનું અર્થઘટન કરી શકે. ટ્રાન્સક્રિપ્શન ફક્ત વાણીને ટેક્સ્ટમાં રૂપાંતરિત કરે છે — ઍનોટેશન કોણ બોલી રહ્યું છે, તેઓ કઈ ભાષાનો ઉપયોગ કરી રહ્યા છે, કઈ લાગણીઓ અથવા પૃષ્ઠભૂમિ અવાજો હાજર છે અને ઑડિઓમાં દરેક ઘટના ક્યાં બને છે તે ટેગ કરીને આગળ વધે છે. વૉઇસ સહાયકો, ASR સિસ્ટમ્સ અને વાતચીત AI બધાને ફક્ત ટ્રાન્સક્રિપ્ટેડ જ નહીં, પણ ટીકાની જરૂર છે.
શેપ ટાઇમસ્ટેમ્પિંગ, સ્પીકર ડાયરાઇઝેશન અને ઓળખ, એકોસ્ટિક ઇવેન્ટ અને સાઉન્ડ વર્ગીકરણ, નેચરલ લેંગ્વેજ ઉચ્ચારણ (NLU) અને ઇન્ટેન્ટ એનોટેશન, ફોનેટિક ટ્રાન્સક્રિપ્શન, ઓવરલેપિંગ ઓડિયો સ્ત્રોતો માટે મલ્ટિ-લેબલ એનોટેશન, 150+ ભાષાઓમાં બહુભાષી ઓડિયો એનોટેશન અને RLHF પ્રેફરન્સ રેન્કિંગ અને TTS ડેટાસેટ તૈયારી સહિત જનરેટિવ વોઇસ AI માટે નિષ્ણાત લેબલિંગ સાથે સ્પીચ ટ્રાન્સક્રિપ્શન પ્રદાન કરે છે. વૈકલ્પિક સમર્પિત ટીમો સાથે એનોટેશન એક સંચાલિત સેવા તરીકે વિતરિત કરવામાં આવે છે.
 
શેપ હેલ્થકેર અને ક્લિનિકલ વોઇસ AI (શ્વસન ઘટના શોધ અને ફિઝિશિયન ડિક્ટેશન સહિત), વાતચીત AI અને વોઇસ સહાયકો, બહુભાષી અને ઘોંઘાટીયા વાતાવરણ માટે ASR/STT, કોલ-સેન્ટર એનાલિટિક્સ, ઓટોમોટિવ ઇન-કેબિન વોઇસ અને TTS અને વોઇસ ક્લોનિંગ સહિત જનરેટિવ વોઇસ AI માટે ઓડિયો એનોટેશનને સપોર્ટ કરે છે. દરેક વર્ટિકલ ડોમેન-અનુભવી એનોટેટર્સ અને, જ્યાં જરૂરી હોય, ક્લિનિકલ વર્કલોડ માટે HIPAA જેવા નામ-ફ્રેમવર્ક પાલન દ્વારા સપોર્ટેડ છે.
 
Shaip ખાતે ઓડિયો એનોટેશન 6-સિગ્મા સ્ટેજ-ગેટ ગુણવત્તા માળખા હેઠળ ચાલે છે જેમાં બહુ-સ્તરીય સમીક્ષા છે: એનોટેટર સ્વ-તપાસ, પીઅર સમીક્ષા, નિષ્ણાત ઓડિટ અને આંકડાકીય નમૂના. ઇન્ટર-એનોટેટર કરાર માપવામાં આવે છે અને સામાન્ય રીતે કાર્ય જટિલતાના આધારે 95%+ પર રાખવામાં આવે છે. દરેક ભાષા માટે મૂળ-વક્તા એનોટેટર્સનો ઉપયોગ કરવામાં આવે છે, AI-સહાયિત પ્રી-એનોટેશન ભિન્નતા ઘટાડે છે, અને 6-સિગ્મા બ્લેક બેલ્ટની સમર્પિત ટીમ પ્રક્રિયા પાલન અને સતત સુધારણા લૂપ્સ ધરાવે છે.
 
શેપનું એનોટેટર નેટવર્ક 150+ ભાષાઓ અને બોલીઓને આવરી લે છે, જેમાં બધી મુખ્ય યુરોપિયન, પૂર્વ એશિયન અને મધ્ય પૂર્વીય ભાષાઓ, ભારતીય ભાષાઓ, આફ્રિકન ભાષાઓ અને ઘણી ઓછી સંસાધન ભાષાઓનો સમાવેશ થાય છે. કોડ-સ્વિચ્ડ રેકોર્ડિંગ્સ - જ્યાં એક જ ઉચ્ચારણમાં બે ભાષાઓ વૈકલ્પિક રીતે બોલાય છે - બહુભાષી એનોટેટર્સ દ્વારા નિયંત્રિત કરવામાં આવે છે, જે દ્વિભાષી અથવા બહુભાષી વપરાશકર્તાઓને સેવા આપતા વૈશ્વિક અવાજ AI ડિપ્લોયમેન્ટ માટે મહત્વપૂર્ણ છે.
 
હા. ઓડિયો એનોટેશન વર્કફ્લો ISO 27001-પ્રમાણિત માહિતી-સુરક્ષા વ્યવસ્થાપન સિસ્ટમ હેઠળ ચાલે છે, PHI રીડેક્શન સહિત સુરક્ષિત આરોગ્ય માહિતી માટે HIPAA-તૈયાર છે, અને EU-નિવાસી ડેટા વિષયો માટે GDPR-અનુરૂપ છે. ઍક્સેસ નિયંત્રણો અને ઓડિટ લોગ SOC 2-સંરેખિત છે, અને NDA-બાઉન્ડ સમર્પિત એનોટેટર ટીમો અથવા ઓન-પ્રિમિસીસ એનોટેશન સૌથી સંવેદનશીલ ડેટાસેટ્સ માટે ગોઠવી શકાય છે.
જનરેટિવ વૉઇસ AI અને મોટા વૉઇસ મોડેલ્સને સ્ટાન્ડર્ડ ટ્રાન્સક્રિપ્શન ઉપરાંત ડેટાની જરૂર હોય છે. Shaip પ્રોમ્પ્ટ-રિસ્પોન્સ ઑડિઓ જોડીઓ, વૉઇસ આઉટપુટ પર RLHF પ્રેફરન્સ રેન્કિંગ, વૉઇસ ક્લોનિંગ માટે મલ્ટિ-સ્પીકર લેબલવાળા કૉર્પોરા, વૉઇસ-સ્ટાઇલ અને ઇમોશન ટેગિંગ અને TTS ડેટાસેટ તૈયારી પ્રદાન કરે છે. આઉટપુટ સામાન્ય ફાઇન-ટ્યુનિંગ પાઇપલાઇન્સ સાથે સુસંગત ફોર્મેટમાં વિતરિત કરવામાં આવે છે, જેમાં મોડેલ બાયસ ઘટાડવા માટે સ્પીકર્સમાં ભાષાકીય અને સાંસ્કૃતિક વિવિધતા નિયંત્રિત થાય છે.
 
હા. શેપની એનોટેશન પાઇપલાઇન પૃષ્ઠભૂમિ-અવાજ ઓવરલે, કોડ-સ્વિચિંગ, ફીલ્ડ-રેકોર્ડિંગ પરિસ્થિતિઓ અને ડોમેન-વિશિષ્ટ પરિભાષા - તબીબી, કાનૂની, નાણાકીય, ઓટોમોટિવ અને ઔદ્યોગિકને સમાવે છે. એકોસ્ટિક ઇવેન્ટ વર્ગીકરણ ક્લાયન્ટના ઉપયોગના કેસ અનુસાર બનાવી શકાય છે, ક્લિનિકલ શ્વસન ઘટનાઓ (ખાંસી, ઘરઘરાટી) થી ઔદ્યોગિક અવાજો (એલાર્મ, મશીનરી) થી સુરક્ષા-સંબંધિત ઘટનાઓ (ગોળીઓ, કાચ તૂટવા), કસ્ટમ અથવા ઑડિઓસેટ-સુસંગત નિકાસ સાથે.
 

તે લેબલ થયેલ ડેટા પૂરો પાડે છે જે સિસ્ટમોને શબ્દો, ઉચ્ચારો અને ઉદ્દેશ્ય ઓળખવામાં મદદ કરે છે, ટ્રાન્સક્રિપ્શન અને સમજણમાં સુધારો કરે છે.

પડકારોમાં ઉચ્ચારો અને બોલીઓનું સંચાલન શામેલ છે. શૈપ વૈશ્વિક ભાષાશાસ્ત્રીઓ અને સ્કેલેબલ પ્રક્રિયાઓ સાથે આનું સંચાલન કરે છે.