ચેટબોટ્સથી રોબોટ્સ તરફનું પરિવર્તન જે કુદરતી-ભાષાના આદેશોનું પાલન કરે છે તે મોડેલોના એક જ વર્ગ દ્વારા થાય છે. VLA મોડેલ્સ - દ્રષ્ટિ-ભાષા-ક્રિયા મોડેલ્સ - એક ન્યુરલ નેટવર્કમાં દ્રશ્ય દ્રષ્ટિ, ભાષા સમજણ અને ક્રિયા ઉત્પાદનને જોડે છે. તેમની શક્તિ વાસ્તવિક છે, પરંતુ તે લગભગ સંપૂર્ણપણે તેઓ જે તાલીમ ડેટા ગ્રહણ કરે છે તેના પર આધાર રાખે છે. આ માર્ગદર્શિકા સમજાવે છે કે VLA તાલીમ ડેટામાં ખરેખર શું શામેલ છે, ટીમો શું ઓછો અંદાજ આપે છે, અને ડેટાસેટ કેવી રીતે બનાવવો જે જમાવટ કરવા યોગ્ય મોડેલ ઉત્પન્ન કરે છે. તે ડેટાસેટ બનાવવું એ બરાબર તે જ છે જે શેપના ભૌતિક AI તાલીમ ડેટા પ્રોગ્રામ્સ પ્રદાન કરે છે - વાસ્તવિક દુનિયાના રોબોટિક્સ માટે સિંક્રનાઇઝ્ડ દ્રષ્ટિ, ભાષા અને ક્રિયા ડેટા કેપ્ચર કરવામાં આવે છે.
કી ટેકવેઝ
- VLA મોડેલો એક નેટવર્કમાં રોબોટ ક્રિયાઓ માટે સીધા દ્રષ્ટિ અને ભાષાના ઇનપુટ્સનું મેપિંગ કરે છે.
- તાલીમ ડેટામાં સમન્વયિત દ્રશ્ય અવલોકનો, ભાષા સૂચનાઓ અને ક્રિયાઓ શામેલ હોવા જોઈએ.
- ડિસ્ક્રીટ એક્શન ટોકન્સને સારી રીતે શીખવા માટે મોટા પાયે પ્રદર્શન ડેટાની જરૂર પડે છે.
- ઓછા ખર્ચે VLA પ્રીટ્રેનિંગ સ્ત્રોત તરીકે અહંકાર કેન્દ્રિત માનવ વિડિઓનું વધુને વધુ ખાણકામ કરવામાં આવી રહ્યું છે.
- વિશ્વસનીય જમાવટ માટે તાલીમ ડેટા જેટલા જ મજબૂત મૂલ્યાંકન એપિસોડ મહત્વપૂર્ણ છે.
- VLA ફાઇન-ટ્યુનિંગ ફક્ત કાચા વોલ્યુમ પર નહીં, પરંતુ એનોટેશનની સખતાઈ પર સફળ થાય છે કે નિષ્ફળ જાય છે.
VLA મોડેલ શું છે?
VLA મોડેલ એ રોબોટિક ફાઉન્ડેશન મોડેલ છે જે છબીઓ અને કુદરતી-ભાષાની સૂચનાઓને ઇનપુટ તરીકે લે છે અને રોબોટ ક્રિયાઓને આઉટપુટ કરે છે. પરંપરાગત પાઇપલાઇન્સથી વિપરીત જે દ્રષ્ટિ, આયોજન અને નિયંત્રણને વિવિધ મોડ્યુલોમાં અલગ કરે છે, વિઝન-ભાષા-ક્રિયા મોડેલ્સ એક જ નેટવર્કમાં એન્ડ-ટુ-એન્ડ મેપિંગ શીખે છે.

VLA મોડેલ: એક ન્યુરલ નેટવર્ક જે સિંક્રનાઇઝ્ડ દ્રશ્ય અવલોકનો અને કુદરતી-ભાષા સૂચનાઓ લે છે અને રોબોટ ક્રિયાઓ અથવા ક્રિયા ટોકન્સના ક્રમ ઉત્પન્ન કરે છે.
આ એકીકૃત ડિઝાઇન VLA મોડેલોને મોટા વિઝન-લેંગ્વેજ પ્રીટ્રેનિંગમાંથી તર્ક ક્ષમતાઓ વારસામાં મેળવવા અને મોટર નિયંત્રણ સાથે તેમને વિસ્તૃત કરવા દે છે. ડિપ્લોયમેન્ટ માટે, તેનો અર્થ એ છે કે એક મોડેલ સૈદ્ધાંતિક રીતે ઘણા કાર્યો કરી શકે છે - પરંતુ માત્ર ત્યારે જ જો તેનો તાલીમ ડેટા તેમને યોગ્ય માળખા સાથે આવરી લે.
VLA તાલીમ ડેટામાં ખરેખર શું સમાયેલું છે?
VLA તાલીમ ડેટામાં દરેક એપિસોડમાં ચાર મુખ્ય ઘટકો હોય છે: દ્રશ્ય અવલોકનો, કુદરતી-ભાષા સૂચના, ક્રિયા માર્ગ અને સફળતા કે નિષ્ફળતાનું લેબલ. આની આસપાસ, ટીમો ટાઇમસ્ટેમ્પ, પ્રોપ્રિઓસેપ્ટિવ સ્થિતિ અને મૂલ્યાંકન માર્કર્સ ઉમેરે છે.

ચાર ફરજિયાત સ્તરો:
- દ્રશ્ય અવલોકનો - RGB ફ્રેમ્સ, ઘણીવાર ડેપ્થ અથવા રિસ્ટ-કેમ વ્યૂ સાથે જોડી બનાવવામાં આવે છે.
- ભાષા સૂચનાઓ — "કપમાં પાણી રેડવું" જેવા સંક્ષિપ્ત કુદરતી ભાષાના આદેશો.
- ક્રિયા માર્ગો — રોબોટની સ્વતંત્રતાની ડિગ્રી સાથે મેપ કરેલા વિવેકિત અથવા સતત ક્રિયા ક્રમ.
- પરિણામ લેબલ્સ — એપિસોડ દીઠ સ્પષ્ટ સફળતા, નિષ્ફળતા, અથવા આંશિક-પૂર્ણતા માર્કર્સ.
22 રોબોટ અવતાર (સ્ટેનફોર્ડ એટ અલ., 2024) માંથી લેવામાં આવેલા દસ લાખથી વધુ એપિસોડ પર 7-બિલિયન-પેરામીટર ઓપન VLA મોડેલને તાલીમ આપવામાં આવી હતી, જે ક્રોસ-ટાસ્ક જનરલાઇઝેશન માટે અપેક્ષિત વિવિધતા દર્શાવે છે. આ પહોળાઈ વિના, VLA મોડેલો સામાન્યીકરણ કરવાને બદલે ચોક્કસ વસ્તુઓને યાદ રાખવાનું વલણ ધરાવે છે.
છબી એનોટેશન કરતાં ક્રિયા એનોટેશન શા માટે મુશ્કેલ છે?
ક્રિયા ટીકા વધુ મુશ્કેલ છે કારણ કે ક્રિયાઓ સતત, ઉચ્ચ-પરિમાણીય જગ્યાઓમાં રહે છે અને રોબોટ અવતાર પર આધાર રાખે છે, ફક્ત ફ્રેમ સામગ્રી પર નહીં. કપ પર બાઉન્ડિંગ બોક્સને લેબલ કરવું સરળ છે; ચોક્કસ સંપર્ક બિંદુ પર ચોક્કસ ગ્રિપર સાથે તે કપને સફળતાપૂર્વક પકડે છે તે માર્ગને લેબલ કરવું મુશ્કેલ નથી.
એક્શન ટોકન: રોબોટ ગતિ અથવા એન્ડ-ઇફેક્ટર ડિસ્પ્લેસમેન્ટનું એક અલગ પ્રતિનિધિત્વ જે VLA મોડેલ ભાષા ટોકનની જેમ આગાહી કરી શકે છે.
એનોટેશન ટીમોએ દરેક ક્રિયા ટોકનને તેના સિંક્રનાઇઝ્ડ અવલોકન સાથે ગોઠવવાની, સંપર્ક ઇન્સ્ટન્ટ્સને ચિહ્નિત કરવાની, નિષ્ફળતા પુનઃપ્રાપ્તિને કેપ્ચર કરવાની અને ભાષા સૂચનાની અણુ સીમાઓને ટેગ કરવાની જરૂર છે. શેપના ડેટા એનોટેશન વર્કફ્લો આને સ્કેલ પર હેન્ડલ કરે છે, જેમાં સ્ટ્રક્ચર્ડ ટેક્સોનોમી રોબોટિક એક્શન સ્પેસ અને પ્રતિ-કાર્ય સ્વીકૃતિ થ્રેશોલ્ડ સાથે ટ્યુન કરવામાં આવે છે.
VLA તાલીમમાં અહંકારી માનવ વિડિઓ ક્યાં બંધબેસે છે?

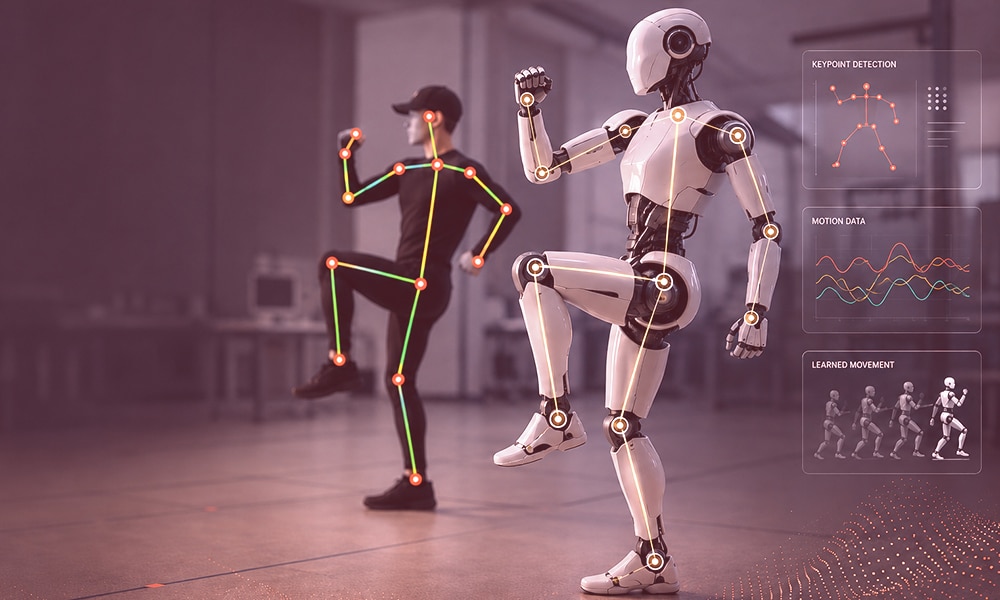
તાજેતરના એક પેપરમાં માનવ હાથને એક કુશળ એન્ડ-ઇફેક્ટર તરીકે ગણીને, અસંગઠિત અહંકારકેન્દ્રિત માનવ વિડિઓઝને VLA-ફોર્મેટેડ એપિસોડમાં રૂપાંતરિત કરવામાં આવ્યા છે - 1 મિલિયન સેગમેન્ટ્સ અને 26 મિલિયન ફ્રેમ્સ - (વુ એટ અલ., arXiv, 2025). VLA પ્રીટ્રેનિંગ રેસિપીમાં આ પ્રકારનો ક્રોસ-એમ્બોડિમેન્ટ ડેટા હવે નિયમિત છે.
મુખ્ય વાત: કાચો વિડીયો તાલીમ ડેટા નથી. VLA પાઇપલાઇન સુધી પહોંચે તે પહેલાં તેને સેગ્મેન્ટેશન, ભાષા વર્ણન, હેન્ડ-પોઝ રીટાર્ગેટિંગ અને ગુણવત્તા માન્યતાની જરૂર છે. શેપના ભૌતિક AI ડેટા ઓપ્સમાં એક જ ડિલિવરીમાં અહંકાર કેન્દ્રિત કેપ્ચર, રીઅલ2સિમ કન્વર્ઝન અને VLA-સંરેખિત એનોટેશનનો સમાવેશ થાય છે.
[આ પણ વાંચો: અમારી સ્વાર્થી વિડિઓ ડેટા સંગ્રહ સેવાઓનું અન્વેષણ કરો ]
VLA નિષ્ફળતા મોડ્સને પકડતા મૂલ્યાંકન સેટ કેવી રીતે બનાવશો?
મૂલ્યાંકન સેટ VLA નિષ્ફળતા મોડ્સને પકડે છે જ્યારે તેઓ તાલીમ પહેલાં ડિઝાઇન કરવામાં આવે છે, પછી નહીં. ત્રણ માળખાં સૌથી વધુ મહત્વપૂર્ણ છે: વિતરણમાં સફળતાના બેન્ચમાર્ક, વિતરણની બહાર સામાન્યીકરણ ચકાસણીઓ, અને જોખમ-સ્તરીય સલામતી દૃશ્યો.
કલ્પના કરો કે એક ઘરગથ્થુ VLA મોડેલ રસોડાના કાર્યો પર વ્યાપકપણે તાલીમ પામેલ છે. એક વાજબી મૂલ્યાંકન સમૂહ પરીક્ષણ કરશે: જાણીતા રસોડામાં જાણીતા કાર્યો (વિતરણમાં), અજાણ્યા પ્રકાશમાં જાણીતા કાર્યો (હળવા OOD), જાણીતા સૂચનો સાથે અજાણી વસ્તુઓ (વિભાવના સામાન્યીકરણ), અને આકસ્મિક સ્પીલ (સુરક્ષા સ્તર) જેવી દુર્લભ ઘટનાઓ. દરેક વિના, ડિપ્લોયમેન્ટ જોખમ માપી શકાયું નથી.
જોખમ-સ્તરીય કવરેજનું આયોજન કરવા માટે એક ઉપયોગી તટસ્થ સંસાધન NIST AI રિસ્ક મેનેજમેન્ટ ફ્રેમવર્ક છે , જે અસર સ્તરોને એવી રીતે અલગ કરે છે કે જે મૂલ્યાંકન સેટ ડિઝાઇન પર સ્વચ્છ રીતે નકશા બનાવે છે.