દરેક ML એન્જિનિયર એક વિશ્વસનીય અને સચોટ AI મોડેલ વિકસાવવા માંગે છે. ડેટા વૈજ્ઞાનિકો તેમનો લગભગ 80% સમય ડેટાને લેબલ કરવામાં અને વધારવામાં વિતાવે છે. એટલા માટે મોડેલનું પ્રદર્શન તેને તાલીમ આપવા માટે ઉપયોગમાં લેવાતા ડેટાની ગુણવત્તા પર આધાર રાખે છે.
અમે વ્યવસાયોની વિવિધ AI પ્રોજેક્ટ જરૂરિયાતો પૂરી કરી રહ્યા છીએ, તેથી અમને કેટલાક પ્રશ્નો મળે છે જે અમારા વ્યવસાયિક ગ્રાહકો વારંવાર પૂછે છે અથવા સ્પષ્ટતાની જરૂર હોય છે. તેથી અમે ML મોડેલોને સચોટ રીતે તાલીમ આપવા માટે અમારી નિષ્ણાત ટીમ ગોલ્ડ-સ્ટાન્ડર્ડ તાલીમ ડેટા કેવી રીતે વિકસાવે છે તે માટે તૈયાર સંદર્ભ પ્રદાન કરવાનું નક્કી કર્યું.
FAQs પર નેવિગેટ કરતા પહેલા, ચાલો ડેટા લેબલિંગ અને તેના મહત્વની કેટલીક મૂળભૂત બાબતો જણાવીએ.
ડેટા લેબલીંગ શું છે?
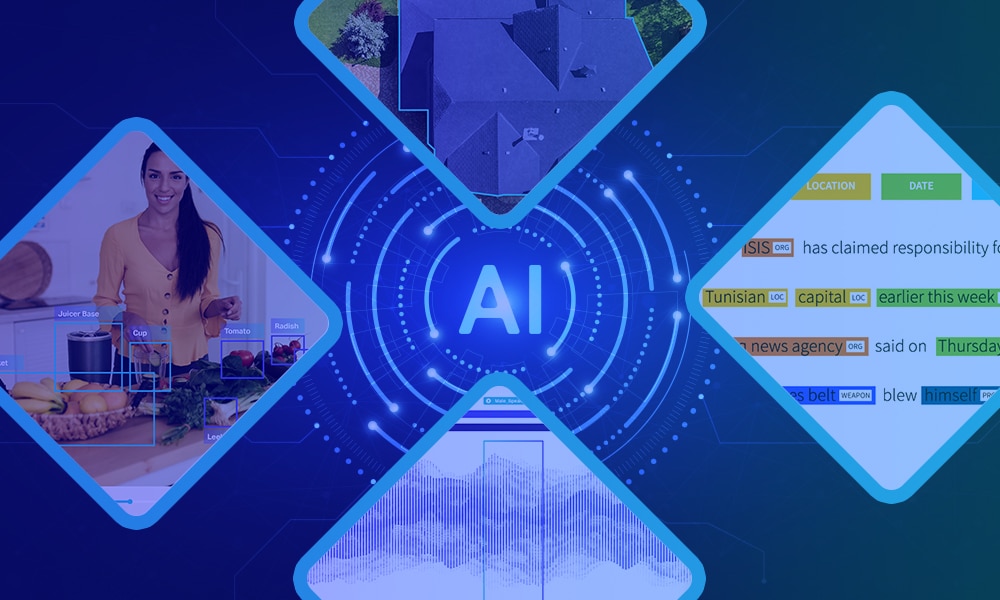
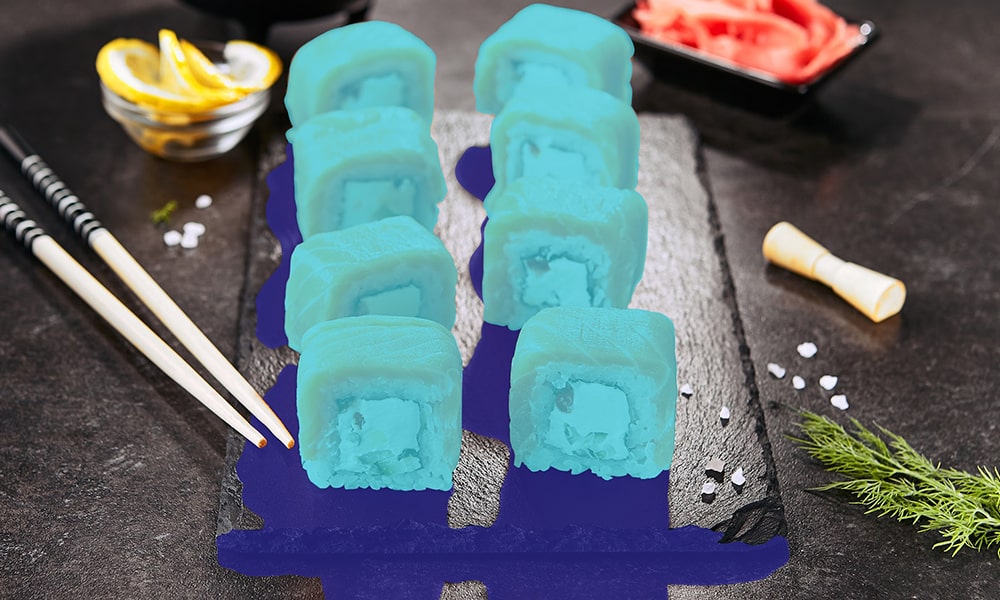
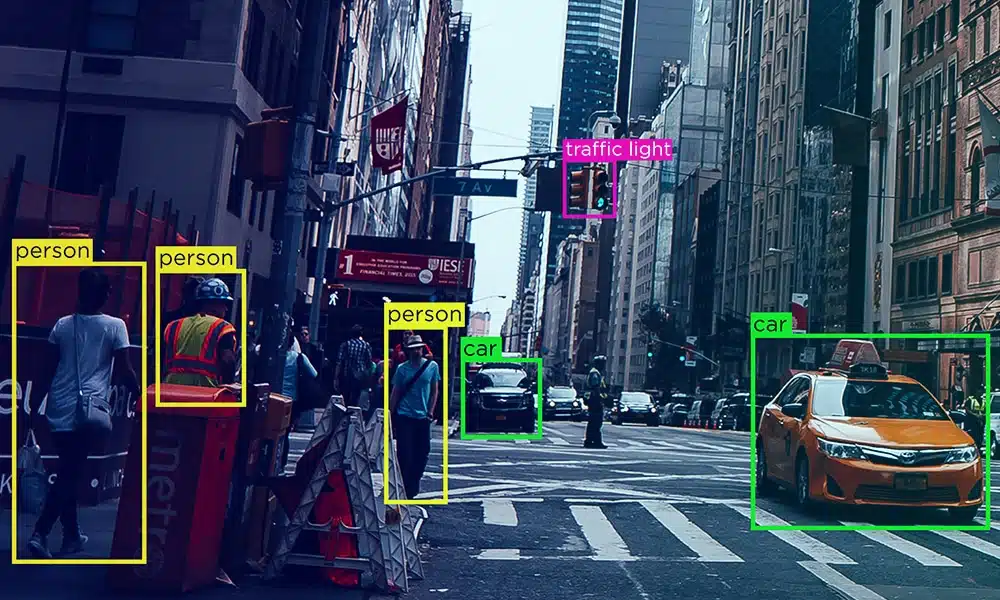
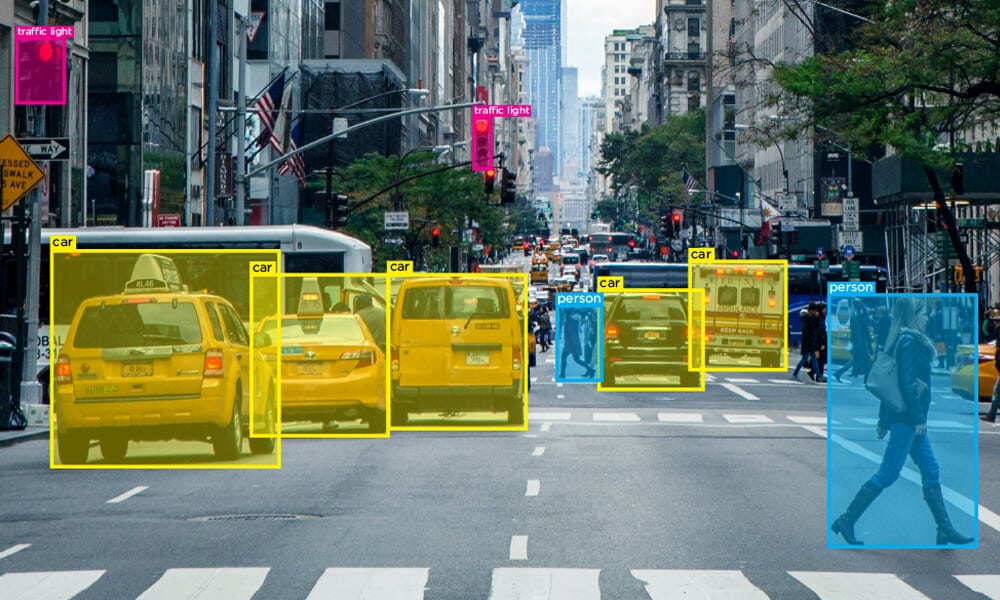
ડેટા લેબલિંગ એ છબીઓ, ઑડિઓ અથવા વિડિઓ જેવા ડેટાને લેબલિંગ અથવા ટેગિંગ કરવાનો પૂર્વ-પ્રોસેસિંગ પગલું છે , જે ML મોડેલ્સને મદદ કરે છે અને તેમને સચોટ આગાહીઓ કરવામાં સક્ષમ બનાવે છે.
ડેટા લેબલિંગ ફક્ત મશીન લર્નિંગ મોડેલ ડેવલપમેન્ટના પ્રારંભિક તબક્કા સુધી મર્યાદિત રહેવાની જરૂર નથી, પરંતુ આગાહીઓની ચોકસાઈને વધુ સુધારવા માટે ડિપ્લોયમેન્ટ પછી પણ ચાલુ રાખી શકાય છે.
ડેટા લેબલિંગનું મહત્વ

ડેટા લેબલિંગ એ એક મહત્વપૂર્ણ પ્રી-પ્રોસેસિંગ પગલું છે જે વાસ્તવિક દુનિયાના વાતાવરણને વિશ્વસનીય રીતે સમજી શકે તેવું સચોટ મોડેલ બનાવવામાં મદદ કરે છે. સચોટ રીતે લેબલ કરેલા ડેટાસેટ્સ ચોક્કસ આગાહીઓ અને ઉચ્ચ-ગુણવત્તાવાળા અલ્ગોરિધમ્સની ખાતરી કરે છે.
સામાન્ય રીતે પૂછાતા પ્રશ્નો
અહીં, વચન મુજબ, તમારા બધા પ્રશ્નો અને વિકાસ જીવનચક્રના કોઈપણ તબક્કા દરમિયાન તમે જે ભૂલો ટાળી શકો છો તેના માટે તૈયાર સંદર્ભ છે.
તમે ડેટાનો અર્થ કેવી રીતે કાઢો છો?
એક વ્યવસાય તરીકે, તમે કદાચ મોટી માત્રામાં ડેટા એકત્રિત કર્યો હશે, અને હવે તમે - આશા છે કે - ડેટામાંથી મુખ્ય આંતરદૃષ્ટિ અથવા મૂલ્યવાન માહિતી કાઢવા માંગો છો.
પરંતુ, તમારી પ્રોજેક્ટ જરૂરિયાતો અથવા વ્યવસાયિક ઉદ્દેશ્યોની સ્પષ્ટ સમજણ વિના, તમે તાલીમ ડેટાનો વ્યવહારુ ઉપયોગ કરી શકશો નહીં. તેથી પેટર્ન અથવા અર્થ શોધવા માટે તમારા ડેટાને તપાસવાનું શરૂ કરશો નહીં. તેના બદલે, ચોક્કસ હેતુ સાથે આગળ વધો જેથી તમને ખોટી સમસ્યાઓનો ઉકેલ ન મળે.
શું તાલીમ ડેટા ઉત્પાદન ડેટાનો સારો પ્રતિનિધિ છે? જો નહીં, તો હું તેને કેવી રીતે ઓળખી શકું?
ભલે તમે તેના પર વિચાર ન કર્યો હોય, પણ તમે જે લેબલવાળા ડેટા પર તમારા મોડેલને તાલીમ આપી રહ્યા છો તે ઉત્પાદન વાતાવરણથી નોંધપાત્ર રીતે અલગ હોઈ શકે છે.
કેવી રીતે ઓળખવું? કહેવાતા સંકેતો માટે જુઓ. તમારા મોડેલે પરીક્ષણ વાતાવરણમાં સારું પ્રદર્શન કર્યું અને ઉત્પાદન દરમિયાન નોંધપાત્ર રીતે ઓછું.
ઉકેલ?
ચોક્કસ જરૂરિયાતોને સચોટ રીતે સમજવા માટે વ્યવસાય અથવા ડોમેન નિષ્ણાતો સાથે સંપર્ક કરો.
-
પક્ષપાત કેવી રીતે ઓછો કરવો?
પૂર્વગ્રહ ઘટાડવાનો એકમાત્ર ઉપાય એ છે કે તમારા મોડેલમાં પૂર્વગ્રહ દાખલ થાય તે પહેલાં તેને દૂર કરવામાં સક્રિય રહેવું.
ડેટા પૂર્વગ્રહ કોઈપણ સ્વરૂપમાં હોઈ શકે છે - બિન-પ્રતિનિધિ ડેટાસેટ્સથી લઈને પ્રતિસાદ લૂપ્સ સાથેની સમસ્યાઓ સુધી. વિવિધ સ્વરૂપોના પૂર્વગ્રહનો સામનો કરવા માટે નવીનતમ વિકાસથી વાકેફ રહેવું અને મજબૂત પ્રક્રિયા ધોરણો અને માળખું સ્થાપિત કરવું જરૂરી છે.
-
હું મારા તાલીમ ડેટા એનોટેશન પ્રક્રિયાને કેવી રીતે પ્રાથમિકતા આપી શકું?
આ એક સૌથી સામાન્ય પ્રશ્ન છે જે આપણને પૂછવામાં આવે છે - ડેટાસેટના કયા ભાગને ટીકા કરતી વખતે પ્રાથમિકતા આપવી જોઈએ? આ એક માન્ય પ્રશ્ન છે, ખાસ કરીને જ્યારે તમારી પાસે મોટા ડેટાસેટ્સ હોય. તમારે આખા સેટ પર ટીકા કરવાની જરૂર નથી.
તમે અદ્યતન તકનીકોનો ઉપયોગ કરી શકો છો જે તમને તમારા ડેટાસેટનો ચોક્કસ ભાગ પસંદ કરવામાં અને તેને ક્લસ્ટર કરવામાં મદદ કરે છે જેથી તમે ફક્ત એનોટેશન માટે જરૂરી ડેટાનો સબસેટ મોકલી શકો. આ રીતે, તમે તમારા મોડેલની સફળતા વિશેની સૌથી મહત્વપૂર્ણ માહિતી મોકલી શકો છો.
-
અપવાદરૂપ કિસ્સાઓમાં હું કેવી રીતે કામ કરી શકું?
દરેક ML મોડેલ માટે અપવાદરૂપ કેસોનો સામનો કરવો પડકારજનક હોઈ શકે છે. ભલે આ મોડેલ તકનીકી રીતે કામ કરે, પણ જ્યારે તમારા વ્યવસાયની જરૂરિયાતો પૂરી કરવાની વાત આવે ત્યારે તે કદાચ કામ ન પણ કરે.

આ પડકારનો સામનો કરવા માટે, માનવ-ઇન-ધ-લૂપ પ્રતિસાદ અને દેખરેખ હેઠળનું શિક્ષણ ખૂબ જ મહત્વપૂર્ણ છે. ઉકેલ સમાન છબીઓ એકત્રિત કરવા માટે સમાનતા શોધનો ઉપયોગ અને સમગ્ર ડેટાસેટમાંથી ફિલ્ટરિંગનો ઉપયોગ કરવામાં રહેલો છે. આ સાથે, તમે ફક્ત સમાન છબીઓના સબસેટને ટીકા કરવા પર ધ્યાન કેન્દ્રિત કરી શકો છો અને માનવ-ઇન-ધ-લૂપ પદ્ધતિનો ઉપયોગ કરીને તેને વધારી શકો છો.
-
શું કોઈ ચોક્કસ લેબલ છે જેના વિશે મારે જાગૃત રહેવાની જરૂર છે?
ભલે તમે તમારી છબીઓ માટે સૌથી વિગતવાર લેબલિંગ આપવા માટે લલચાઈ શકો છો, તે હંમેશા જરૂરી અથવા આદર્શ ન પણ હોય. દરેક છબીને વિગતવાર અને ચોકસાઈનું એક નાનું સ્તર આપવા માટે જે સમય અને ખર્ચ લાગશે તે પ્રાપ્ત કરવું મુશ્કેલ છે.
જ્યારે તમારી પાસે મોડેલ આવશ્યકતાઓ પર સ્પષ્ટતા હોય ત્યારે વધુ પડતા પ્રિસ્ક્રિપ્ટિવ બનવાનું અથવા ડેટા એનોટેશનમાં સૌથી વધુ ચોકસાઇ માંગવાનું સૂચન કરવામાં આવે છે.
-
તમે એજ કેસોનો હિસાબ કેવી રીતે કરશો?
તમારી ડેટા એનોટેશન સ્ટ્રેટેજી બનાવતી વખતે એજ કેસોનો પણ વિચાર કરો. જોકે, સૌ પ્રથમ, તમારે એ સમજવું જોઈએ કે તમે જે પણ એજ કેસનો સામનો કરી શકો છો તેનો અંદાજ લગાવવો અશક્ય છે. તેના બદલે, તમે એક ચલ શ્રેણી અને એક વ્યૂહરચના પસંદ કરી શકો છો જે એજ કેસ જ્યારે પણ દેખાય ત્યારે શોધી શકે અને સમયસર તેનો ઉકેલ લાવી શકે.
-
હું ડેટાની અસ્પષ્ટતાને કઈ રીતે મેનેજ કરી શકું?
ડેટાસેટમાં અસ્પષ્ટતા ખૂબ સામાન્ય છે, અને સચોટ ટીકા માટે તમારે તેની સાથે કેવી રીતે વ્યવહાર કરવો તે જાણવું જોઈએ. ઉદાહરણ તરીકે, અડધા પાકેલા સફરજનની છબીને લીલા સફરજન અથવા લાલ સફરજન તરીકે લેબલ કરી શકાય છે.
આવી અસ્પષ્ટતાને ઉકેલવાની ચાવી શરૂઆતથી જ સ્પષ્ટ સૂચનાઓ છે. પ્રથમ, ટીકાકારો અને વિષય નિષ્ણાતો વચ્ચે સતત વાતચીત સુનિશ્ચિત કરો. આવી અસ્પષ્ટતાની અપેક્ષા રાખીને અને કાર્યબળમાં લાગુ કરી શકાય તેવા ધોરણોને વ્યાખ્યાયિત કરીને એક માનક નિયમ બનાવો.
-
શું ઉત્પાદનમાં મોડેલ પ્રદર્શન વધારવાના કોઈ રસ્તા છે?
પરીક્ષણ વાતાવરણ અને ઉત્પાદન ડેટા અલગ હોવાથી, થોડા સમય પછી પ્રદર્શનમાં વિચલનો થવાની શક્યતા રહે છે. તમે એવી અપેક્ષા રાખી શકતા નથી કે કોઈ મોડેલ એવી વસ્તુઓ શીખશે જે તેને તાલીમ દરમિયાન મળી ન હતી.
બદલાતા ઉત્પાદન ડેટા સાથે પરીક્ષણ ડેટાને સુસંગત રાખવાનો પ્રયાસ કરો. ઉદાહરણ તરીકે, તમારા મોડેલને ફરીથી તાલીમ આપો, માનવ લેબલરોને સામેલ કરો , વધુ સચોટ અને પ્રતિનિધિ દૃશ્યો સાથે ડેટાને વિસ્તૃત કરો, અને ફરીથી પરીક્ષણ કરો અને ઉત્પાદનમાં તેનો ઉપયોગ કરો.
-
તાલીમ ડેટા જરૂરિયાતોની મારી ટીકા માટે હું કોનો સંપર્ક કરી શકું?
દરેક વ્યવસાયને ML મોડેલ વિકસાવવાથી કંઈક મેળવવાનું હોય છે. દરેક વ્યવસાયિક એન્ટિટી પાસે કાચા ડેટાને મૂલ્યવાન સમજમાં રૂપાંતરિત કરવા માટે તકનીકી જ્ઞાન અથવા નિષ્ણાત ડેટા લેબલિંગ ટીમો હોતી નથી . સ્પર્ધાત્મક લાભ મેળવવા માટે તમારે તેનો ઉપયોગ કરી શકવો જોઈએ.
ડેટા તાલીમ ભાગીદારમાં તમે શોધી રહ્યા હોવ તો પણ, કેટલાક પાસાઓ હોવા છતાં, વિશ્વસનીયતા, અનુભવ અને વિષય જ્ઞાન એ યાદ રાખવાના ટોચના ત્રણ મુદ્દાઓ છે. વિશ્વસનીય તૃતીય-પક્ષ સેવા પ્રદાતા શોધતા પહેલા આનો વિચાર કરો.
સચોટ અને વિશ્વસનીય ડેટા લેબલિંગ સેવા પ્રદાતાઓની યાદીમાં Shaip અગ્રણી છે. અમે તમારી બધી લેબલિંગ અને ડેટા એનોટેશન જરૂરિયાતો માટે અદ્યતન એનાલિટિક્સ, અનુભવ ટીમો અને વિષય નિષ્ણાતોનો ઉપયોગ કરીએ છીએ . વધુમાં, અમે એક માનક પ્રક્રિયાનું પાલન કરીએ છીએ જેણે અમને અગ્રણી વ્યવસાયો માટે ટોપ-એન્ડ એનોટેશન અને લેબલિંગ પ્રોજેક્ટ્સ વિકસાવવામાં મદદ કરી છે.