તમે રાત્રે 9 વાગ્યે તમારી બેંકને ચાર્જનો વિરોધ કરવા માટે ફોન કરો છો. એક અવાજ આવે છે, પ્રથમ પ્રયાસમાં જ સમસ્યા સમજાય છે, વ્યવહાર નોંધાય છે, તમારી ઓળખની પુષ્ટિ કરે છે અને તેનું નિરાકરણ કરે છે - કોઈ હોલ્ડ મ્યુઝિક નહીં, કોઈ ટ્રાન્સફર નહીં, "મુખ્ય મેનૂ પર પાછા ફરવા માટે 4 દબાવો" નહીં. તે ક્રિયાપ્રતિક્રિયા AI ના વિજય જેવી લાગે છે.

તે છે. પરંતુ મોટાભાગના લોકો ધારે છે તે રીતે નહીં. આ મોડેલ હવે મોટાભાગે કોમોડિટી બની ગયું છે. તે કોલને સફળ બનાવનાર કારણ એ હતું કે તમારા જેવા લોકો દ્વારા હજારો કલાકો સુધી રેકોર્ડ કરાયેલ ભાષણ, જે "વિવાદ ચાર્જ" ના અર્થ પર સંમત થયેલા ટીકાકારો દ્વારા લેબલ કરવામાં આવ્યું હતું, સિસ્ટમ ખરેખર સાંભળશે તે ઉચ્ચારો અને શબ્દસમૂહો માટે સ્ક્રીનીંગ કરવામાં આવ્યું હતું, અને એવું શાસન કરવામાં આવ્યું હતું કે કોઈનો અવાજ સંમતિ વિના તાલીમ સમૂહમાં સમાપ્ત ન થાય.
2026 માં વાતચીત કરતી AI ની વાસ્તવિક વાર્તા આ જ છે. બજાર આશરે 21% CAGR પર $82.46 બિલિયન તરફ આગળ વધી રહ્યું છે , 78% સંસ્થાઓ હવે ઓછામાં ઓછા એક વ્યવસાયિક કાર્યમાં AI નો ઉપયોગ કરે છે, અને 75% ગ્રાહક સપોર્ટ માટે મોટા ભાષા મોડેલો ગોઠવવા માટે તૈયાર છે. ટેકનોલોજી સ્થાયી થઈ ગઈ છે. ડિફરન્શિએટર સ્ટેક નીચે, ડેટા પર ખસેડાઈ ગયો છે. અહીં આખી વસ્તુ કેવી રીતે એકસાથે બંધબેસે છે તે છે.
વાતચીત AI ખરેખર શું છે?
વાતચીત AI એ સિસ્ટમોનો પરિવાર છે - ચેટબોટ્સ, વર્ચ્યુઅલ એજન્ટ્સ, વૉઇસ સહાયકો - જે વાણી ઓળખ, કુદરતી ભાષા સમજણ અને વાણી જનરેશનને જોડીને કુદરતી, આગળ-પાછળ વાતચીત કરે છે, અને જ્યારે પણ તેનો ઉપયોગ થાય છે ત્યારે તે વધુ સારી બને છે.
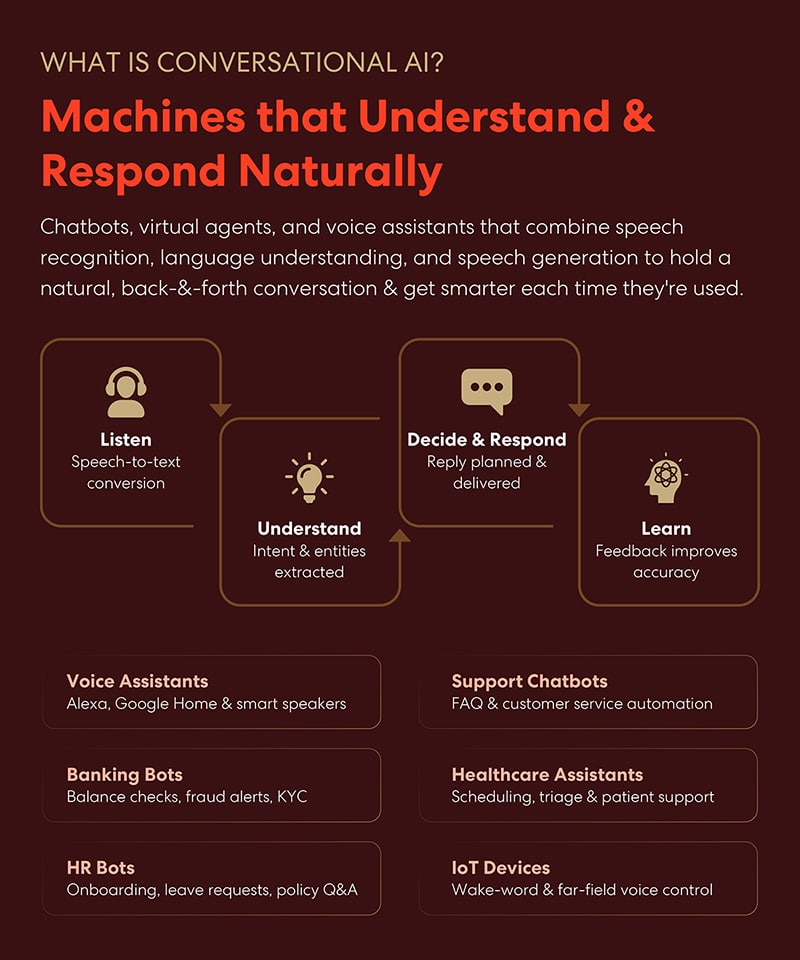
વિવિધતા હેઠળ, તે બધા સમાન ચાર-પગલાંનો લૂપ ચલાવે છે.
- સિસ્ટમ સાંભળે છે, ભાષણને ટેક્સ્ટમાં રૂપાંતરિત કરવું.
- It સમજે છે, ઉદ્દેશ્ય અને એન્ટિટીઝ - વપરાશકર્તા શું ઇચ્છે છે, અને તે ઇચ્છા સાથે જોડાયેલ ચોક્કસ વિગતો કાઢવા.
- It નિર્ણય લે છે અને પ્રતિભાવ આપે છે, જવાબનું આયોજન કરીને તેને પહોંચાડવું.
- અને તે શીખે છે, આગામી વળાંક અને આગામી વપરાશકર્તા પર ચોકસાઈ સુધારવા માટે પ્રતિસાદ સંકેતોનો ઉપયોગ કરીને.
સાંભળો → સમજો → નક્કી કરો → શીખો. નીચે આપેલ દરેક ઉત્પાદન એક જ લૂપની આસપાસ લપેટાયેલું એક અલગ ડોમેન છે.
- અવાજ સહાયક એલેક્સા અને ગુગલ હોમ જેવા લોકો સ્માર્ટ સ્પીકર્સ દ્વારા ખુલ્લા ઘરગથ્થુ વિનંતીઓનું સંચાલન કરે છે.
- ચેટબોટ્સને સપોર્ટ કરો FAQ હેન્ડલિંગ અને ગ્રાહક સેવા ટ્રાયજને સ્વચાલિત કરો.
- બેંકિંગ બોટ્સ બેલેન્સ ચેક, છેતરપિંડીની ચેતવણીઓ અને KYC ચકાસણી ચલાવો.
- આરોગ્યસંભાળ સહાયકો સમયપત્રક, લક્ષણ ગણતરી અને દર્દી સહાયનું સંચાલન કરો.
- HR બોટ્સ ફીલ્ડ ઓનબોર્ડિંગ પ્રશ્નો, રજા વિનંતીઓ અને નીતિ પ્રશ્નોત્તરી.
- અને આઇઓટી ડિવાઇસ વેક-વર્ડ ડિટેક્શન અને દૂર-ક્ષેત્રના વૉઇસ કંટ્રોલ પર આધાર રાખે છે, જ્યાં માઇક્રોફોન રૂમની પેલે પાર હોય છે અને વપરાશકર્તા સ્ક્રીન તરફ જોતો નથી.
સમાન પાઇપલાઇન, નિષ્ફળતાની પરિસ્થિતિઓ સંપૂર્ણપણે અલગ છે. એક રિટેલ ચેટબોટ જે ઇરાદાને ખોટી રીતે વાંચે છે તેના માટે રૂપાંતરનો ખર્ચ થાય છે. એક હેલ્થકેર ટ્રાયજ સહાયક જે ઇરાદાને ખોટી રીતે વાંચે છે તે દર્દી-સુરક્ષાની ઘટના છે. તે તફાવત ડેટામાં ઉકેલાય છે, આર્કિટેક્ચરમાં નહીં.
કાચી વાણી તાલીમ ડેટા કેવી રીતે બને છે
રેકોર્ડિંગથી મોડેલ-તૈયાર ડેટાસેટ સુધી પહોંચવા માટે બે અલગ અલગ પાસની જરૂર પડે છે: ભાષણ કેવી રીતે એકત્રિત કરવામાં આવે છે તે પસંદ કરવું, પછી તેને લેબલ કરવું જેથી મોડેલ તેમાંથી શીખી શકે. જે ટીમો આને એક પગલા તરીકે ગણે છે તેઓ મોટા ડેટાસેટ સાથે સમાપ્ત થાય છે જે ખોટી વસ્તુઓ શીખવે છે.
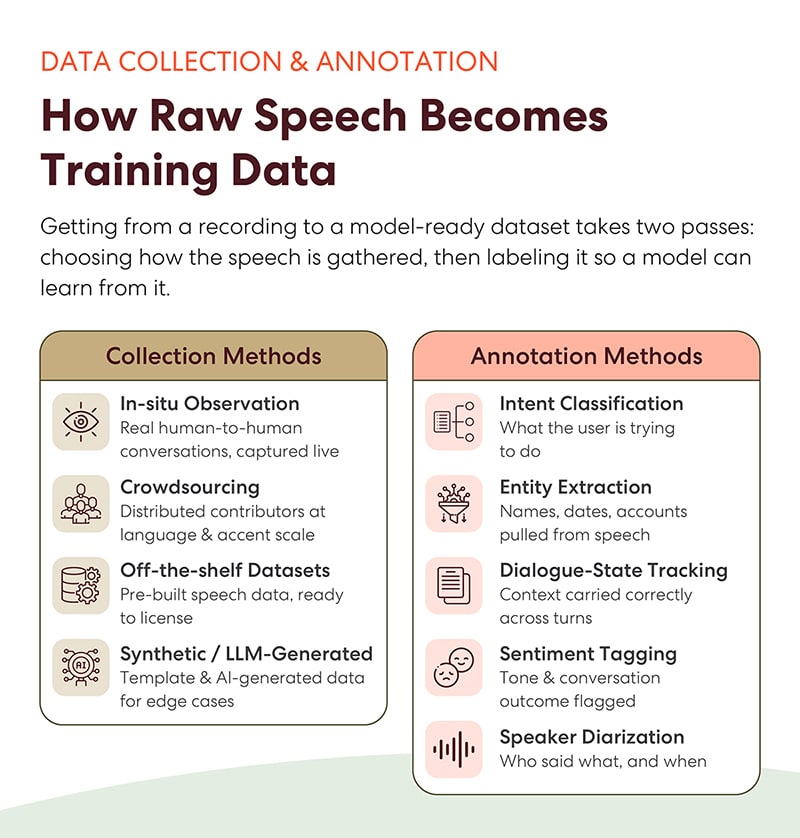
સંગ્રહ બાજુએ , ચાર પદ્ધતિઓ મોટાભાગની જરૂરિયાતોને આવરી લે છે.
- ઇન-સીટુ અવલોકન વાસ્તવિક માનવ-માનવ વાતચીતને લાઇવ કેપ્ચર કરે છે — ઉપલબ્ધ સૌથી વિશ્વાસુ સંકેત, અને સ્કેલ પર મેળવવા માટે સૌથી મુશ્કેલ.
- crowdsourcing ભાષા અને ઉચ્ચારણ દ્વારા પસંદ કરાયેલા યોગદાનકર્તાઓને રેકોર્ડિંગનું વિતરણ કરે છે, જે રીતે કવરેજ આકસ્મિક રીતે નહીં પણ ઇરાદાપૂર્વક બનાવવામાં આવે છે.
- ઑફ-ધ-શેલ્ફ ડેટાસેટ્સ જ્યારે ડોમેન વાજબી મેળ ખાતો હોય ત્યારે સમયરેખામાંથી મહિનાઓ કાપીને, લાઇસન્સ માટે તૈયાર પૂર્વ-નિર્મિત, પૂર્વ-સાફ કરેલ સ્પીચ ડેટા પ્રદાન કરો.
- અને કૃત્રિમ અથવા LLM-જનરેટેડ ડેટા ચોક્કસ ખાલી જગ્યાઓ ભરે છે — ટેમ્પલેટ-આધારિત અને એઆઈ-જનરેટેડ ઉચ્ચારણો જે એજ કેસ માટે રાહ જોવા માટે ખૂબ જ દુર્લભ છે.
ટીકા બાજુએ , પાંચ લેબલિંગ સ્તરો ઑડિઓને દેખરેખમાં ફેરવે છે.
- ઉદ્દેશ્ય વર્ગીકરણ વપરાશકર્તા શું કરવાનો પ્રયાસ કરી રહ્યો છે તે ટૅગ કરે છે.
- એન્ટિટી નિષ્કર્ષણ ભાષણમાંથી નામ, તારીખો અને ખાતા નંબર કાઢી નાખે છે.
- ડાયલોગ-સ્ટેટ ટ્રેકિંગ સંદર્ભને વળાંકોમાં વહન કરે છે, તેથી સિસ્ટમ જાણે છે કે "બીજો" ચાર વળાંક પહેલા ઉલ્લેખિત કંઈકનો સંદર્ભ આપે છે.
- સેન્ટિમેન્ટ ટેગિંગ ધ્વજ સ્વર અને વાતચીતનું પરિણામ.
- અને સ્પીકર ડાયરાઇઝેશન કોણે શું અને ક્યારે કહ્યું તે સ્થાપિત કરે છે — કોઈપણ બહુ-પક્ષીય રેકોર્ડિંગ માટે, એટલે કે મોટાભાગના વાસ્તવિક કોલ ડેટા માટે, વાટાઘાટો કરી શકાતી નથી.
એકત્રિત કરો → ટ્રાન્સક્રાઇબ કરો → લેબલ ઇન્ટેન્ટ્સ અને એન્ટિટીઝ → ટ્રેક સ્ટેટ → ડાયરાઇઝ → માન્ય કરો. એક લેયર છોડો અને તમને એક મોડેલ મળશે જે અસ્ખલિત રીતે ટ્રાન્સક્રાઇબ કરે છે અને કંઈપણ સમજતું નથી.
"સારા ડેટા" ને ખરેખર શેના દ્વારા માપવામાં આવે છે
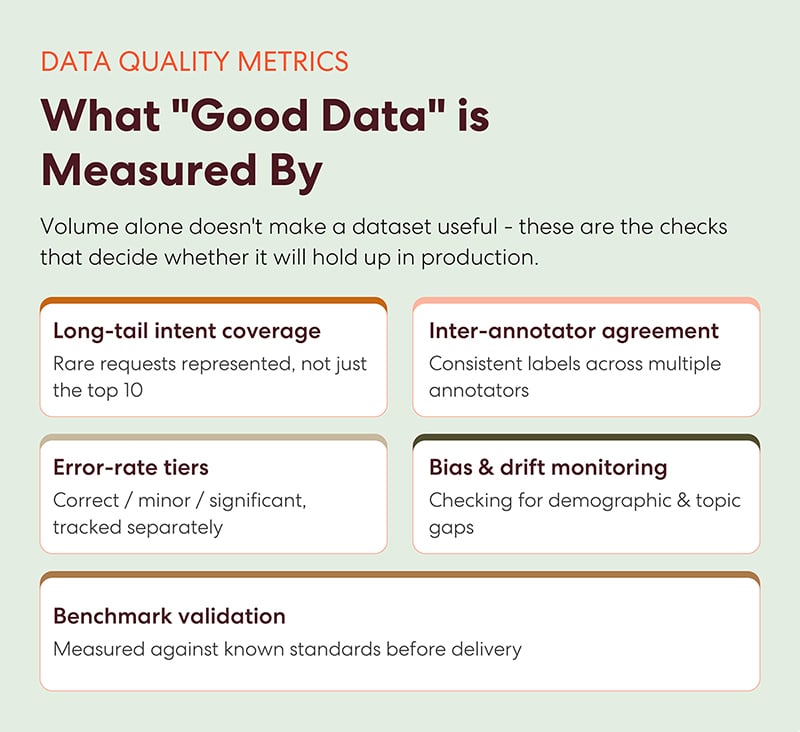
ફક્ત વોલ્યુમ ડેટાસેટને ઉપયોગી બનાવતું નથી. પાંચ ચેક નક્કી કરે છે કે તે ઉત્પાદનમાં ટકી રહેશે કે નહીં, અને તે કોઈપણ વિક્રેતાને સીધા પૂછવા યોગ્ય છે.
- લોંગ-ટેઇલ ઇન્ટેન્ટ કવરેજ પૂછે છે કે શું દુર્લભ વિનંતીઓ રજૂ થાય છે, ફક્ત ટોચના દસ જ નહીં. મોટાભાગના ડેટાસેટ્સ પર વપરાશકર્તાઓ દ્વારા સતત હિટ કરવામાં આવતા મુઠ્ઠીભર ઇન્ટેન્ટ્સનું વર્ચસ્વ હોય છે - અને મોટાભાગની ઉત્પાદન નિષ્ફળતાઓ પાછળથી થાય છે.
- ઇન્ટર-એનોટેટર કરાર માપે છે કે બહુવિધ ટીકાકારો એક જ ઉચ્ચારણને સમાન રીતે લેબલ કરે છે કે નહીં; ઓછી સંમતિનો અર્થ એ છે કે તમારા લેબલ્સ મૂળ સત્યને બદલે મૂંઝવણને એન્કોડ કરે છે.
- ભૂલ-દર સ્તરો નોંધપાત્ર ભૂલોને નાની ભૂલોથી અલગ કરો અને તેમને સ્વતંત્ર રીતે ટ્રેક કરો, કારણ કે આપત્તિજનક ખોટી વર્ગીકરણથી બનેલો 3% ભૂલ દર નાની ભૂલોના 3% દર જેવો જ ઉત્પાદન નથી.
- પૂર્વગ્રહ અને ડ્રિફ્ટ મોનિટરિંગ વસ્તી વિષયક અને વિષયના અંતરની તપાસ કરે છે, અને ભાષા અને વપરાશકર્તા વર્તણૂકમાં ફેરફાર થતાં સમય જતાં તેનું નિરીક્ષણ કરે છે.
- અને બેન્ચમાર્ક માન્યતા ડિલિવરી પહેલાં ડેટાસેટને જાણીતા ધોરણો સામે માપે છે, જેથી ગુણવત્તા તમારી સમસ્યા બને તે પહેલાં જ સ્થાપિત થાય.
આ પાંચ ડેટાસેટ જે તમે જમાવી શકો છો અને જે ડેટાસેટ તમારે ફરીથી કરવું પડે છે તે વચ્ચેનો તફાવત છે.
વિશ્વાસ ડેટા લેયરમાં બનેલો છે, બોલ્ટેડ નથી.
વાણી ડેટા વ્યક્તિના અવાજ અને શબ્દોને વહન કરે છે - તેમના વિશેની બે સૌથી ઓળખ આપતી બાબતો. શાસન સંગ્રહથી જ ડિઝાઇન કરવું જોઈએ, કારણ કે તમે પહેલાથી જ તાલીમ લીધેલા રેકોર્ડિંગમાં પૂર્વવર્તી રીતે સંમતિ ઉમેરવાનો કોઈ રસ્તો નથી.
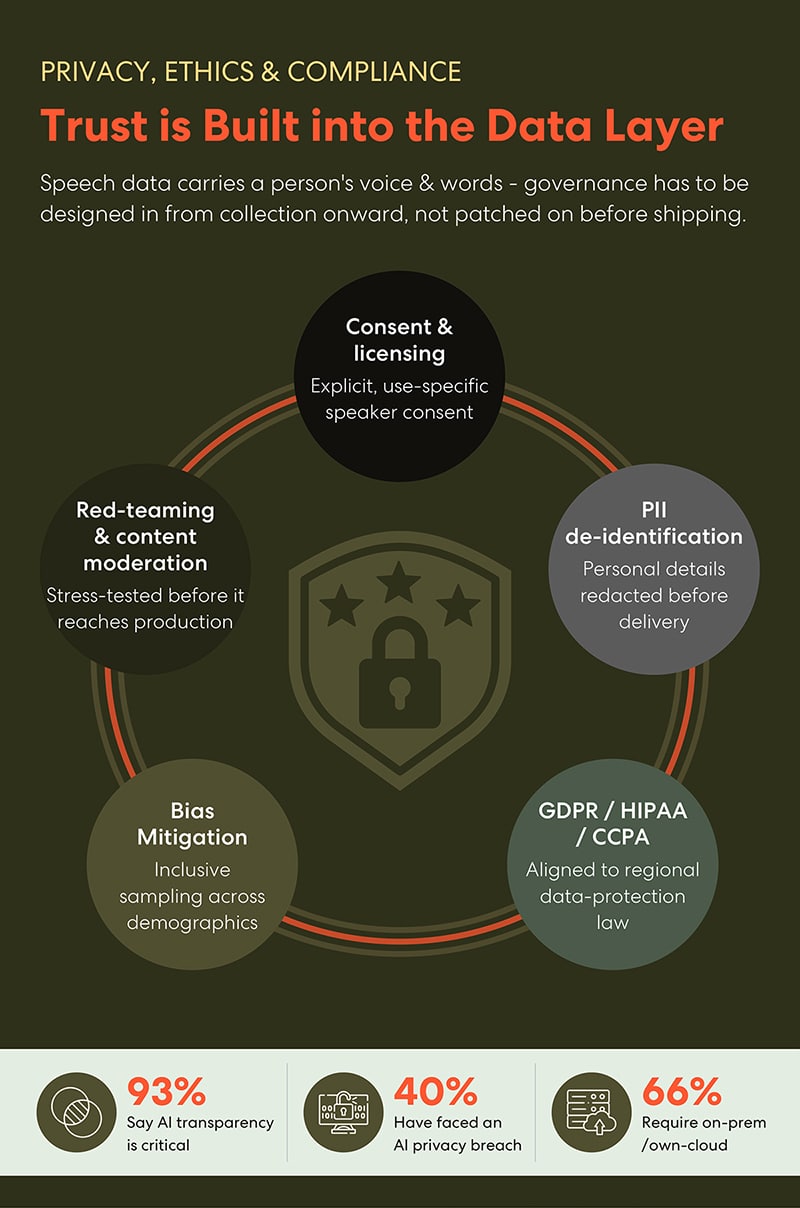
પાંચ નિયંત્રણો ડિફેન્સિબલ ડેટા લેયરને વ્યાખ્યાયિત કરે છે.
- સંમતિ અને લાઇસન્સિંગ જેનો અર્થ સ્પષ્ટ, ઉપયોગ-વિશિષ્ટ વક્તાની સંમતિ છે - સેવાની સંપૂર્ણ શરતોની કલમ નહીં.
- PII ઓળખ રદ કરવી ડિલિવરી પહેલાં વ્યક્તિગત વિગતો સંપાદિત કરે છે, ઘટના પછી નહીં.
- GDPR, HIPAA અને CCPA સંરેખણ પાઇપલાઇનને પ્રાદેશિક ડેટા-સુરક્ષા કાયદા સાથે મેપ કરે છે જે વાસ્તવમાં ડિપ્લોયમેન્ટ પર લાગુ પડે છે.
- પૂર્વગ્રહ શમન સંગ્રહ યોજનામાં વસ્તી વિષયક બાબતોમાં સમાવેશી નમૂના લેવાનું નિર્માણ કરે છે, જ્યાં તેનો કોઈ ખર્ચ નથી, તેના બદલે ઉપાયમાં, જ્યાં તેનો ખર્ચ બધું જ થાય છે.
- અને રેડ-ટીમિંગ અને કન્ટેન્ટ મોડરેશન ઉત્પાદન વપરાશકર્તાઓ સુધી પહોંચે તે પહેલાં સિસ્ટમનું તાણ-પરીક્ષણ કરે છે.
બજારે આની કિંમત નક્કી કરી છે. ૯૩% સંસ્થાઓ કહે છે કે AI પારદર્શિતા મહત્વપૂર્ણ છે, ૪૦% સંસ્થાઓ પહેલાથી જ AI ગોપનીયતા ભંગનો સામનો કરી ચૂકી છે, અને ૬૬% સંસ્થાઓને હવે ઓન-પ્રિમાઈસ અથવા ઓન-ક્લાઉડ ડિપ્લોયમેન્ટની જરૂર છે. ખરીદદારો પૂછી રહ્યા છે કે ડેટા ક્યાંથી આવ્યો - અને વધુને વધુ, તેઓ કરારમાં જવાબ ઇચ્છે છે.
જ્યાં વાતચીતનું AI દેખાય છે
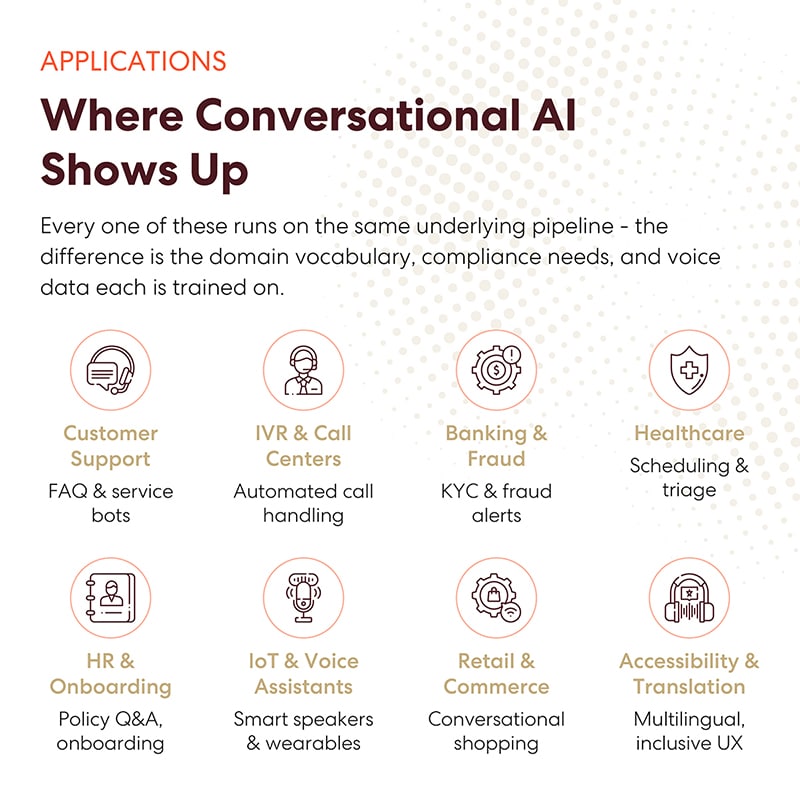
મોટાભાગના એન્ટરપ્રાઇઝ ડિપ્લોયમેન્ટ માટે આઠ એપ્લિકેશન ક્ષેત્રોનો હિસ્સો છે.
- ગ્રાહક સેવા FAQ અને સર્વિસ બોટ્સ ચલાવે છે.
- IVR અને કોલ સેન્ટર કોલ હેન્ડલિંગ અને રૂટીંગને સ્વચાલિત કરે છે.
- બેંકિંગ અને છેતરપિંડી KYC ચકાસણી અને છેતરપિંડીની ચેતવણીને આવરી લે છે.
- સ્વાસ્થ્ય કાળજી શેડ્યુલિંગ અને ટ્રાયજનું સંચાલન કરે છે.
- એચઆર અને ઓનબોર્ડિંગ નીતિ પ્રશ્નોત્તરી અને નવા ભરતી કાર્યપ્રવાહનું સંચાલન કરે છે.
- IoT અને વૉઇસ સહાયકો પાવર સ્માર્ટ સ્પીકર્સ અને પહેરવાલાયક ઉપકરણો.
- છૂટક અને વાણિજ્ય વાતચીતની ખરીદીને સક્ષમ બનાવે છે.
- અને સુલભતા અને અનુવાદ પ્રમાણભૂત ઇન્ટરફેસ સિવાયના લોકોને બહુભાષી, સમાવિષ્ટ વપરાશકર્તા અનુભવ પ્રદાન કરે છે.
આ દરેક એક જ અંતર્ગત પાઇપલાઇન પર ચાલે છે. તફાવત એ છે કે ડોમેન શબ્દભંડોળ, પાલન આવશ્યકતાઓ અને દરેકને તાલીમ આપવામાં આવેલ વૉઇસ ડેટા. તે છેલ્લો ચલ એ છે કે ટીમો કયામાં ઓછું રોકાણ કરે છે અને જે નક્કી કરે છે કે ડિપ્લોયમેન્ટ ડેમોની બહાર કામ કરે છે કે નહીં.
વધુ સારા વાર્તાલાપાત્મક AI વધુ સારા ડેટાથી શરૂ થાય છે
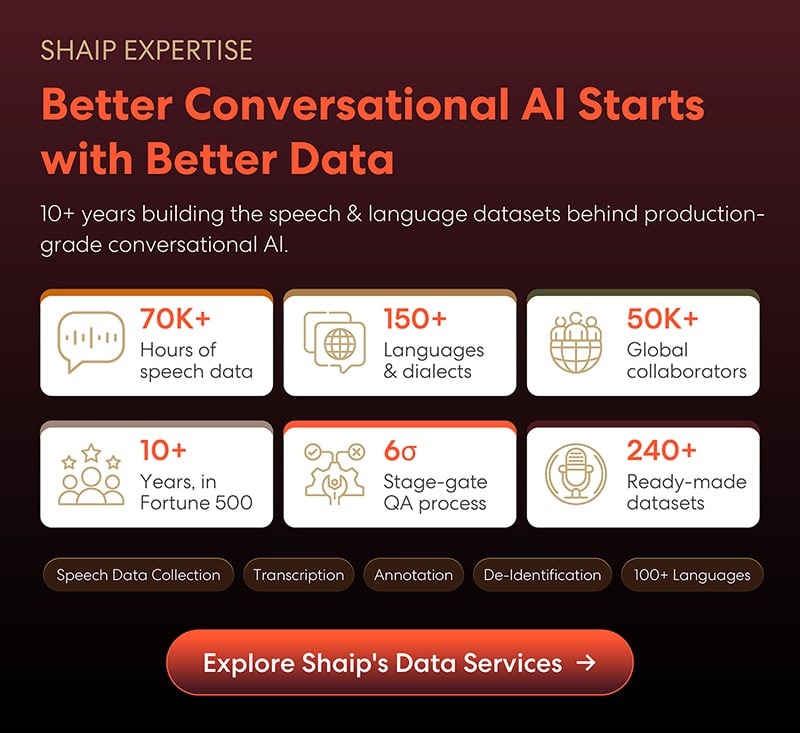
કાર્યકારી પ્રોટોટાઇપ અને પ્રોડક્શન-ગ્રેડ સહાયક વચ્ચેનું અંતર ઓછું કરવું એ ડેટા-ઓપરેશન સમસ્યા છે, અને આ તે સમસ્યા છે જેના પર શેપે એક દાયકાથી વધુ સમય વિતાવ્યો છે:
- ૭૦,૦૦૦+ કલાક વાણી ડેટા,
- ૫૩+ ભાષાઓ અને બોલીઓ,
- ૫૦,૦૦૦+ વૈશ્વિક સહયોગીઓ,
- 10+ વર્ષ ફોર્ચ્યુન 500 AI ટીમોને સેવા આપવી,
- a છ-સિગ્મા સ્ટેજ-ગેટ QA પ્રક્રિયા,
- ૨૪૦+ તૈયાર ડેટાસેટ્સ જ્યારે સમયરેખા શરૂઆતથી સંગ્રહ કરવાની મંજૂરી ન આપે ત્યારે શેલ્ફમાંથી ઉપલબ્ધ.
સ્પીચ ડેટા કલેક્શન, ટ્રાન્સક્રિપ્શન, એનોટેશન અને ડી-ઓળખમાં, ધ્યેય એક જ છે: તાલીમ ડેટા જે તમારા ઉત્પાદન ખરેખર કોની સાથે વાત કરશે તે લોકોને પ્રતિબિંબિત કરે છે, સંમતિ ટ્રેઇલ અને ગુણવત્તા મેટ્રિક્સ સાથે તેને સાબિત કરવા માટે.
આ બોટમ લાઇન
વાતચીતનો AI હવે ટેકનોલોજીનો પ્રશ્ન બનવાનું બંધ કરી દીધું છે. લૂપ સારી રીતે સમજાય છે, મોડેલો વ્યાપકપણે ઉપલબ્ધ છે, અને એપ્લિકેશનો દરેક ઉદ્યોગના બજેટમાં લાઇન આઇટમ્સ છે. જે ખરેખર મુશ્કેલ રહે છે તે ડેટા સ્તર છે - લાંબા-પૂંછડી કવરેજ, લેબલ કરાર, વસ્તી વિષયક સંતુલન, સંમતિ અને ઓળખ રદ કરવી.
આમાં પણ ફાયદો છે. એક જ મોડેલનો ઉપયોગ કરતી બે ટીમો ખૂબ જ અલગ ગુણવત્તાના ઉત્પાદનો મોકલશે, અને તફાવત તેમની સિસ્ટમોને શું તાલીમ આપવામાં આવી હતી તેના પર આધાર રાખશે. જો તમે વાતચીતયુક્ત AI બનાવી રહ્યા છો, તો તમે જે સૌથી મહત્વપૂર્ણ નિર્ણયો લેશો તે આર્કિટેક્ચર વિશે નથી. તે તમારા ડેટાસેટમાં કોના અવાજો છે, તેમને કેટલી સારી રીતે લેબલ કરવામાં આવ્યા છે અને તમને તેનો ઉપયોગ કરવાનો અધિકાર હતો કે નહીં તે વિશે છે.