કલ્પના કરો કે તમે કોઈ વૉઇસ આસિસ્ટન્ટને લાંબી મીટિંગનો સારાંશ આપવા, તેને સ્પેનિશમાં અનુવાદિત કરવા અને ક્રિયા વસ્તુઓને તમારા CRM માં મોકલવા કહો છો - આ બધું એક જ વૉઇસ નોટમાંથી.
તે "જાદુ" પાછળ ફક્ત વ્હીસ્પર જેવું શક્તિશાળી મોડેલ કે જેમિની કે ચેટજીપીટી જેવું એલએલએમ નથી. તે તે મોડેલોને તાલીમ આપવા અને ફાઇન-ટ્યુન કરવા માટે ઉપયોગમાં લેવાતા સ્પીચ રેકગ્નિશન ડેટાસેટ્સ છે.
૨૦૨૫ માં, વાણી અને અવાજ ઓળખ એક અબજો ડોલરનું બજાર છે, જે ૨૦૩૨ સુધીમાં ૮૦ અબજ ડોલરને વટાવી જવાનો અંદાજ છે.
જો તમારું AI ઉત્પાદન સ્પોકન ઇનપુટ પર આધાર રાખે છે - પછી ભલે તે કોન્ટેક્ટ સેન્ટર કોલ્સ હોય, ડિક્ટેશન હોય કે વૉઇસ સર્ચ હોય - તો તમારા સ્પીચ ડેટાસેટ્સની ગુણવત્તા, વિવિધતા અને કાયદેસરતા નક્કી કરશે કે તમારું AI કેટલી સારી રીતે "સાંભળે છે".
આ લેખમાં, આપણે વિવિધ સ્પીચ રેકગ્નિશન ડેટાસેટ્સ વિશે વાત કરીશું. તમારા AI મોડેલ માટે શ્રેષ્ઠ ડેટાસેટ્સ પસંદ કરવામાં તમારી મદદ કરવા માટે અમે તેમના પ્રકારોનું અન્વેષણ કરીશું.
પણ પહેલા, ચાલો કેટલીક મૂળભૂત બાબતોમાં પ્રવેશ કરીએ.
સ્પીચ રેકગ્નિશન ડેટાસેટ શું છે?
દાખલા તરીકે, ટેક્સાસની વ્યક્તિ લંડનની વ્યક્તિ કરતાં અલગ અવાજ કરે છે, ભલે તે એક જ વાક્ય બોલે. એક સારો ડેટાસેટ આ વિવિધતાને કેદ કરે છે. તે AI ને માનવ વાણીની સૂક્ષ્મતા સાંભળવામાં અને સમજવામાં મદદ કરે છે.
આ ડેટાસેટ AI મોડેલ્સ વિકસાવવામાં મહત્વપૂર્ણ ભૂમિકા ભજવે છે. તે AI ને ભાષા સમજણ અને ઉત્પાદન શીખવા માટે જરૂરી ડેટા પૂરો પાડે છે. સમૃદ્ધ અને વૈવિધ્યસભર ડેટાસેટ સાથે, AI મોડેલ માનવ ભાષાને સમજવા અને તેની સાથે ક્રિયાપ્રતિક્રિયા કરવા માટે વધુ સક્ષમ બને છે. તેથી, વાણી ઓળખ ડેટાસેટ તમને બુદ્ધિશાળી, પ્રતિભાવશીલ અને સચોટ અવાજ AI મોડેલ્સ બનાવવામાં મદદ કરી શકે છે.
તમને ગુણવત્તાયુક્ત વાણી ઓળખ ડેટાસેટની શા માટે જરૂર છે?
સ્પીચ-નેટિવ LLM ના ઉદય સાથે, નવા ડેટાસેટ પ્રકારો ઉભરી રહ્યા છે:
- કુદરતી ભાષાના વર્ણનો સાથે અભિવ્યક્ત ભાષણ (દા.ત., સ્પીચક્રાફ્ટ) - શૈલી, લાગણી અને છંદશાસ્ત્રને સમજતા તાલીમ મોડેલોને સમર્થન આપે છે.
- વાસ્તવિક ડેટા વધારવા માટે TTS + LLM-જનરેટેડ ટેક્સ્ટ (દા.ત., મેગ્પી સ્પીચ) સાથે કૃત્રિમ સ્પીચ કોર્પોરા બનાવવામાં આવ્યું.
- વૉઇસ સુરક્ષા અને છેતરપિંડી શોધ માટે નકલી વાણી / સ્પૂફ શોધ ડેટાસેટ્સ (દા.ત., લામાપાર્ટીઅલસ્પૂફ).
જ્યારે ઉપયોગ કરો: તમે સ્પીચ-લેંગ્વેજ મોડેલ્સ, એક્સપ્રેસિવ TTS, અથવા AI સલામતી/છેતરપિંડી શોધ પર કામ કરી રહ્યા છો.
યોગ્ય સ્પીચ રેકગ્નિશન ડેટાસેટ કેવી રીતે પસંદ કરવો (પગલું-દર-પગલું)
આનો ઉપયોગ વ્યવહારુ નિર્ણય માળખા તરીકે કરો.
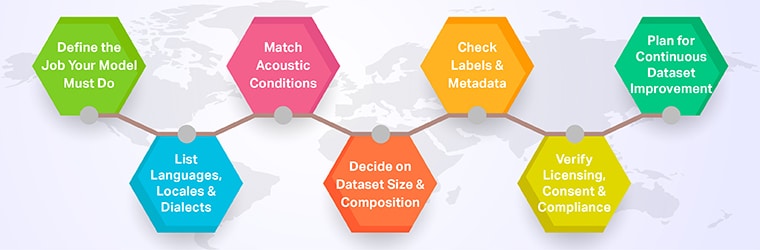
પગલું 1 - તમારા મોડેલે શું કરવું જોઈએ તે કાર્ય વ્યાખ્યાયિત કરો
- કાર્ય: શ્રુતલેખન, વૉઇસ શોધ, સંપર્ક કેન્દ્ર વિશ્લેષણ, રીઅલ-ટાઇમ કૅપ્શન્સ, પાલન દેખરેખ, વગેરે.
- ચેનલ: ટેલિફોની (8 kHz), મોબાઇલ એપ્લિકેશન, દૂરના ક્ષેત્રના સ્માર્ટ સ્પીકર્સ, કારમાં માઇક્રોફોન.
- ગુણવત્તા બાર: લક્ષ્ય WER, વિલંબતા, પ્રતિભાવ સમય, નિયમનકારી આવશ્યકતાઓ.
પગલું 2 - ભાષાઓ, સ્થાનિક ભાષા અને બોલીઓની યાદી બનાવો
- કઈ ભાષાઓ અને કયા પ્રકારો (દા.ત., યુએસ અંગ્રેજી વિરુદ્ધ ભારતીય અંગ્રેજી વિરુદ્ધ સિંગાપોર અંગ્રેજી)?
- તમને જરૂર છે કોડ-મિક્સ્ડ ભાષણ (હિન્દી-અંગ્રેજી, સ્પેનિશ-અંગ્રેજી, વગેરે)?
- શું તમે ઓછી સંસાધન ભાષાઓને લક્ષ્ય બનાવી રહ્યા છો જ્યાં ખુલ્લો ડેટા દુર્લભ છે?
પગલું 3 - એકોસ્ટિક સ્થિતિઓનો મેળ કરો
- ટેલિફોની વિરુદ્ધ વાઇડબેન્ડ વિરુદ્ધ મલ્ટી-માઇક એરે.
- શાંત ઓફિસ વિરુદ્ધ ઘોંઘાટીયા શેરી વિરુદ્ધ ચાલતી કાર.
- નજીકના ક્ષેત્ર વિરુદ્ધ દૂરના ક્ષેત્રના માઇક્રોફોન.
તમારા ડેટાસેટમાં તમારા વપરાશકર્તાઓ ખરેખર જે વાતાવરણમાં હશે તેનું પ્રતિબિંબ હોવું જોઈએ.
પગલું 4 - ડેટાસેટનું કદ અને રચના નક્કી કરો
અંગૂઠાના નિયમો (કડક નહીં):
- પૂર્વ-પ્રશિક્ષિત મોડેલને સુધારવું (વ્હીસ્પર, wav2vec2, વગેરે)
- ડઝનેકથી લઈને થોડાક સો કલાકનો ઉચ્ચ-ગુણવત્તાવાળો, ડોમેન-મેળ ખાતો ડેટા સોયને ખૂબ જ હલાવી શકે છે.
- શરૂઆતથી મોડેલને તાલીમ આપવી
- સામાન્ય રીતે હજારોથી લઈને હજારો કલાકોની જરૂર પડે છે, તેથી જ ઘણી ટીમો પૂર્વ-પ્રશિક્ષિત સિસ્ટમોથી શરૂઆત કરે છે અને ડેટાને ફાઇન-ટ્યુનિંગ પર બજેટ કેન્દ્રિત કરે છે.
મિકસ:
- કેટલાક સ્વચ્છ સ્ક્રિપ્ટેડ ડેટા (મુખ્ય ધ્વન્યાત્મકતા, સંખ્યાઓ માટે).
- વાસ્તવિક વાતચીતનો ડેટા (મજબૂતાઈ માટે).
- ડોમેન-વિશિષ્ટ ધાર કેસ (દુર્લભ એન્ટિટી, લાંબા નંબરો, શબ્દભંડોળ).
પગલું ૫ - લેબલ્સ અને મેટાડેટા તપાસો
ક્લાસિક ASR માટે, તમારે ઓછામાં ઓછું આની જરૂર પડશે:
- સચોટ ટ્રાન્સક્રિપ્ટ્સ
- મૂળભૂત સ્પીકર ટૅગ્સ
- સુસંગત વિરામચિહ્નો અને કેસિંગ નિયમો
LLM + ASR પાઇપલાઇન્સ માટે, તમારે આ પણ જોઈએ છે:
- સ્પીકરના વળાંકનું વિભાજન (કોણે શું કહ્યું, ક્યારે)
- કૉલ/વાતચીત પરિણામો (ઉકેલાયેલ, વધારો થયેલ, ફરિયાદ પ્રકાર)
- એન્ટિટી એનોટેશન (નામો, એકાઉન્ટ નંબર, પ્રોડક્ટ નામો)
- જ્યાં સંબંધિત હોય ત્યાં લાગણી અથવા લાગણીના ટૅગ્સ.
આ લેબલ્સ તમને ટ્રાન્સક્રિપ્ટ્સની ટોચ પર સારાંશ, QA, કોચિંગ, રૂટીંગ અને RAG પાઇપલાઇન્સ બનાવવા દે છે - જ્યાં હવે ઘણું વ્યવસાયિક મૂલ્ય રહે છે.
પગલું 6 - લાઇસન્સિંગ, સંમતિ અને પાલન ચકાસો
તાલીમ આપતા પહેલા:
- શું ડેટાસેટ આ માટે લાઇસન્સ પ્રાપ્ત છે? વ્યાપારી ઉપયોગ (માત્ર સંશોધન જ નહીં)?
- શું વક્તાઓ આ ઉપયોગ માટે જાણકાર હતા અને સંમતિ આપી હતી?
- શું PII અને સંવેદનશીલ વિશેષતાઓ GDPR / HIPAA / સ્થાનિક નિયમો અનુસાર નિયંત્રિત થાય છે?
ઘણા ખુલ્લા ડેટાસેટ્સ CC-BY અથવા CC0 જેવા લાઇસન્સનો ઉપયોગ કરે છે , દરેકની અલગ અલગ જવાબદારીઓ હોય છે. જ્યારે શંકા હોય, ત્યારે કાનૂની સમીક્ષાને બિન-વાટાઘાટપાત્ર પગલા તરીકે ગણો.
પગલું 7 – સતત ડેટાસેટ સુધારણા માટેની યોજના
ભાષાઓનો વિકાસ થાય છે, તમારું ઉત્પાદન વિકસિત થાય છે, અને તેથી તમારા ડેટાસેટનો વિકાસ થવો જોઈએ:
- વાસ્તવિક દુનિયાની ભૂલોનું નિરીક્ષણ કરો અને ખોટી ઓળખાણોને તમારા તાલીમ સમૂહમાં પાછી ઉમેરો.
- તમારા ડોમેન બદલાય તેમ નવા એન્ટિટી (બ્રાન્ડ્સ, SKU, નિયમનકારી શરતો) ઉમેરો.
- પૂર્વગ્રહ ઘટાડવા માટે સમયાંતરે ઉચ્ચારો અને વસ્તી વિષયક માહિતીનું પુનઃસંતુલન કરો.
આ બંધ લૂપ ઘણીવાર "પૂરતી સારી" અને "બજાર-અગ્રણી" ભાષણ ઉત્પાદનો વચ્ચેનો સૌથી મોટો તફાવત છે.
[આ પણ વાંચો: અમારા ગુણવત્તાયુક્ત ભારતીય ભાષાના ઓડિયો ડેટાસેટ્સ સાથે AI મોડેલ્સને વિસ્તૃત કરો .]
શેપ કેવી રીતે મદદ કરી શકે છે
જો તમે "મને ખબર છે કે મને વધુ સારા ભાષણ ડેટાની જરૂર છે, પણ મને ખાતરી નથી કે ક્યાંથી શરૂઆત કરવી" ના તબક્કે છો , તો Shaip તમને મદદ કરી શકે છે:
- તમારા હાલના ડેટાસેટ્સનું ઑડિટ કરો અને ઓળખો કવરેજ ગેપ્સ
- પૂરું પાડો ઑફ-ધ-શેલ્ફ સ્પીચ રેકગ્નિશન ડેટાસેટ્સ 65+ ભાષાઓ અને ડઝનબંધ ડોમેન્સ (સ્ક્રિપ્ટેડ, કોલ સેન્ટર, વેક વર્ડ્સ, TTS, વગેરે) માં
- ડિઝાઇન અને અમલ કસ્ટમ ડેટા સંગ્રહ પ્રોગ્રામ્સ (રિમોટ, ઇન-કન્ટ્રી, મલ્ટી-ડિવાઇસ)
- હેન્ડલ ટીકા, ટ્રાન્સક્રિપ્શન, ગુણવત્તા નિયંત્રણ અને ઓળખ રદ કરવી એન્ડ-ટુ-એન્ડ
જેથી તમારી ટીમ મોડેલો અને ઉત્પાદનો પર ધ્યાન કેન્દ્રિત કરી શકે , જ્યારે અમે ખાતરી કરીએ છીએ કે તમારા AI પાસે ઉચ્ચ-ગુણવત્તાવાળા, સુસંગત ભાષણ ડેટા છે જે તેને સાંભળવા અને સમજવા માટે જરૂરી છે.