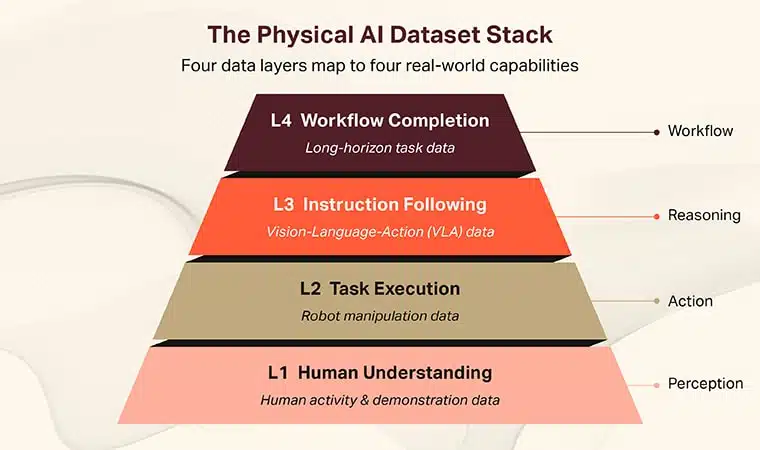
મોટાભાગની ભૌતિક AI ટીમો જાણે છે કે તેમને ડેટાની જરૂર છે. બહુ ઓછા લોકો જાણે છે કે તેમને તેનો એક સ્ટેક જોઈએ છે. તૈનાત હ્યુમનોઇડ, AV, અથવા વેરહાઉસ રોબોટને જે ક્ષમતાઓની જરૂર હોય છે - દ્રષ્ટિ, ક્રિયા, સૂચના અનુસરણ, બહુ-પગલાં વર્કફ્લો એક્ઝેક્યુશન - દરેક નકશા તાલીમ ડેટાના એક અલગ સ્તર પર, વિવિધ સંગ્રહ પદ્ધતિઓ, ટીકા ઊંડાઈ અને ગુણવત્તા નિયંત્રણો સાથે. ભૌતિક AI ડેટાસેટ સ્ટેક એ તે સ્તરોને ચાર ડિસ્કનેક્ટેડ પ્રાપ્તિ નિર્ણયોને બદલે એક સંકલિત સિસ્ટમ તરીકે વિચારવાનો એક માર્ગ છે.
કી ટેકવેઝ
- ભૌતિક AI ડેટાસેટ સ્ટેકમાં ચાર સ્તરો છે જે ચાર વાસ્તવિક-વિશ્વ ક્ષમતાઓ સાથે જોડાયેલા છે.
- સ્તર 1 માનવ પ્રવૃત્તિ અને દ્રષ્ટિ અને સમજણ માટે પ્રદર્શન ડેટાને આવરી લે છે.
- સ્તર 2 પુનરાવર્તિત કાર્ય અમલીકરણ માટે રોબોટ મેનિપ્યુલેશન ડેટા કેપ્ચર કરે છે.
- સ્તર 3, સ્કેલ પર અનુસરવામાં આવતી સૂચના માટે દ્રષ્ટિ, ભાષા અને ક્રિયાને સંરેખિત કરે છે.
- સ્તર 4 વાસ્તવિક વાતાવરણમાં લાંબા-ક્ષિતિજ, બહુ-પગલાંના કાર્ય પૂર્ણતાને સપોર્ટ કરે છે.
- દરેક સ્તર બીજા સ્તરને ખવડાવે છે; નીચેની નબળાઈઓ સ્ટેકમાં ફેલાય છે.
ભૌતિક AI ડેટાને સ્ટેક તરીકે શા માટે વિચારો?
ભૌતિક AI ડેટા એક સ્ટેક તરીકે વર્તે છે કારણ કે દરેક ક્ષમતા સ્તર તેની નીચેના સ્તરો પર આધાર રાખે છે. ક્રિયા ડેટા વિનાનો પર્સેપ્શન ડેટા એક મોડેલ બનાવે છે જે જુએ છે પણ ખસેડી શકતો નથી. ભાષા ગોઠવણી વિનાનો ક્રિયા ડેટા એક મોડેલ બનાવે છે જે ખસેડી શકે છે પણ સૂચનાઓનું પાલન કરી શકતો નથી. મજબૂત સૂચના વિના લાંબા-ક્ષિતિજ વર્કફ્લો ડેટા પ્રથમ બહુ-પગલાંના કાર્ય પર તૂટી પડે છે.
ડેવલપર સમુદાયને રજૂ કરાયેલ NVIDIA ના ઓપન ફિઝિકલ AI ડેટાસેટમાં અભૂતપૂર્વ વિવિધતા સાથે હજારો કલાકનો મલ્ટીકેમેરા વિડિયો શામેલ છે (NVIDIA, 2025), અને તે સ્કેલ પર પણ, ડાઉનસ્ટ્રીમ ટીમોને હજુ પણ તેની ઉપર પોતાના કાર્ય-વિશિષ્ટ સ્તરોની જરૂર છે. પ્રી-ટ્રેનિંગ ડેટા જરૂરી છે, પૂરતો નથી.
સ્તર ૧: માનવ સમજણ ડેટા શું આવરી લે છે?
માનવ સમજણનો ડેટા એ માનવ પ્રવૃત્તિ અને પ્રદર્શનનો ડેટા છે - વાસ્તવિક વાતાવરણમાં કાર્યો કરતા માનવોના પ્રથમ-વ્યક્તિ અને ત્રીજા-વ્યક્તિ ફૂટેજ. તે મોડેલને શીખવે છે કે વિશ્વ કેવું દેખાય છે અને માનવીઓ તેમાંથી કેવી રીતે આગળ વધે છે.
માનવ નિદર્શન ડેટા: કાર્યો કરતા માનવીઓના વિડિયો અને સેન્સર રેકોર્ડિંગ્સ, જેમાં એવી ટીકાઓ હોય છે જે અવલોકનોને ક્રિયાઓ, ઉદ્દેશ્યો અથવા પરિણામો સાથે સંરેખિત કરે છે.

આ સ્તર દ્રષ્ટિ, દ્રશ્ય સમજણ અને ઉદ્દેશ્ય અનુમાનને ફીડ કરે છે. પૂછવા માટેના ગુણવત્તાયુક્ત પ્રશ્નો:
- શું ડેટા તમારા રોબોટ જે વાતાવરણમાં કામ કરશે તેને આવરી લે છે?
- શું પ્રદર્શનો પરમાણુ-ક્રિયા સ્તરે નોંધાયેલા છે, અથવા ફક્ત પ્રતિ-ક્લિપ?
- શું સહભાગીની સંમતિ દસ્તાવેજીકૃત અને શોધી શકાય તેવી છે?
શેપનું L1 ડેટા કલેક્શન લેયર રસોડા, ફેક્ટરીઓ, વેરહાઉસ, આરોગ્યસંભાળ સુવિધાઓ અને રસ્તાઓ પર વાસ્તવિક દુનિયાની પ્રવૃત્તિને કેપ્ચર કરે છે - એવા વાતાવરણ જે પ્રયોગશાળાની પરિસ્થિતિઓને બદલે ડિપ્લોયમેન્ટ સંદર્ભો સાથે મેળ ખાય છે.
સ્તર 2: કાર્ય અમલીકરણ ડેટા શું આવરી લે છે?
કાર્ય અમલીકરણ ડેટા એ રોબોટ મેનિપ્યુલેશન ડેટા છે - પ્રક્ષેપણ, સંયુક્ત સ્થિતિઓ, ઑબ્જેક્ટ ક્રિયાપ્રતિક્રિયાઓ અને પુનરાવર્તિત ભૌતિક કાર્યો માટે સંપર્ક ગતિશીલતા. તે મોડેલને ફક્ત શું સમજવું તે જ નહીં, પણ કેવી રીતે કાર્ય કરવું તે શીખવે છે.
રોબોટ મેનિપ્યુલેશન ડેટા: ટેલિઓપરેશન, સ્ક્રિપ્ટેડ એક્ઝેક્યુશન અથવા ડેમોન્સ્ટ્રેશન રિપ્લે દરમિયાન કેપ્ચર કરાયેલ રોબોટ સ્ટેટ્સ, એન્ડ-ઇફેક્ટર પોઝ અને ઑબ્જેક્ટ ઇન્ટરેક્શનના ટાઇમ-સ્ટેમ્પ્ડ સિક્વન્સ.

આ તે જગ્યા છે જ્યાં મૂર્ત સ્વરૂપ-વિશિષ્ટ માળખું દેખાય છે. સંયુક્ત રૂપરેખાંકનો, ગ્રિપર ભૂમિતિઓ અને ક્રિયા સ્થાનો રોબોટ્સમાં બદલાય છે, તેથી મેનિપ્યુલેશન ડેટા ભાગ્યે જ પુનઃલક્ષ્યીકરણ વિના મૂર્ત સ્વરૂપોમાં પોર્ટેબલ હોય છે. ક્રોસ-એમ્બોડિમેન્ટ પ્રયાસો - જેમ કે ડેટાસેટ્સ એક ક્રિયા યોજના હેઠળ 22 રોબોટ મૂર્ત સ્વરૂપોને એકીકૃત કરે છે (ડીપમાઇન્ડ/સ્ટેનફોર્ડ એટ અલ., 2024) - આને થોડું સરળ બનાવ્યું છે, પરંતુ કાર્ય-વિશિષ્ટ મેનિપ્યુલેશન ડેટા એક વ્યવહારુ સંગ્રહ કાર્યક્રમ રહે છે.
સ્તર 3: VLA ડેટા શું ઉમેરે છે?
VLA ડેટા દ્રષ્ટિ અને ક્રિયામાં ભાષા સંરેખણ ઉમેરે છે - દરેક એપિસોડ તેને પૂર્ણ કરતા માર્ગ સાથે જોડાયેલ કુદરતી-ભાષા સૂચના ધરાવે છે.
વિઝન-લેંગ્વેજ-એક્શન (VLA) ડેટા: એપિસોડ-લેવલ તાલીમ ડેટા જેમાં સિંક્રનાઇઝ્ડ દ્રશ્ય અવલોકનો, કુદરતી-ભાષા સૂચનાઓ અને સફળતા લેબલ સાથે ક્રિયા માર્ગોનો સમાવેશ થાય છે.

આ સ્તર સૂચનાઓનું પાલન કરવાનું શક્ય બનાવે છે. તેના વિના, મેનિપ્યુલેશન મોડેલ એક પ્રશિક્ષિત કાર્યને અમલમાં મૂકી શકે છે; તેની સાથે, તે જ કરોડરજ્જુ સેંકડો સૂચનાઓમાં સામાન્યીકરણ કરી શકે છે. મુખ્ય મુદ્દો: ભાષા વર્ણનો અણુ, ચોક્કસ અને વાસ્તવિક ક્રિયા સીમાઓ સાથે સંરેખિત હોવા જોઈએ - અસ્પષ્ટ સારાંશ નહીં. આ સ્તર પર ટીકાની ચોકસાઇ નક્કી કરે છે કે ફાઇન-ટ્યુન કરેલ VLA નવા પ્રોમ્પ્ટ્સને સામાન્ય બનાવે છે કે તાલીમ સેટને યાદ રાખે છે.
સ્તર 4: લાંબા ક્ષિતિજ કાર્ય ડેટા શું આવરી લે છે?
લાંબા-ક્ષિતિજ કાર્ય ડેટા બહુ-પગલાંના કાર્યપ્રવાહને આવરી લે છે - એવા ક્રમ જ્યાં રોબોટે બીજું શરૂ કરવા માટે એક પેટા-કાર્ય પૂર્ણ કરવું આવશ્યક છે. ભોજન રાંધવા, વેરહાઉસ પેલેટને સૉર્ટ કરવા અને કીટ એસેમ્બલ કરવા એ લાંબા-ક્ષિતિજ કાર્યો છે. દરેક મોડેલને સ્થિતિને ટ્રેક કરવા, પેટા-કાર્ય નિષ્ફળતામાંથી પુનઃપ્રાપ્ત કરવા અને સાંકળ કુશળતાની જરૂર પડે છે.

લાંબા-ક્ષિતિજ ટેબલટોપ મેનીપ્યુલેશન પર ધ્યાન કેન્દ્રિત કરતા એક સંશોધન ડેટાસેટમાં 20 બહુ-પગલાંના કાર્યોમાં 200 એપિસોડનો સમાવેશ થાય છે જેમાં અવ્યવસ્થિત દ્રશ્યો હોય છે (LHManip લેખકો, arXiv, 2024) — નાના પાયે પણ ચુસ્ત રીતે રચાયેલ. ઉત્પાદન ટીમો સામાન્ય રીતે સેંકડોથી હજારો લાંબા-ક્ષિતિજ એપિસોડ સાથે મૂલ્યાંકન સેટ બનાવે છે, ઉપરાંત નિષ્ફળતા પુનઃપ્રાપ્તિ માટે અપવાદ-હેન્ડલિંગ ટ્રેસ.
ચાર સ્તરો ડિપ્લોયમેન્ટ કેવી રીતે ફીડ કરે છે