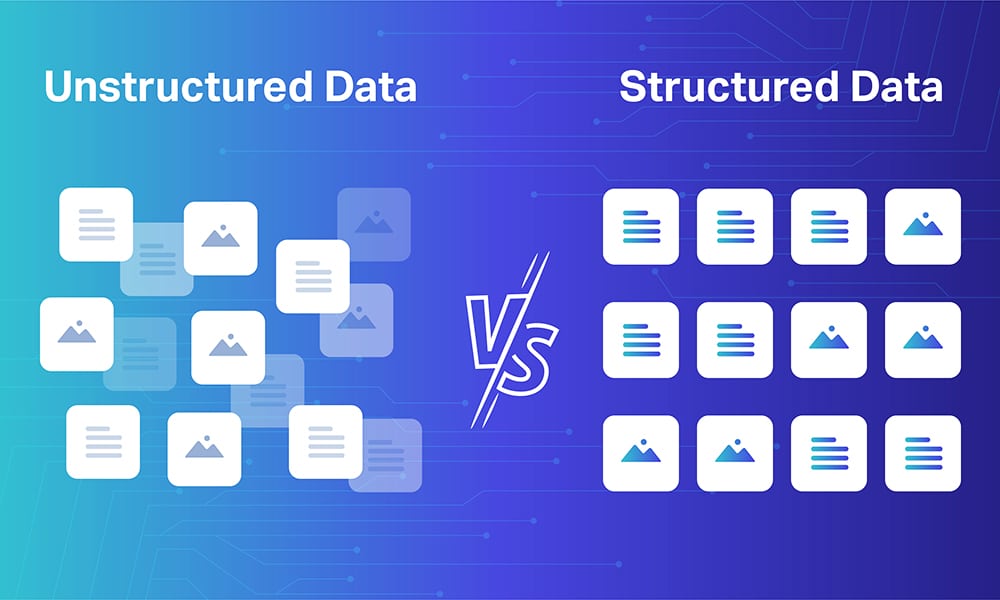

એન્ટરપ્રાઇઝ AI ના મૂળમાં એક શાંત વિડંબના રહેલી છે: જો તમારો ડેટા સ્કેન કરેલા ઇન્વોઇસ, ફેક્સ કરેલા લેબ રિપોર્ટ અથવા હસ્તલિખિત ડિલિવરી નોટમાં ફસાઈ ગયો હોય તો વિશ્વના સૌથી સ્માર્ટ મોડેલો તમને મદદ કરી શકશે નહીં. અને અંદાજે 80% વ્યવસાય ડેટા બરાબર આ પ્રકારના અનસ્ટ્રક્ચર્ડ દસ્તાવેજોમાં રહે છે.
ઓપ્ટિકલ કેરેક્ટર રેકગ્નિશન - OCR - એ ટેકનોલોજી છે જે ડેટાને મુક્ત કરે છે. અને 2026 માં, તે એક ક્ષણનો અનુભવ કરી રહી છે. વૈશ્વિક OCR બજાર 2033 સુધીમાં $55.3 બિલિયન સુધી પહોંચવાનો અંદાજ છે, જે 2023 માં $13.1 બિલિયન હતું, જે વાર્ષિક 15.5% ના દરે વધશે. આધુનિક એન્જિનો નિયમિતપણે પૃષ્ઠ સ્તરે 98-99% ચોકસાઈ સુધી પહોંચે છે. જે એક સમયે અણઘડ સ્કેનિંગ ઉપયોગિતા હતી તે એન્ટરપ્રાઇઝ ઓટોમેશનનો મુખ્ય દરવાજો બની ગઈ છે.
આજે OCR કેવું દેખાય છે તે અહીં છે: તે કેવી રીતે કાર્ય કરે છે, અસ્તિત્વમાં છે તે પ્રકારો, AI માં શું ફેરફાર થયો છે અને તે ક્યાં જઈ રહ્યું છે.
OCR શું છે?
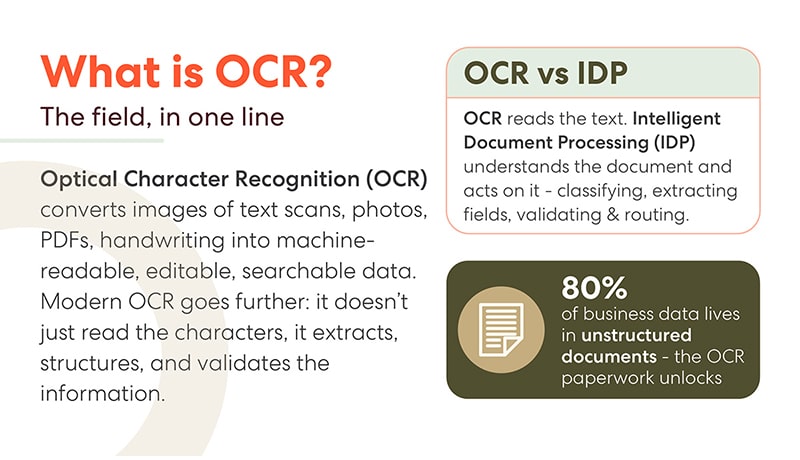
ઓપ્ટિકલ કેરેક્ટર રેકગ્નિશન ટેક્સ્ટની છબીઓને - સ્કેન, ફોટા, પીડીએફ, હસ્તલેખન - મશીન-વાંચી શકાય તેવા, સંપાદનયોગ્ય, શોધી શકાય તેવા ડેટામાં રૂપાંતરિત કરે છે. તે પાઠ્યપુસ્તકની વ્યાખ્યા છે, અને તે 2026 માં ખરેખર શું થઈ રહ્યું છે તે ઓછું દર્શાવે છે.
આધુનિક OCR ફક્ત અક્ષરો વાંચતું નથી. તે સ્ટ્રક્ચર્સ - ફીલ્ડ્સ, ટેબલ્સ, લાઇન આઇટમ્સ - ને કાઢે છે અને તે જે માહિતી ખેંચે છે તેને માન્ય કરે છે. તેને ફોન પર ફોટોગ્રાફ કરાયેલ એક ચોળાયેલું ઇન્વોઇસ ફીડ કરો, અને તે ટેક્સ્ટનો ટુકડો નહીં પણ એક સ્ટ્રક્ચર્ડ રેકોર્ડ આપે છે: વિક્રેતા, તારીખ, લાઇન આઇટમ્સ, કુલ, દરેક આત્મવિશ્વાસ સ્કોર સાથે.
OCR વિરુદ્ધ IDP: એક મહત્વપૂર્ણ ભેદ
દરેક વિક્રેતા વાતચીતમાં તમને બંને શબ્દો સાંભળવા મળશે, તેથી અહીં તફાવત છે. OCR ટેક્સ્ટ વાંચે છે. ઇન્ટેલિજન્ટ ડોક્યુમેન્ટ પ્રોસેસિંગ (IDP) દસ્તાવેજને સમજે છે અને તેના પર કાર્ય કરે છે - તે કયા પ્રકારનો દસ્તાવેજ છે તેનું વર્ગીકરણ કરે છે, મહત્વપૂર્ણ ક્ષેત્રો કાઢે છે, તેમને વ્યવસાયિક નિયમો સામે માન્ય કરે છે અને પરિણામને યોગ્ય સિસ્ટમ પર રૂટ કરે છે.
OCR ને આંખો અને IDP ને મગજ માનો. એક વગર બીજા તમને ફક્ત અડધે રસ્તે લઈ જાય છે: સંપૂર્ણ રીતે ટ્રાન્સક્રિપ્ટેડ ટેક્સ્ટ જેને અર્થઘટન કરવા માટે હજુ પણ માણસની જરૂર હોય છે, અથવા વાંચી શકાય તેવા ઇનપુટથી અછતગ્રસ્ત સ્માર્ટ વર્કફ્લો. બજાર નિર્ણાયક રીતે આ સંયોજન તરફ આગળ વધી રહ્યું છે.
OCR કેવી રીતે કાર્ય કરે છે: આધુનિક 6-પગલાની પાઇપલાઇન
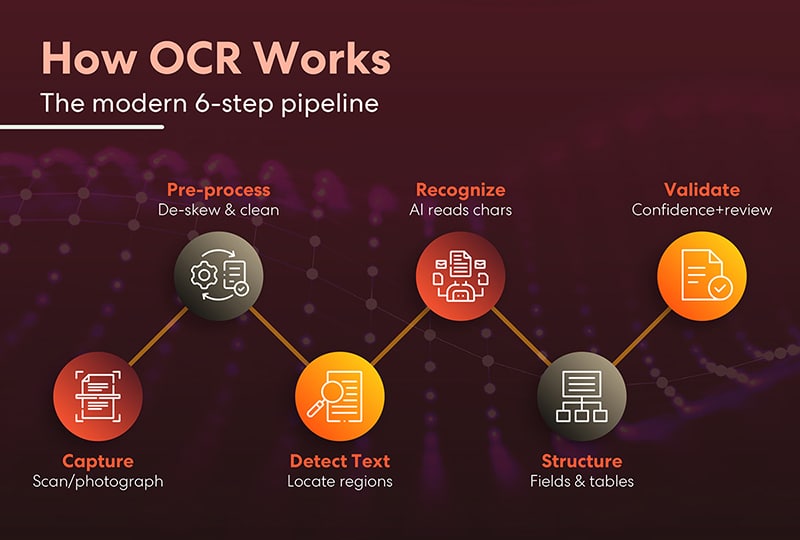
આજની OCR સિસ્ટમો છ-તબક્કાની પાઇપલાઇનને અનુસરે છે, અને તેને સમજવાથી ચોકસાઈ શા માટે વધી છે અને ભૂલો હજુ પણ ક્યાં રહે છે તે બંને સમજાવવામાં મદદ મળે છે.
તે કેપ્ચરથી શરૂ થાય છે — દસ્તાવેજનો સ્કેન અથવા ફોટોગ્રાફ. પછી પ્રી-પ્રોસેસિંગ છબીને સાફ કરે છે: નમેલા પૃષ્ઠોને ડી-સ્ક્યુ કરે છે, અવાજ દૂર કરે છે અને કોન્ટ્રાસ્ટ સુધારે છે, કારણ કે ઓળખ ગુણવત્તા તે છબી જેટલી જ સારી છે જેમાંથી તે શરૂ થાય છે. આગળ, ટેક્સ્ટ ડિટેક્શન પૃષ્ઠના તે પ્રદેશોને શોધે છે જેમાં ખરેખર ટેક્સ્ટ હોય છે, શબ્દોને લોગો, સ્ટેમ્પ્સ અને પૃષ્ઠભૂમિથી અલગ કરે છે. પછી ઓળખ આવે છે , જ્યાં AI અક્ષરો વાંચે છે — તે પગલું જેને મોટાભાગના લોકો "OCR" માને છે. પરંતુ આધુનિક પાઇપલાઇન ત્યાં અટકતી નથી. કાચા ટેક્સ્ટને ક્ષેત્રો અને કોષ્ટકોમાં નકશા બનાવવાનું , "પૃષ્ઠ પરના શબ્દો" ને "સ્કીમામાં ડેટા" માં ફેરવવાનું. અંતે, માન્યતા આત્મવિશ્વાસ સ્કોરિંગ અને સમીક્ષા લાગુ કરે છે, જે તમારી સિસ્ટમમાં પ્રવેશતા પહેલા માનવ માટે અનિશ્ચિત કંઈપણને ફ્લેગ કરે છે.
કેપ્ચર → પ્રી-પ્રોસેસ → ડિટેક્ટ → રેકગ્નિશન → સ્ટ્રક્ચર → વેલિડેટ. છેલ્લા બે પગલાં એ છે જે 2026-યુગના OCR ને એક દાયકા પહેલાના સ્કેનિંગ સોફ્ટવેરથી અલગ પાડે છે.
OCR ના પ્રકાર: બધી ઓળખ સમાન હોતી નથી
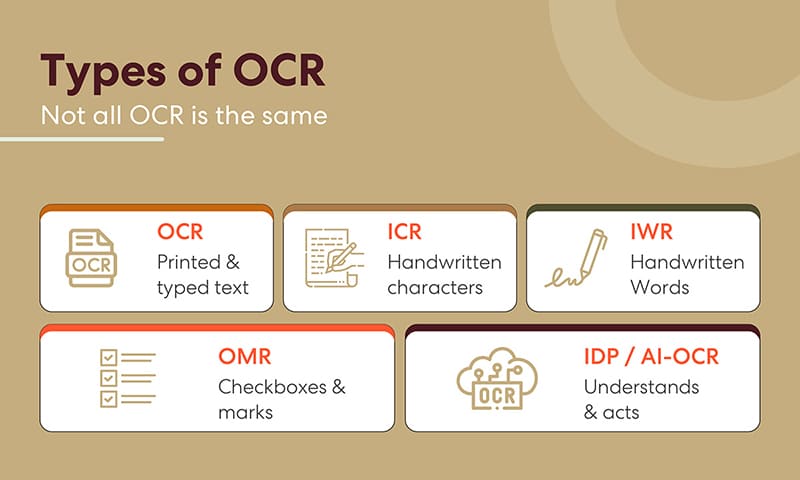
"OCR" શબ્દનો ઉપયોગ સામાન્ય શબ્દ તરીકે થાય છે, પરંતુ આ ક્ષેત્ર ઘણી તકનીકોને અલગ પાડે છે, જે દરેક અલગ સામગ્રી માટે યોગ્ય છે.
OCR યોગ્ય રીતે છાપેલા અને ટાઇપ કરેલા ટેક્સ્ટને હેન્ડલ કરે છે — સૌથી સરળ કેસ અને સૌથી પરિપક્વ. ICR (ઇન્ટેલિજન્ટ કેરેક્ટર રેકગ્નિશન) હસ્તલિખિત અક્ષરો વાંચે છે, જે ક્ષેત્રની સૌથી મુશ્કેલ સમસ્યાઓમાંની એક છે. IWR (ઇન્ટેલિજન્ટ વર્ડ રેકગ્નિશન) એક ડગલું આગળ વધે છે, વ્યક્તિગત અક્ષરોને બદલે સંપૂર્ણ હસ્તલિખિત શબ્દોને ઓળખે છે — કર્સિવ માટે વધુ યોગ્ય છે, જ્યાં અક્ષરો એકસાથે ઝાંખા પડે છે. OMR (ઓપ્ટિકલ માર્ક રેકગ્નિશન) ચેકબોક્સ અને માર્ક્સ વાંચે છે, ફોર્મ્સ અને જવાબ પત્રકો પાછળની ટેકનોલોજી. અને IDP / AI-OCR સ્ટેકની ટોચ પર બેસે છે: એવી સિસ્ટમો જે ફક્ત વાંચતી નથી પણ સમજે છે અને કાર્ય કરે છે.
કોઈપણ OCR પ્રોજેક્ટનો પહેલો પ્રશ્ન એ છે કે તમારા કયા પ્રકારના દસ્તાવેજોની જરૂર છે તે જાણવું. પ્રિન્ટેડ ઇન્વોઇસ અને ડૉક્ટરનું હસ્તલિખિત પ્રિસ્ક્રિપ્શન સંપૂર્ણપણે અલગ સમસ્યાઓ છે.
AI યુગમાં OCR: કાચો OCR હવે ફક્ત એક પગલું છે
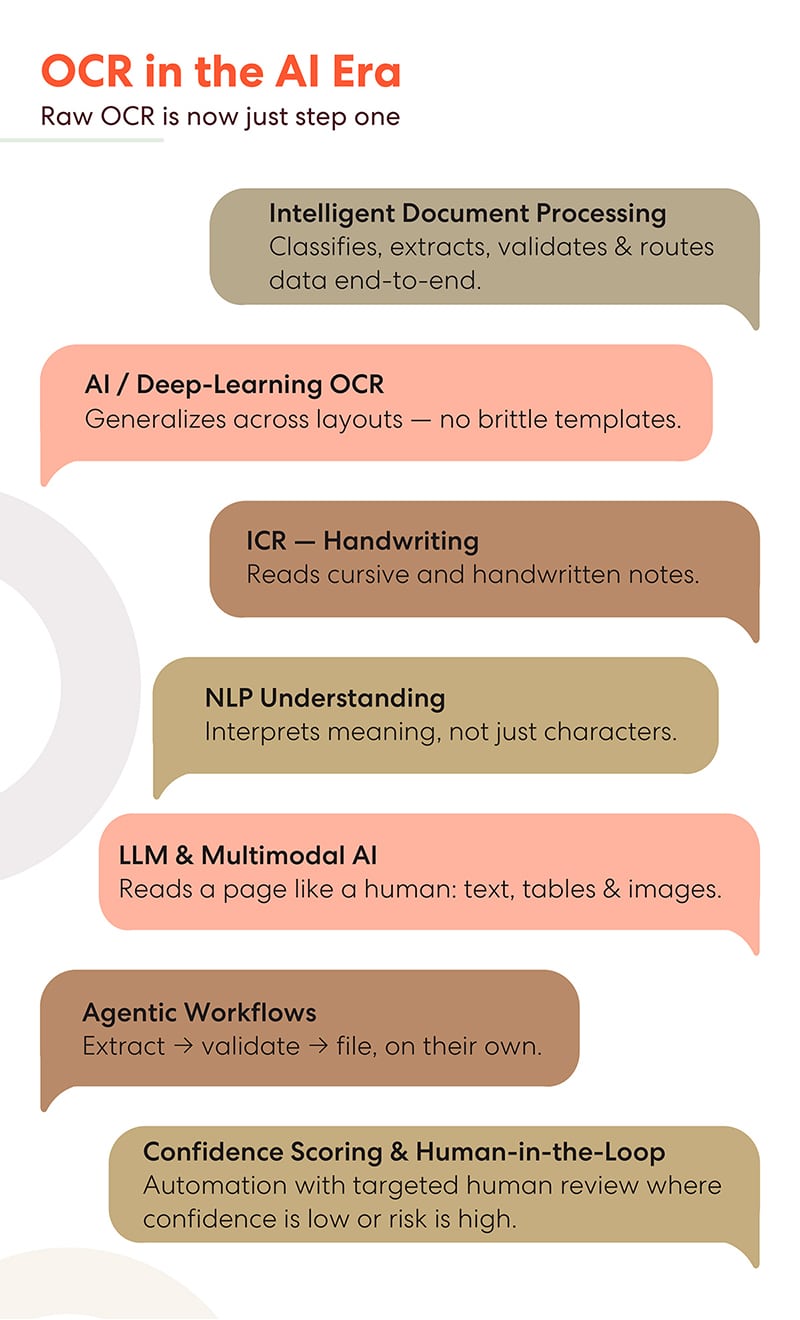
આ ક્ષેત્રમાં સૌથી ઊંડો ફેરફાર એ છે કે પાત્ર ઓળખ - એક સમયે આખું ઉત્પાદન - હવે ફક્ત પ્રવેશ બિંદુ છે. સાત ક્ષમતાઓ આધુનિક દસ્તાવેજ AI ને વ્યાખ્યાયિત કરે છે.
ઇન્ટેલિજન્ટ ડોક્યુમેન્ટ પ્રોસેસિંગ સંપૂર્ણ સફર શરૂથી અંત સુધી ચલાવે છે: દસ્તાવેજોનું વર્ગીકરણ કરવું, ફીલ્ડ્સ કાઢવા, ડેટા માન્ય કરવો અને મેન્યુઅલ હેન્ડઓફ વિના પરિણામોને રૂટ કરવું.
AI અને ડીપ-લર્નિંગ OCR લેઆઉટમાં સામાન્યીકરણ કરે છે. જૂની સિસ્ટમોને દરેક દસ્તાવેજ ફોર્મેટ માટે એક નાજુક ટેમ્પ્લેટની જરૂર હતી; આધુનિક મોડેલો એક ઇન્વોઇસ હેન્ડલ કરે છે જે તેમણે પહેલાં ક્યારેય જોયું નથી, કારણ કે તેઓએ શીખ્યા છે કે સામાન્ય રીતે ઇન્વોઇસ કેવા દેખાય છે.
ICR હસ્તલેખન ઓળખ એટલી પરિપક્વ થઈ ગઈ છે કે તે કર્સિવ અને હસ્તલિખિત નોંધો વાંચી શકે છે - તબીબી રેકોર્ડ્સ, ડિલિવરી સ્લિપ્સ અને આર્કાઇવલ દસ્તાવેજોને અનલૉક કરી શકે છે જે અગાઉ મર્યાદાની બહાર હતા.
NLP સમજણ ફક્ત અક્ષરોનું જ નહીં, પણ અર્થનું અર્થઘટન કરે છે. સિસ્ટમ ફક્ત "નેટ 30" નું ટ્રાન્સક્રિપ્શન કરતી નથી - તે જાણે છે કે તે ચુકવણી શબ્દ છે.
LLM અને મલ્ટિમોડલ AI એક પૃષ્ઠને માનવીની જેમ વાંચે છે: ટેક્સ્ટ, કોષ્ટકો અને છબીઓ એકસાથે, સંદર્ભમાં. આ સ્ટેકનું સૌથી નવું અને સૌથી ઝડપી ગતિશીલ સ્તર છે.
એજન્ટિક વર્કફ્લો લૂપ બંધ કરે છે: એક્સટ્રેક્ટ → માન્ય → ફાઇલ, સ્વાયત્ત રીતે. દસ્તાવેજ ફક્ત વાંચવામાં આવતો નથી; તે હેન્ડલ થાય છે.
હ્યુમન-ઇન-ધ-લૂપ સાથે કોન્ફિડન્સ સ્કોરિંગ આ બધું ઉપયોગમાં લેવાનું સલામત બનાવે છે. જ્યાં આત્મવિશ્વાસ વધારે હોય ત્યાં ઓટોમેશન આગળ વધે છે; જ્યાં આત્મવિશ્વાસ ઓછો હોય અથવા જોખમ વધારે હોય ત્યાં જ માનવીઓ સમીક્ષા કરે છે. તે લક્ષિત-સમીક્ષા મોડેલ એ છે કે કેવી રીતે સાહસો ગતિ અને ઑડિટેબિલિટી બંને મેળવે છે.
OCR ઉપયોગના કિસ્સાઓ: જ્યાં તે મૂલ્ય પહોંચાડે છે
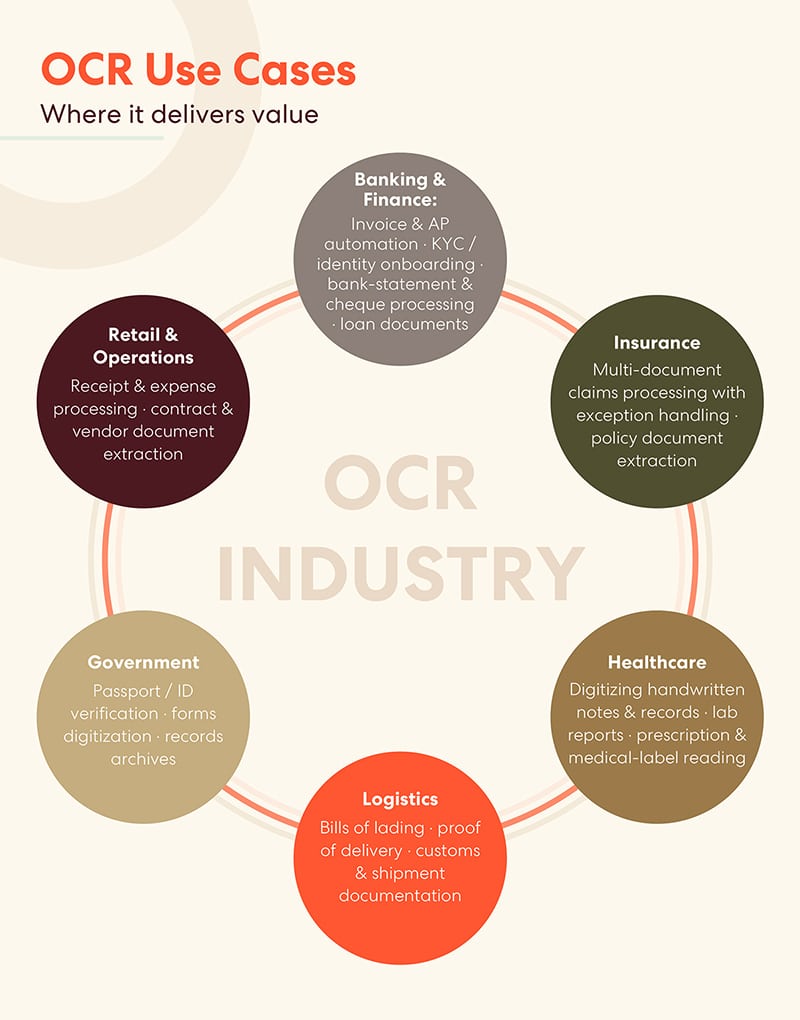
જે ઉદ્યોગો સૌથી ઝડપથી OCR અપનાવે છે તે કાગળમાં ડૂબી જાય છે.
બેંકિંગ અને ફાઇનાન્સ બજારમાં આગળ છે - ઇન્વોઇસ અને એપી ઓટોમેશન, કેવાયસી અને ઓળખ ઓનબોર્ડિંગ, બેંક સ્ટેટમેન્ટ અને ચેક પ્રોસેસિંગ. એ કોઈ અકસ્માત નથી કે BFSI સૌથી મોટું OCR વર્ટિકલ છે, જે બજારના આશરે 21% હિસ્સો ધરાવે છે. વીમા તેનો ઉપયોગ અપવાદ હેન્ડલિંગ અને પોલિસી દસ્તાવેજ નિષ્કર્ષણ સાથે બહુ-દસ્તાવેજ દાવાઓની પ્રક્રિયા માટે કરે છે - એક જ દાવામાં વિવિધ ફોર્મેટમાં ડઝનેક દસ્તાવેજો શામેલ હોઈ શકે છે. આરોગ્યસંભાળમાં , OCR હસ્તલિખિત નોંધો અને રેકોર્ડ્સને ડિજિટાઇઝ કરે છે, લેબ રિપોર્ટ્સ વાંચે છે અને પ્રિસ્ક્રિપ્શનો અને તબીબી લેબલોની પ્રક્રિયા કરે છે, જ્યાં ચોકસાઈ શાબ્દિક રીતે સલામતીનો મુદ્દો છે. લોજિસ્ટિક્સ દસ્તાવેજો પર ચાલે છે - બિલ ઓફ લેડિંગ, ડિલિવરીનો પુરાવો, કસ્ટમ્સ અને શિપમેન્ટ પેપરવર્ક - અને OCR કાગળને અવરોધ બનતા અટકાવીને માલને ખસેડતું રહે છે. સરકાર તેને પાસપોર્ટ અને ID ચકાસણી, ફોર્મ પ્રોસેસિંગ અને રેકોર્ડ આર્કાઇવ્સને ડિજિટાઇઝ કરવા માટે લાગુ કરે છે. અને રિટેલ અને કામગીરીમાં , તે રસીદ અને ખર્ચ પ્રક્રિયા અને કરાર અને વિક્રેતા દસ્તાવેજ નિષ્કર્ષણને સત્તા આપે છે.
છેયમાં પેટર્ન: જ્યાં પણ માણસ કાગળમાંથી માહિતીને સિસ્ટમમાં ફરીથી ટાઇપ કરતો હતો, OCR હવે તે ઝડપી, સસ્તું અને ઓડિટ ટ્રેઇલ સાથે કરે છે.
ફાયદા અને પડકારો: પ્રામાણિક ચિત્ર
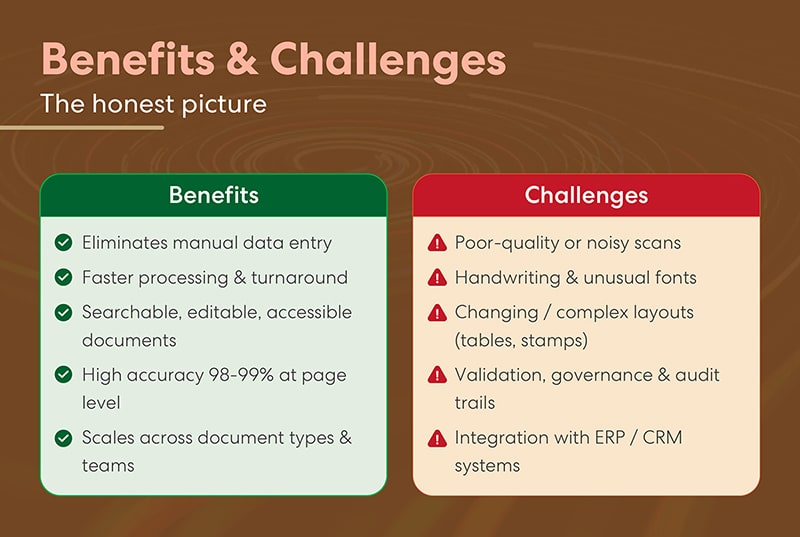
ફાયદા ચોક્કસ છે. OCR મેન્યુઅલ ડેટા એન્ટ્રીને દૂર કરે છે - કોઈપણ બેક ઓફિસમાં સૌથી વધુ ભૂલ-સંભવિત, સૌથી ઓછી પ્રિય નોકરી. પ્રક્રિયા અને ટર્નઅરાઉન્ડ નાટકીય રીતે ઝડપી બને છે. દસ્તાવેજો ડેડ સ્કેનને બદલે શોધી શકાય તેવા, સંપાદનયોગ્ય અને સુલભ બને છે. ચોકસાઈ હવે પૃષ્ઠ સ્તરે 98-99% સુધી પહોંચે છે. અને આધુનિક સિસ્ટમો અજાણ્યા કોઈપણ વસ્તુ પર ગૂંગળામણ કરવાને બદલે દસ્તાવેજ પ્રકારો અને ફોર્મેટમાં સ્કેલ કરે છે.
પરંતુ વાસ્તવિક ડિપ્લોયમેન્ટ હજુ પણ વાસ્તવિક સમસ્યાઓનો સામનો કરે છે. નબળી-ગુણવત્તાવાળા અથવા ઘોંઘાટીયા સ્કેન નંબર-વન ચોકસાઈ કિલર રહે છે - કોઈ મોડેલ જે વાંચી શકાતું નથી તે વાંચતું નથી. હસ્તલેખન અને અસામાન્ય ફોન્ટ્સ હજુ પણ છાપેલા ટેક્સ્ટને અનુસરે છે. બદલાતા અને જટિલ લેઆઉટ - નેસ્ટેડ ટેબલ, સ્ટેમ્પ્સ, મલ્ટી-કૉલમ ફોર્મ્સ - ટ્રિપ અપ એક્સટ્રેક્શન. માન્યતા, શાસન અને ઑડિટ ટ્રેલ્સ માટે વાસ્તવિક એન્જિનિયરિંગ પ્રયાસની જરૂર પડે છે, ખાસ કરીને નિયમન કરાયેલ ઉદ્યોગોમાં. અને ERP અને CRM સિસ્ટમ્સ સાથે સંકલન એ છે જ્યાં ઘણા પ્રોજેક્ટ્સ અટકે છે: ડેટા એક્સટ્રેક્ટિંગ ફક્ત ત્યારે જ ઉપયોગી છે જો તે ત્યાં પહોંચે જ્યાં ખરેખર કામ થાય છે.
આમાંથી કોઈ પણ ડીલ બ્રેકર્સ નથી. કોન્ફિડન્સ સ્કોરિંગ અને હ્યુમન-ઇન-ધ-લૂપ રિવ્યૂ અસ્તિત્વમાં છે તેનું કારણ એ છે કે - અને દસ્તાવેજની ગુણવત્તા અને સારી રીતે ટીકા કરાયેલ તાલીમ ડેટા મોડેલ પસંદગી જેટલું જ મહત્વપૂર્ણ છે.
OCR બજાર: સ્ત્રોત અને વર્તમાન
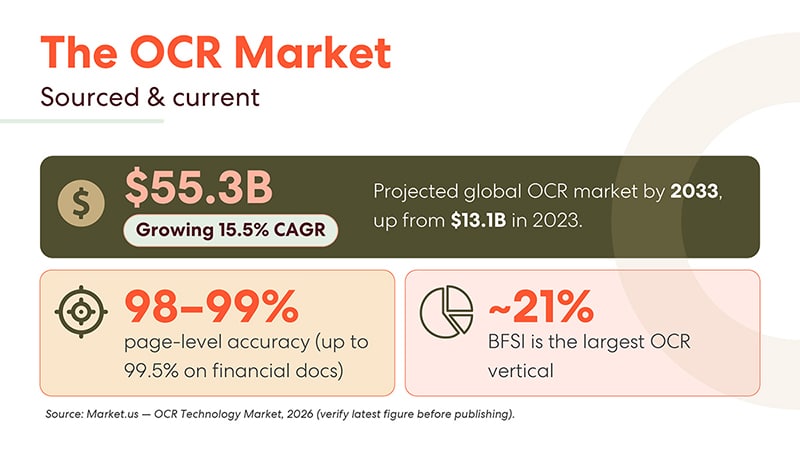
આંકડા તકને ફ્રેમ કરે છે. વૈશ્વિક OCR બજાર 2033 સુધીમાં $55.3 બિલિયન સુધી પહોંચવાનો અંદાજ છે , જે 2023 માં $13.1 બિલિયન હતું - જે 15.5% CAGR છે . પૃષ્ઠ-સ્તરની ચોકસાઈ 98-99% સુધી પહોંચી ગઈ છે , જે નાણાકીય દસ્તાવેજો પર હજુ પણ વધુ ઉપર છે. અને BFSI બજારના ~21% સાથે સૌથી મોટું વર્ટિકલ છે , જે દર્શાવે છે કે ROI ક્યાં પ્રથમ સાબિત થઈ રહ્યું છે.
આગળ શું છે: 2026 માટે OCR વલણો
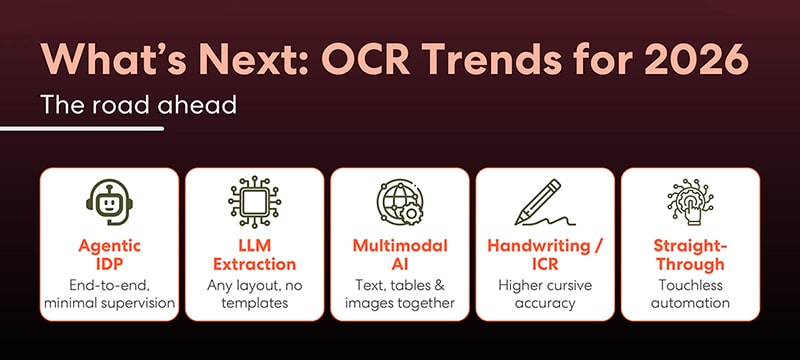
પાંચ વલણો આગળના માર્ગને વ્યાખ્યાયિત કરે છે. એજન્ટિક IDP — દસ્તાવેજ વર્કફ્લો જે સુખી માર્ગ પર કોઈ માનવ સ્પર્શ વિના એન્ડ-ટુ-એન્ડ ચાલે છે. LLM-સંચાલિત નિષ્કર્ષણ — નાના અથવા કોઈ ટેમ્પ્લેટ સેટઅપ વિના દસ્તાવેજોમાંથી સ્ટ્રક્ચર્ડ ડેટા ખેંચવા માટે મોટા ભાષા મોડેલોનો ઉપયોગ કરે છે. મલ્ટિમોડલ AI — મોડેલો જે ટેક્સ્ટ, કોષ્ટકો અને છબીઓને એક જ પાસમાં પ્રક્રિયા કરે છે, દસ્તાવેજોને ટુકડાઓ કરતાં સંપૂર્ણ રીતે સમજે છે. હસ્તલેખન અને ICR પ્રગતિ કરે છે — કર્સિવ અને અવ્યવસ્થિત હસ્તલેખન પર સતત વધતી ચોકસાઈ, દસ્તાવેજ વર્ગો ખોલવા જે અગાઉ ફક્ત મેન્યુઅલ-ફક્ત હતા. અને સીધી પ્રક્રિયા — અંતિમ ધ્યેય: દસ્તાવેજો જે પહોંચે છે, વાંચવામાં આવે છે, માન્ય થાય છે અને શૂન્ય માનવ સ્પર્શ સાથે ફાઇલ કરવામાં આવે છે.
દિશા સ્પષ્ટ છે: દસ્તાવેજો વાંચવાથી લઈને તેમને સંભાળવા સુધી.
આ બોટમ લાઇન
2026 માં OCR હવે ચિત્રોને ટેક્સ્ટમાં ફેરવવા વિશે નથી - તે કાગળકામને પૂર્ણ કાર્યમાં ફેરવવા વિશે છે. 80% વ્યવસાય ડેટા અનસ્ટ્રક્ચર્ડ દસ્તાવેજોમાં બંધ છે અને બજાર $55 બિલિયન તરફ વધી રહ્યું છે, મોટાભાગની સંસ્થાઓ માટે પ્રશ્ન એ નથી કે OCR અપનાવવો કે નહીં, પરંતુ સ્ટેક કેટલું આગળ વધવું તે છે: સાદા ટેક્સ્ટ નિષ્કર્ષણ, સ્ટ્રક્ચર્ડ IDP, અથવા સંપૂર્ણપણે એજન્ટિક દસ્તાવેજ વર્કફ્લો.
દસ્તાવેજોનો ઢગલો થઈ રહ્યો છે. તેમને વાંચવા અને તેમના પર કાર્યવાહી કરવા માટેની ટેકનોલોજી તૈયાર છે.