

નામવાળી એન્ટિટી ઓળખાણ ટેક્સ્ટના સ્પાન્સને પૂર્વવ્યાખ્યાયિત શ્રેણીઓમાં ઓળખે છે અને વર્ગીકૃત કરે છે. નામવાળી એન્ટિટી ઓળખાણ એ કુદરતી ભાષા પ્રક્રિયા (NLP) તકનીક છે જે સાદા ટેક્સ્ટમાં મુખ્ય તથ્યો શોધે છે અને તે શું છે તે લેબલ કરે છે - વ્યક્તિ, સંસ્થા, સ્થળ, તારીખ અથવા ડોલર રકમ. નામવાળી એન્ટિટી ઓળખાણ (NER) એ NLP કાર્ય છે જે અનસ્ટ્રક્ચર્ડ ટેક્સ્ટમાં "નામવાળી એન્ટિટી" ને શોધી કાઢે છે અને તેમને પૂર્વવ્યાખ્યાયિત શ્રેણીઓમાં સૉર્ટ કરે છે. "NER પૂર્ણ સ્વરૂપ" ને ફક્ત એન્ટિટી ઓળખ નામ આપવામાં આવ્યું છે, અને તે મશીનો કાચી ભાષાને સંરચિત, ઉપયોગી ડેટામાં કેવી રીતે રૂપાંતરિત કરે છે તેના હૃદયમાં બેસે છે.
આ હવે કેમ મહત્વનું છે? કારણ કે ટેક્સ્ટની અંદર રહેલું મૂલ્ય વિસ્ફોટ થઈ રહ્યું છે. 2024 માં વૈશ્વિક NLP બજારનું મૂલ્ય USD 59.70 બિલિયન હતું અને 2030 સુધીમાં USD 439.85 બિલિયન સુધી પહોંચવાનો અંદાજ છે, જે 38.7% CAGR છે (ગ્રાન્ડ વ્યૂ રિસર્ચ, 2024) . NER એ વૃદ્ધિને આગળ ધપાવતા વર્કહોર્સ કાર્યોમાંનું એક છે, જે શાંતિથી સર્ચ એન્જિન, ચેટબોટ્સ અને ક્લિનિકલ ડેટા પાઇપલાઇન્સને શક્તિ આપે છે.
NER ને એક હાઇલાઇટર તરીકે વિચારો જે એકસાથે બે કામ કરે છે: તે મહત્વપૂર્ણ શબ્દોને ચિહ્નિત કરે છે અને હાંસિયામાં એક નોંધ લખે છે જેમાં દરેક શું છે તે જણાવે છે. એક માણસ સહજ રીતે આ કરે છે. "સ્ટીવ જોબ્સ" સાંભળો અને તમે તરત જ એપલ, કેલિફોર્નિયા નામના વ્યક્તિ સાથે જોડાઓ. કમ્પ્યુટરમાં આવી કોઈ વૃત્તિ હોતી નથી - તેને તે શ્રેણીઓ જોવા માટે તાલીમ આપવી પડે છે, અને તે તાલીમ એ છે જ્યાં ગુણવત્તાયુક્ત ડેટા ભારે ઉપાડ કરે છે.
આરોગ્યસંભાળમાં, ક્લિનિકલ NER અનસ્ટ્રક્ચર્ડ નોટ્સમાંથી પરિસ્થિતિઓ, દવાઓ, ડોઝ, પ્રક્રિયાઓ, એનાટોમિકલ સાઇટ્સ, લેબ મૂલ્યો અને ટેમ્પોરલ અભિવ્યક્તિઓ કાઢે છે, પછી તેમને ICD-10-CM, CPT, SNOMED CT અને RxNorm જેવા ધોરણો અનુસાર સામાન્ય બનાવે છે જેથી આઉટપુટ મશીન-વાંચી શકાય અને ઑડિટેબલ હોય.
કી ટેકવેઝ
- NER ટેક્સ્ટમાં વ્યક્તિઓ, સંસ્થાઓ, સ્થાનો, તારીખો - ને ઓળખે છે અને વર્ગીકૃત કરે છે.
- "NER પૂર્ણ સ્વરૂપ" ને એન્ટિટી રેકગ્નિશન કહેવામાં આવે છે, જે એક મુખ્ય NLP કાર્ય છે.
- આધુનિક NER મોટે ભાગે ડીપ લર્નિંગ અને BERT જેવા ટ્રાન્સફોર્મર મોડેલો પર આધાર રાખે છે.
- BIO અને IOBES જેવી ટેગિંગ યોજનાઓ દરેક એન્ટિટી ક્યાં શરૂ થાય છે અને ક્યાં સમાપ્ત થાય છે તે ચિહ્નિત કરે છે.
- NER ગુણવત્તા ઉચ્ચ-ગુણવત્તાવાળા, સારી રીતે નોંધાયેલા તાલીમ ડેટા પર આધાર રાખે છે.
- સામાન્ય ઉપયોગો: શોધ, ચેટબોટ્સ, આરોગ્યસંભાળ રેકોર્ડ્સ, નાણાં અને કાનૂની સમીક્ષા.
નેમ્ડ એન્ટિટી રેકગ્નિશન (NER) શું છે?
નામવાળી એન્ટિટી રેકગ્નિશન એ નેચરલ લેંગ્વેજ પ્રોસેસિંગનો એક ભાગ છે. NER નો પ્રાથમિક ઉદ્દેશ્ય સ્ટ્રક્ચર્ડ અને અનસ્ટ્રક્ચર્ડ ડેટા પર પ્રક્રિયા કરવાનો અને આ નામવાળી એન્ટિટીઓને પૂર્વવ્યાખ્યાયિત શ્રેણીઓમાં વર્ગીકૃત કરવાનો છે. કેટલીક સામાન્ય શ્રેણીઓમાં નામ, સ્થાન, કંપની, સમય, નાણાકીય મૂલ્યો, ઘટનાઓ અને વધુનો સમાવેશ થાય છે.
ટૂંકમાં, NER નીચેની બાબતો સાથે વ્યવહાર કરે છે:
- નામવાળી એન્ટિટી ઓળખ/શોધ - દસ્તાવેજમાં શબ્દ અથવા શબ્દોની શ્રેણી ઓળખવી.
- નામાંકિત એન્ટિટી વર્ગીકરણ - દરેક શોધાયેલ એન્ટિટીને પૂર્વવ્યાખ્યાયિત શ્રેણીઓમાં વર્ગીકૃત કરવી.
પરંતુ NER NLP સાથે કેવી રીતે સંબંધિત છે?
નેચરલ લેંગ્વેજ પ્રોસેસિંગ વાણી અને ટેક્સ્ટમાંથી અર્થ કાઢવા સક્ષમ બુદ્ધિશાળી મશીનો વિકસાવવામાં મદદ કરે છે. મશીન લર્નિંગ આ બુદ્ધિશાળી સિસ્ટમોને મોટી માત્રામાં નેચરલ લેંગ્વેજ ડેટાસેટ્સ પર તાલીમ આપીને શીખવાનું ચાલુ રાખવામાં મદદ કરે છે.
સામાન્ય રીતે, NLP માં ત્રણ મુખ્ય શ્રેણીઓ હોય છે:
- ભાષાની રચના અને નિયમોને સમજવું - સિન્ટેક્ષ
- શબ્દો, લખાણ અને વાણીનો અર્થ કાઢવો અને તેમના સંબંધો ઓળખવા - સિમેન્ટીક્સ
- બોલાયેલા શબ્દોને ઓળખવા અને ઓળખવા અને તેમને લખાણમાં રૂપાંતરિત કરવા - ભાષણ
NER NLP ના સિમેન્ટીક ભાગમાં મદદ કરે છે, શબ્દોનો અર્થ કાઢવામાં, તેમના સંબંધોના આધારે તેમને ઓળખવા અને શોધવામાં મદદ કરે છે.
સામાન્ય NER એન્ટિટી પ્રકારોમાં ઊંડાણપૂર્વક ડૂબકી લગાવો
નામાંકિત એન્ટિટી રેકગ્નિશન મોડેલ્સ એન્ટિટીઓને વિવિધ પૂર્વવ્યાખ્યાયિત પ્રકારોમાં વર્ગીકૃત કરે છે. NER નો અસરકારક રીતે ઉપયોગ કરવા માટે આ પ્રકારોને સમજવું મહત્વપૂર્ણ છે. અહીં કેટલાક સૌથી સામાન્ય પ્રકારો પર નજીકથી નજર નાખવામાં આવી છે:
- વ્યક્તિ (પ્રતિ): વ્યક્તિઓના નામ ઓળખે છે, જેમાં પ્રથમ, મધ્ય અને છેલ્લું નામ, પદવીઓ અને માનદ ઉપનામોનો સમાવેશ થાય છે. ઉદાહરણ: નેલ્સન મંડેલા, ડૉ. જેન ડો
- સંગઠન (ORG): કંપનીઓ, સંસ્થાઓ, સરકારી એજન્સીઓ અને અન્ય સંગઠિત જૂથોને ઓળખે છે. ઉદાહરણ: ગૂગલ, વિશ્વ આરોગ્ય સંગઠન, સંયુક્ત રાષ્ટ્ર
- સ્થાન (LOC): દેશો, શહેરો, રાજ્યો, સરનામાં અને સીમાચિહ્નો સહિત ભૌગોલિક સ્થાનો શોધે છે. ઉદાહરણ: લંડન, માઉન્ટ એવરેસ્ટ, ટાઇમ્સ સ્ક્વેર
- તારીખ (તારીખ): વિવિધ ફોર્મેટમાં તારીખો કાઢે છે. ઉદાહરણ: 1 જાન્યુઆરી, 2024, 2024-01-01
- સમય (TIME): સમય અભિવ્યક્તિઓ ઓળખે છે. ઉદાહરણ: બપોરે 3:00, 15:00
- જથ્થો (QUANTITY): સંખ્યાત્મક માત્રા અને માપનના એકમો ઓળખે છે. ઉદાહરણ: 10 કિલોગ્રામ, 2 લિટર
- ટકાવારી (ટકા): ટકાવારી શોધે છે. ઉદાહરણ: ૫૦%, ૦.૫
- પૈસા (પૈસા): નાણાકીય મૂલ્યો અને ચલણો કાઢે છે. ઉદાહરણ: $100, €50
- અન્ય (MISC): અન્ય પ્રકારોમાં બંધબેસતી ન હોય તેવી એન્ટિટીઓ માટે કેચ-ઓલ કેટેગરી. ઉદાહરણ: નોબેલ પુરસ્કાર, iPhone 15″
નામવાળી એન્ટિટી ઓળખના ઉદાહરણો
પૂર્વનિર્ધારિત એન્ટિટી વર્ગીકરણના કેટલાક સામાન્ય ઉદાહરણો છે:
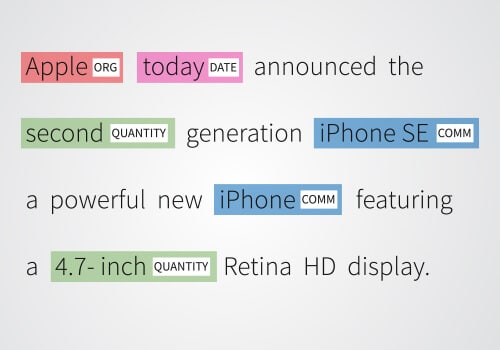
એપલ: ને ORG (સંગઠન) તરીકે લેબલ કરવામાં આવ્યું છે અને લાલ રંગમાં પ્રકાશિત કરવામાં આવ્યું છે. આજે: ને DATE તરીકે લેબલ કરવામાં આવ્યું છે અને ગુલાબી રંગમાં પ્રકાશિત કરવામાં આવ્યું છે. બીજું: ને QUANTITY તરીકે લેબલ કરવામાં આવ્યું છે અને લીલા રંગમાં પ્રકાશિત કરવામાં આવ્યું છે . iPhone SE: ને COMM (વાણિજ્યિક ઉત્પાદન) તરીકે લેબલ કરવામાં આવ્યું છે અને વાદળી રંગમાં પ્રકાશિત કરવામાં આવ્યું છે. 4.7-ઇંચ: ને QUANTITY તરીકે લેબલ કરવામાં આવ્યું છે અને લીલા રંગમાં પ્રકાશિત કરવામાં આવ્યું છે.
નામાંકિત એન્ટિટી ઓળખમાં અસ્પષ્ટતા
આ શબ્દ કઈ શ્રેણીનો છે તે મનુષ્યો માટે સહજ રીતે સ્પષ્ટ છે. જોકે, કમ્પ્યુટર્સ સાથે આવું નથી - તેમને વર્ગીકરણ સમસ્યાઓનો સામનો કરવો પડે છે. ઉદાહરણ તરીકે:
માન્ચેસ્ટર સિટી ( સંગઠન ) એ પ્રીમિયર લીગ ટ્રોફી જીતી હતી જ્યારે નીચેના વાક્યમાં સંગઠનનો ઉપયોગ અલગ રીતે કરવામાં આવ્યો છે. માન્ચેસ્ટર સિટી ( સ્થાન ) એક કાપડ અને ઔદ્યોગિક પાવરહાઉસ હતું.
તમારા NER મોડેલને સચોટ એન્ટિટી નિષ્કર્ષણ કરવા માટે તાલીમ ડેટાની જરૂર છે અને શીખેલા પેટર્નના આધારે નામવાળી એન્ટિટીઓનું વર્ગીકરણ કરે છે. જો તમે તમારા મોડેલને શેક્સપિયરિયન અંગ્રેજી પર તાલીમ આપી રહ્યા છો, તો કહેવાની જરૂર નથી કે તે Instagram ને સમજવામાં સમર્થ હશે નહીં. NER મોડેલ્સનું મૂલ્યાંકન તેમની આગાહીઓની તુલના ગ્રાઉન્ડ ટ્રુથ એનોટેશન સાથે કરીને કરવામાં આવે છે, જે ડેટાસેટમાં સાચા, મેન્યુઅલી લેબલ થયેલ એન્ટિટી છે.
નામવાળી એન્ટિટી ઓળખ કેવી રીતે કાર્ય કરે છે?
નેમ્ડ એન્ટિટી રેકગ્નિશન (NER) ના ક્ષેત્રમાં ઊંડાણપૂર્વક પ્રવેશ કરવાથી અનેક તબક્કાઓનો સમાવેશ કરતી એક વ્યવસ્થિત યાત્રા ખુલે છે:
-
ટોકનીકરણ
શરૂઆતમાં, ટેક્સ્ટ્યુઅલ ડેટાને નાના એકમોમાં વિભાજીત કરવામાં આવે છે, જેને ટોકન્સ કહેવામાં આવે છે, જે શબ્દોથી વાક્યો સુધી બદલાઈ શકે છે. ઉદાહરણ તરીકે, "બરાક ઓબામા યુએસએના રાષ્ટ્રપતિ હતા" વિધાનને "બરાક", "ઓબામા", "હતા", "ધ", "પ્રેસિડેન્ટ", "ઓફ", "ધ", અને "યુએસએ" જેવા ટોકન્સમાં વિભાજિત કરવામાં આવે છે.
-
એન્ટિટી શોધ
ભાષાકીય માર્ગદર્શિકા અને આંકડાકીય પદ્ધતિઓના મિશ્રણનો ઉપયોગ કરીને, સંભવિત નામવાળી એન્ટિટીઓને પ્રકાશિત કરવામાં આવે છે. આ તબક્કામાં નામોમાં કેપિટલાઇઝેશન ("બરાક ઓબામા") અથવા અલગ ફોર્મેટ (જેમ કે તારીખો) જેવા પેટર્નને ઓળખવા ખૂબ જ મહત્વપૂર્ણ છે.
-
એન્ટિટી વર્ગીકરણ
શોધ પછી, એન્ટિટીઓને "વ્યક્તિ", "સંગઠન", અથવા "સ્થાન" જેવી પૂર્વવ્યાખ્યાયિત શ્રેણીઓમાં વર્ગીકૃત કરવામાં આવે છે. લેબલવાળા ડેટાસેટ્સ પર પોષાયેલા મશીન લર્નિંગ મોડેલો ઘણીવાર આ વર્ગીકરણને ચલાવે છે. અહીં, "બરાક ઓબામા" ને "વ્યક્તિ" અને "યુએસએ" ને "સ્થાન" તરીકે ટૅગ કરવામાં આવે છે.
-
સંદર્ભિત મૂલ્યાંકન
NER સિસ્ટમ્સની શક્તિ ઘણીવાર આસપાસના સંદર્ભનું મૂલ્યાંકન કરીને વધારવામાં આવે છે. ઉદાહરણ તરીકે, "વોશિંગ્ટન એક ઐતિહાસિક ઘટનાનું સાક્ષી બન્યું" વાક્યમાં, સંદર્ભ "વોશિંગ્ટન" ને વ્યક્તિના નામને બદલે સ્થાન તરીકે ઓળખવામાં મદદ કરે છે.
-
મૂલ્યાંકન પછીનું શુદ્ધિકરણ
પ્રારંભિક ઓળખ અને વર્ગીકરણ પછી, પરિણામોને સુધારવા માટે મૂલ્યાંકન પછીના સુધારા થઈ શકે છે. આ તબક્કો અસ્પષ્ટતાઓને દૂર કરી શકે છે, બહુ-ટોકન એન્ટિટીઝને ફ્યુઝ કરી શકે છે અથવા એન્ટિટી ડેટાને વધારવા માટે જ્ઞાન આધારનો ઉપયોગ કરી શકે છે.
આ વ્યાખ્યાયિત અભિગમ માત્ર NER ના મૂળને જ દૂર કરતું નથી પણ સર્ચ એન્જિન માટે સામગ્રીને પણ ઑપ્ટિમાઇઝ કરે છે, જે NER દ્વારા રજૂ થતી જટિલ પ્રક્રિયાની દૃશ્યતામાં વધારો કરે છે.
મુખ્ય NER અભિગમો કયા છે?
NER મોડેલનો પ્રાથમિક ધ્યેય ટેક્સ્ટ દસ્તાવેજોમાં એન્ટિટીઓને લેબલ કરવાનો અને તેમને વર્ગીકૃત કરવાનો છે. આ હેતુ માટે સામાન્ય રીતે નીચેના ત્રણ અભિગમોનો ઉપયોગ કરવામાં આવે છે. જો કે, તમે એક અથવા વધુ પદ્ધતિઓને પણ જોડવાનું પસંદ કરી શકો છો. NER સિસ્ટમ્સ બનાવવા માટેના વિવિધ અભિગમો છે:

શબ્દકોશ-આધારિત સિસ્ટમો
શબ્દકોશ-આધારિત સિસ્ટમ કદાચ સૌથી સરળ અને મૂળભૂત NER અભિગમ છે. તે ઘણા શબ્દો, સમાનાર્થી શબ્દો અને શબ્દભંડોળ સંગ્રહ સાથે શબ્દકોશનો ઉપયોગ કરશે. સિસ્ટમ તપાસ કરશે કે ટેક્સ્ટમાં હાજર કોઈ ચોક્કસ એન્ટિટી શબ્દભંડોળમાં પણ ઉપલબ્ધ છે કે નહીં. સ્ટ્રિંગ-મેચિંગ અલ્ગોરિધમનો ઉપયોગ કરીને, એન્ટિટીઓનું ક્રોસ-ચેકિંગ કરવામાં આવે છે.
આ અભિગમનો ઉપયોગ કરવાનો એક ગેરલાભ એ છે કે NER મોડેલની અસરકારક કામગીરી માટે શબ્દભંડોળ ડેટાસેટને સતત અપગ્રેડ કરવાની જરૂર છે.
નિયમ આધારિત સિસ્ટમો
આ અભિગમમાં, પૂર્વ-નિર્ધારિત નિયમોના સમૂહના આધારે માહિતી કાઢવામાં આવે છે. નિયમોના બે પ્રાથમિક સમૂહનો ઉપયોગ થાય છે,
પેટર્ન-આધારિત નિયમો - જેમ નામ સૂચવે છે, પેટર્ન-આધારિત નિયમ દસ્તાવેજમાં વપરાતા મોર્ફોલોજિકલ પેટર્ન અથવા શબ્દોની શ્રેણીને અનુસરે છે.
સંદર્ભ-આધારિત નિયમો - સંદર્ભ-આધારિત નિયમો દસ્તાવેજમાં શબ્દના અર્થ અથવા સંદર્ભ પર આધાર રાખે છે.
મશીન લર્નિંગ-આધારિત સિસ્ટમ્સ
મશીન લર્નિંગ-આધારિત સિસ્ટમોમાં, આંકડાકીય મોડેલિંગનો ઉપયોગ એન્ટિટી શોધવા માટે થાય છે. આ અભિગમમાં ટેક્સ્ટ ડોક્યુમેન્ટનું લક્ષણ-આધારિત પ્રતિનિધિત્વ વપરાય છે. તમે પહેલા બે અભિગમોની ઘણી ખામીઓને દૂર કરી શકો છો કારણ કે મોડેલ એન્ટિટી પ્રકારોને તેમના જોડણીમાં થોડો ફેરફાર હોવા છતાં ઓળખી શકે છે.
ડીપ લર્નિંગ
NER માટે ડીપ લર્નિંગ પદ્ધતિઓ લાંબા ગાળાની ટેક્સ્ટ ડિપેન્ડન્સીને સમજવા માટે RNN અને ટ્રાન્સફોર્મર જેવા ન્યુરલ નેટવર્કની શક્તિનો ઉપયોગ કરે છે. આ પદ્ધતિઓનો ઉપયોગ કરવાનો મુખ્ય ફાયદો એ છે કે તે વિપુલ પ્રમાણમાં તાલીમ ડેટા સાથે મોટા પાયે NER કાર્યો માટે યોગ્ય છે.
વધુમાં, તેઓ ડેટામાંથી જ જટિલ પેટર્ન અને સુવિધાઓ શીખી શકે છે, જેનાથી મેન્યુઅલ તાલીમની જરૂરિયાત દૂર થાય છે. પરંતુ એક મુશ્કેલી છે. આ પદ્ધતિઓને તાલીમ અને જમાવટ માટે મોટી માત્રામાં ગણતરી શક્તિની જરૂર પડે છે.
હાઇબ્રિડ પદ્ધતિઓ
આ પદ્ધતિઓ નિયમ-આધારિત, આંકડાકીય અને મશીન લર્નિંગ જેવા અભિગમોને જોડીને નામવાળી એન્ટિટીઓ કાઢે છે. ધ્યેય દરેક પદ્ધતિની શક્તિઓને જોડવાનો છે અને સાથે સાથે તેમની નબળાઈઓને પણ ઓછી કરવાનો છે. હાઇબ્રિડ પદ્ધતિઓનો ઉપયોગ કરવાનો શ્રેષ્ઠ ભાગ એ છે કે તમે બહુવિધ તકનીકોને મર્જ કરીને મેળવેલી સુગમતા છે જેના દ્વારા તમે વિવિધ ડેટા સ્ત્રોતોમાંથી એન્ટિટીઓ કાઢી શકો છો.
જોકે, એવી શક્યતા છે કે આ પદ્ધતિઓ સિંગલ-એપ્રોચ પદ્ધતિઓ કરતાં ઘણી વધુ જટિલ બની શકે છે કારણ કે જ્યારે તમે બહુવિધ અભિગમોને મર્જ કરો છો, ત્યારે કાર્યપ્રવાહ ગૂંચવણભર્યો બની શકે છે.
NER ક્યાં વપરાય છે? ટોચના ઉપયોગના કિસ્સાઓ અને ઉદ્યોગો
નામાંકિત એન્ટિટી રેકગ્નિશન (NER) ની વૈવિધ્યતાને અનાવરણ કરવું.
NER નો ઉપયોગ નાણાકીય ક્ષેત્રથી લઈને આરોગ્યસંભાળ સુધીના વિવિધ ક્ષેત્રોમાં થાય છે, જે તેની અનુકૂલનક્ષમતા અને વ્યાપક ઉપયોગિતા દર્શાવે છે.
- ચેટબોટ્સ: GPT જેવા ચેટબોટ્સને મુખ્ય એન્ટિટી ઓળખીને વપરાશકર્તા પ્રશ્નોને સમજવામાં મદદ કરે છે.
- ગ્રાહક સેવા: પ્રતિભાવ સમયને વેગ આપીને, ઉત્પાદન દ્વારા પ્રતિસાદનું વર્ગીકરણ કરે છે.
- નાણા: વલણ વિશ્લેષણ અને જોખમ મૂલ્યાંકન માટે નાણાકીય અહેવાલોમાંથી મહત્વપૂર્ણ ડેટા કાઢે છે.
- સ્વાસ્થ્ય કાળજી: ઇલેક્ટ્રોનિક હેલ્થ રેકોર્ડ્સ (EHR) માંથી દર્દીનો ડેટા કાઢવો.
- એચઆર: અરજદારોની પ્રોફાઇલનો સારાંશ આપીને અને પ્રતિસાદને ચેનલ કરીને ભરતીને સુવ્યવસ્થિત બનાવે છે.
- સમાચાર પ્રદાતાઓ: સામગ્રીને સંબંધિત માહિતીમાં વર્ગીકૃત કરે છે, રિપોર્ટિંગને ઝડપી બનાવે છે.
- ભલામણ એન્જિન: નેટફ્લિક્સ જેવી કંપનીઓ વપરાશકર્તાના વર્તનના આધારે ભલામણોને વ્યક્તિગત કરવા માટે NER નો ઉપયોગ કરે છે.
- શોધ એંજીન: વેબ સામગ્રીનું વર્ગીકરણ કરીને, NER શોધ પરિણામની ચોકસાઈ વધારે છે.
- લાગણી વિશ્લેષણ: ઇxtracts બ્રાન્ડના ઉલ્લેખો સમીક્ષાઓમાંથી આવે છે, જે ભાવના વિશ્લેષણ સાધનોને પ્રોત્સાહન આપે છે.
- ઈકોમર્સ: વ્યક્તિગત ખરીદીના અનુભવોને બહેતર બનાવવા.
- કાનૂની: કરારો અને કાનૂની દસ્તાવેજોનું વિશ્લેષણ.
NER દ્વારા કાઢવામાં આવેલા એન્ટિટીઓને જ્ઞાન ગ્રાફમાં એકીકૃત કરી શકાય છે, જેનાથી ડેટા સંગઠન અને પુનઃપ્રાપ્તિમાં વધારો થાય છે.
નેમ્ડ એન્ટિટી રેકગ્નિશન (NER) નો ઉપયોગ કોણ કરે છે?
NER (નેમ્ડ એન્ટિટી રેકગ્નિશન) એ શક્તિશાળી નેચરલ લેંગ્વેજ પ્રોસેસિંગ (NLP) તકનીકોમાંની એક છે, જે વિવિધ ઉદ્યોગો અને ક્ષેત્રોમાં પ્રવેશી છે. સંસ્થાઓ ઘણીવાર માહિતી નિષ્કર્ષણને સ્વચાલિત કરવા અને કાર્યક્ષમતા સુધારવા માટે નામવાળી એન્ટિટી રેકગ્નિશન સિસ્ટમનો ઉપયોગ કરે છે. અહીં કેટલાક ઉદાહરણો છે:
- શોધ એંજીન: NER એ આધુનિક સર્ચ એન્જિન જેમ કે Google અને Bing નો મુખ્ય ઘટક છે. તેનો ઉપયોગ વેબ પેજ અને સર્ચ ક્વેરીઝમાંથી એન્ટિટીને ઓળખવા અને વર્ગીકૃત કરવા માટે થાય છે જેથી વધુ સુસંગત શોધ પરિણામો મળી શકે. ઉદાહરણ તરીકે, NER ની મદદથી, સર્ચ એન્જિન સંદર્ભના આધારે "Apple" કંપની અને "Apple" ફળ વચ્ચે તફાવત કરી શકે છે. સચોટ અને સંદર્ભ-જાગૃત પરિણામો પહોંચાડવા માટે NER પ્રક્રિયાનો અમલ મહત્વપૂર્ણ છે.
- ચેટબોટ્સ: ચેટબોટ્સ અને AI સહાયકો વપરાશકર્તા પ્રશ્નોમાંથી મુખ્ય એન્ટિટીને સમજવા માટે NER નો ઉપયોગ કરી શકે છે. આમ કરીને, ચેટબોટ્સ વધુ ચોક્કસ જવાબો આપી શકે છે. ઉદાહરણ તરીકે, જો તમે "સેન્ટ્રલ પાર્ક નજીક ઇટાલિયન રેસ્ટોરન્ટ શોધો" પૂછો છો, તો ચેટબોટ "ઇટાલિયન" ને ભોજનના પ્રકાર તરીકે, "રેસ્ટોરન્ટ" ને સ્થળ તરીકે અને "સેન્ટ્રલ પાર્ક" ને સ્થાન તરીકે સમજશે. NER પ્રક્રિયા આ સિસ્ટમોને સંબંધિત માહિતીને કાર્યક્ષમ રીતે કાઢવા માટે સક્ષમ બનાવે છે.
- તપાસ જર્નાલિઝમ: એક પ્રખ્યાત મીડિયા સંસ્થા, ઇન્ટરનેશનલ કન્સોર્ટિયમ ઓફ ઇન્વેસ્ટિગેટિવ જર્નાલિસ્ટ્સ (ICIJ) એ પનામા પેપર્સનું વિશ્લેષણ કરવા માટે NER નો ઉપયોગ કર્યો, જે 11.5 મિલિયન નાણાકીય અને કાનૂની દસ્તાવેજોનો મોટો લીક હતો. આ કિસ્સામાં, NER નો ઉપયોગ લાખો અનસ્ટ્રક્ચર્ડ દસ્તાવેજોમાં લોકો, સંગઠનો અને સ્થાનોને આપમેળે ઓળખવા માટે કરવામાં આવ્યો હતો, જેનાથી ઓફશોર ટેક્સ ચોરીના છુપાયેલા નેટવર્કનો પર્દાફાશ થયો હતો.
- બાયોઇન્ફોર્મેટિક્સ: બાયોઇન્ફોર્મેટિક્સના ક્ષેત્રમાં, NER નો ઉપયોગ બાયોમેડિકલ સંશોધન પત્રો અને ક્લિનિકલ ટ્રાયલ રિપોર્ટ્સમાંથી જનીનો, પ્રોટીન, દવાઓ અને રોગો જેવા મુખ્ય ઘટકો કાઢવા માટે થાય છે. આવા ડેટા દવા શોધની પ્રક્રિયાને ઝડપી બનાવવામાં મદદ કરે છે. મોટા બાયોમેડિકલ કોર્પોરા પર મોડેલોની પૂર્વ-તાલીમ આ વિશિષ્ટ ક્ષેત્રમાં NER સિસ્ટમ્સના પ્રદર્શનમાં નોંધપાત્ર સુધારો કરી શકે છે.
- સોશિયલ મીડિયા મોનિટરિંગ: સોશિયલ મીડિયા પર બ્રાન્ડ્સ તેમના જાહેરાત ઝુંબેશના એકંદર મેટ્રિક્સ અને તેમના સ્પર્ધકો કેવી રીતે કરી રહ્યા છે તે ટ્રેક કરવા માટે NER નો ઉપયોગ કરે છે. ઉદાહરણ તરીકે, એક એરલાઇન છે જે તેમના બ્રાન્ડનો ઉલ્લેખ કરતી ટ્વીટ્સનું વિશ્લેષણ કરવા માટે NER નો ઉપયોગ કરે છે. તે ચોક્કસ એરપોર્ટ પર "ખોવાયેલ સામાન" જેવી એન્ટિટીઓની આસપાસ નકારાત્મક ટિપ્પણીઓ શોધી કાઢે છે જેથી તેઓ શક્ય તેટલી ઝડપથી સમસ્યાનો ઉકેલ લાવી શકે. વિશાળ માત્રામાં સોશિયલ મીડિયા ડેટામાંથી કાર્યક્ષમ આંતરદૃષ્ટિ કાઢવા માટે NER પ્રક્રિયા આવશ્યક છે.
- સંદર્ભિત જાહેરાત: જાહેરાત પ્લેટફોર્મ NER નો ઉપયોગ વેબ પૃષ્ઠોમાંથી મુખ્ય એન્ટિટી કાઢવા માટે કરે છે જેથી સામગ્રીની સાથે વધુ સુસંગત જાહેરાતો પ્રદર્શિત થાય, જેનાથી જાહેરાત લક્ષ્યીકરણ અને ક્લિક-થ્રુ રેટમાં સુધારો થાય. ઉદાહરણ તરીકે, જો NER ટ્રાવેલ બ્લોગ પર "હવાઈ", "હોટેલ્સ" અને "બીચ" શોધે છે, તો જાહેરાત પ્લેટફોર્મ સામાન્ય હોટેલ ચેઇન્સને બદલે હવાઇયન રિસોર્ટ્સ માટેના સોદા બતાવશે.
- ભરતી અને રિઝ્યુમ સ્ક્રીનીંગ: તમે અરજદારના કૌશલ્ય સમૂહ, અનુભવ અને પૃષ્ઠભૂમિના આધારે ચોક્કસ જરૂરી કુશળતા અને લાયકાત શોધવા માટે NER ને સૂચના આપી શકો છો. ઉદાહરણ તરીકે, ભરતી એજન્સી ઉમેદવારોને આપમેળે મેચ કરવા માટે NER નો ઉપયોગ કરી શકે છે. કંપનીઓ ચોક્કસ જરૂરિયાતો અનુસાર તૈયાર કરેલા પોતાના મોડેલનો ઉપયોગ કરી શકે છે, અથવા તેમની નામવાળી એન્ટિટી ઓળખ પ્રણાલીની ચોકસાઈ વધારવા માટે પૂર્વ-પ્રશિક્ષિત મોડેલોનો ઉપયોગ કરી શકે છે.
ઉદ્યોગોમાં નામાંકિત એન્ટિટી રેકગ્નિશન (NER) ની અરજીઓ
NER પાસે નેચરલ લેંગ્વેજ પ્રોસેસિંગ અને મશીન લર્નિંગ અને ડીપ લર્નિંગ સોલ્યુશન્સ માટે તાલીમ ડેટાસેટ્સ બનાવવા સંબંધિત ઘણા ક્ષેત્રોમાં ઉપયોગના ઘણા કિસ્સાઓ છે. નવા ડેટા પર NER કરવા માટે એક પ્રશિક્ષિત મોડેલનો ઉપયોગ કરવામાં આવે છે, જે મોટા પ્રમાણમાં ટેક્સ્ટમાંથી એન્ટિટીના સ્વચાલિત નિષ્કર્ષણને સક્ષમ કરે છે. કેટલાક એપ્લિકેશનો છે:
કસ્ટમર સપોર્ટ
NER સિસ્ટમ ઉત્પાદનના નામ, સ્પષ્ટીકરણો, શાખા સ્થાનો અને વધુ જેવી મહત્વપૂર્ણ માહિતીના આધારે સંબંધિત ગ્રાહક ફરિયાદો, પ્રશ્નો અને પ્રતિસાદ સરળતાથી શોધી શકે છે. ફરિયાદ અથવા પ્રતિસાદને યોગ્ય રીતે વર્ગીકૃત કરવામાં આવે છે અને પ્રાથમિકતા કીવર્ડ્સ ફિલ્ટર કરીને યોગ્ય વિભાગમાં મોકલવામાં આવે છે.
કાર્યક્ષમ માનવ સંસાધન
NER માનવ સંસાધન ટીમોને તેમની ભરતી પ્રક્રિયા સુધારવામાં અને અરજદારોના રિઝ્યુમનો ઝડપથી સારાંશ આપીને સમયમર્યાદા ઘટાડવામાં મદદ કરે છે. NER ટૂલ્સ રિઝ્યુમને સ્કેન કરી શકે છે અને સંબંધિત માહિતી - નામ, ઉંમર, સરનામું, લાયકાત, કોલેજ વગેરે - મેળવી શકે છે.
વધુમાં, HR વિભાગ કર્મચારીઓની ફરિયાદોને ફિલ્ટર કરીને અને તેમને સંબંધિત વિભાગીય વડાઓને ફોરવર્ડ કરીને આંતરિક કાર્યપ્રવાહને સુવ્યવસ્થિત કરવા માટે NER ટૂલ્સનો પણ ઉપયોગ કરી શકે છે.
સામગ્રી વર્ગીકરણ
સમાચાર પ્રદાતાઓ માટે સામગ્રીનું વર્ગીકરણ એક વિશાળ કાર્ય છે. સામગ્રીને વિવિધ શ્રેણીઓમાં વર્ગીકૃત કરવાથી શોધવાનું, આંતરદૃષ્ટિ મેળવવાનું, વલણો ઓળખવાનું અને વિષયોને સમજવાનું સરળ બને છે. સમાચાર પ્રદાતાઓ માટે નામાંકિત એન્ટિટી રેકગ્નિશન ટૂલ ઉપયોગી થઈ શકે છે. તે ઘણા લેખોને સ્કેન કરી શકે છે, પ્રાથમિકતાવાળા કીવર્ડ્સ ઓળખી શકે છે અને વ્યક્તિઓ, સંગઠન, સ્થાન અને વધુના આધારે માહિતી મેળવી શકે છે.
શોધ એન્જિનને ઑપ્ટિમાઇઝ કરવું

ચોક્કસ સામગ્રી ભલામણ
ઘણી આધુનિક એપ્લિકેશનો ઑપ્ટિમાઇઝ અને કસ્ટમાઇઝ્ડ ગ્રાહક અનુભવ પ્રદાન કરવા માટે NER ટૂલ્સ પર આધાર રાખે છે. ઉદાહરણ તરીકે, Netflix નામવાળી એન્ટિટી ઓળખનો ઉપયોગ કરીને વપરાશકર્તાના શોધ અને દૃશ્ય ઇતિહાસના આધારે વ્યક્તિગત ભલામણો પ્રદાન કરે છે.

નામ આપવામાં આવ્યું એન્ટિટી રેકગ્નિશન તમારા મશીન લર્નિંગ મોડેલ્સને વધુ કાર્યક્ષમ અને વિશ્વસનીય બનાવે છે - પરંતુ તેઓ ફક્ત ત્યારે જ શ્રેષ્ઠ પ્રદર્શન કરે છે જ્યારે ગુણવત્તાયુક્ત, સતત લેબલવાળા ડેટા પર તાલીમ આપવામાં આવે. અહીં એક અનુભવી ભાગીદાર મહત્વપૂર્ણ છે: શેપની NER ડેટા એનોટેશન સેવાઓ ફાઇનાન્સ, વીમા અને આરોગ્યસંભાળ જેવા ડોમેન્સમાં વ્યાપક, ઉપયોગમાં લેવા માટે તૈયાર NER ડેટાસેટ્સ પહોંચાડે છે, જેથી તમે કાર્યક્ષમ, અદ્યતન ML મોડેલો ઝડપથી વિકસાવી શકો.
[આ પણ વાંચો: NLP શું છે? તે કેવી રીતે કાર્ય કરે છે, ફાયદા, પડકારો, ઉદાહરણો
NER મોડેલનું મૂલ્યાંકન કેવી રીતે થાય છે?
NER મોડેલોને ત્રણ મેટ્રિક્સ સાથે સ્કોર કરવામાં આવે છે: ચોકસાઇ, રિકોલ અને F1-સ્કોર. તેઓ મોડેલની આગાહીઓની તુલના યોગ્ય રીતે લેબલ થયેલ એન્ટિટીઓના "ગ્રાઉન્ડ ટ્રુથ" સેટ સાથે કરે છે.
- શુદ્ધતા: મોડેલે આગાહી કરેલી એન્ટિટીમાંથી, કેટલી સાચી હતી? તે ખોટા ધન માપે છે.
- યાદ કરો: ખરેખર હાજર એન્ટિટીમાંથી, મોડેલને કેટલી મળી? તે ખોટા નકારાત્મકતાઓને માપે છે.
- F1-સ્કોર: ચોકસાઇ અને રિકોલનો સુમેળભર્યો સરેરાશ — બંનેને સંતુલિત કરતી એકલ સંખ્યા.
કામ કરેલું ઉદાહરણ : “Apple Inc. માર્ચ 2026 માં સાન ફ્રાન્સિસ્કોમાં ઓફિસ ખોલી રહ્યું છે,” માં ધારો કે મોડેલ યોગ્ય રીતે “Apple Inc.” અને “San Francisco” ને સ્થાન તરીકે ખોટી રીતે “office” ટૅગ કરે છે, અને “March 2026” ચૂકી જાય છે. તે 2 સાચા ધન, 1 ખોટા ધન અને 1 ખોટા નકારાત્મક આપે છે. ચોકસાઇ = 2/3 ≈ 0.67, રિકોલ = 2/3 ≈ 0.67, અને F1-સ્કોર ≈ 0.67. એક અટકેલા માન્યતા સમૂહ પર પરીક્ષણ - મોડેલે તાલીમમાં ક્યારેય જોયો ન હતો તે ડેટા - યાદ રાખવાને બદલે સામાન્યીકરણ કરે છે તેની પુષ્ટિ કરવા માટે જરૂરી છે.
NER ટૂલ્સ અને લાઇબ્રેરીઓની સરખામણી:
ઘણા શક્તિશાળી સાધનો અને પુસ્તકાલયો NER અમલીકરણને સરળ બનાવે છે. અહીં કેટલાક લોકપ્રિય વિકલ્પોની સરખામણી છે:
| ટૂલ/લાઇબ્રેરી | વર્ણન | શક્તિ | નબળાઇઓ |
|---|---|---|---|
| spaCy | પાયથોનમાં એક ઝડપી અને કાર્યક્ષમ NLP લાઇબ્રેરી. | ઉત્તમ કામગીરી, ઉપયોગમાં સરળ, પૂર્વ-પ્રશિક્ષિત મોડેલો ઉપલબ્ધ છે. | અંગ્રેજી સિવાયની ભાષાઓ માટે મર્યાદિત સમર્થન. |
| NLTK | પાયથોનમાં એક વ્યાપક NLP લાઇબ્રેરી. | શૈક્ષણિક હેતુઓ માટે સારી, કાર્યક્ષમતાઓની વિશાળ શ્રેણી. | સ્પેસાય કરતા ધીમું હોઈ શકે છે. |
| સ્ટેનફોર્ડ કોરએનએલપી | જાવા-આધારિત NLP ટૂલકીટ. | ખૂબ જ સચોટ, બહુવિધ ભાષાઓને સપોર્ટ કરે છે. | વધુ ગણતરીત્મક સંસાધનોની જરૂર છે. |
| ઓપનએનએલપી | NLP માટે મશીન લર્નિંગ-આધારિત ટૂલકીટ. | બહુવિધ ભાષાઓને સપોર્ટ કરે છે, કસ્ટમાઇઝ કરી શકાય તેવું. | સેટઅપ કરવું જટિલ હોઈ શકે છે. |
NER માં મોડેલ તાલીમ
મોડેલ તાલીમ અસરકારક નેમ્ડ એન્ટિટી રેકગ્નિશન (NER) સિસ્ટમ્સના નિર્માણના કેન્દ્રમાં છે. આ પ્રક્રિયામાં લેબલવાળા તાલીમ ડેટામાંથી શીખીને નામવાળી એન્ટિટીઓ - જેમ કે લોકો, સંસ્થાઓ અને સ્થાનો - ને ઓળખવા અને વર્ગીકૃત કરવા માટે મોડેલ શીખવવાનો સમાવેશ થાય છે. એન્ટિટી ઓળખની સફળતા આ તાલીમ ડેટાની ગુણવત્તા અને વિવિધતા, તેમજ દરેક એન્ટિટી પ્રકાર માટે પૂર્વવ્યાખ્યાયિત શ્રેણીઓની સ્પષ્ટતા પર ખૂબ આધાર રાખે છે.
મોડેલ તાલીમ દરમિયાન, મશીન લર્નિંગ અલ્ગોરિધમ્સ યોગ્ય એન્ટિટી લેબલ્સ સાથે એનોટેટેડ ટેક્સ્ટ્યુઅલ ડેટાનું વિશ્લેષણ કરે છે. રિકરન્ટ ન્યુરલ નેટવર્ક્સ (RNNs) અને કન્વોલ્યુશનલ ન્યુરલ નેટવર્ક્સ (CNNs) સહિત ડીપ લર્નિંગ મોડેલ્સ, NER કાર્યો માટે ખાસ કરીને લોકપ્રિય બન્યા છે. આ ન્યુરલ નેટવર્ક્સ ટેક્સ્ટની અંદર જટિલ પેટર્ન અને સંબંધોને કેપ્ચર કરવામાં શ્રેષ્ઠ છે, જે NER મોડેલને પ્રભાવશાળી ચોકસાઈ સાથે એન્ટિટીઓને ઓળખવા સક્ષમ બનાવે છે - ભાષામાં સૂક્ષ્મ ભિન્નતાનો સામનો કરતી વખતે પણ.
જોકે, નામાંકિત એન્ટિટી રેકગ્નિશનર માટે ડીપ લર્નિંગ મોડેલ્સને તાલીમ આપવા માટે મોટા પ્રમાણમાં લેબલવાળા ડેટાની જરૂર પડે છે, જે ઉત્પાદન કરવામાં સમય માંગી લે છે અને ખર્ચાળ પણ હોઈ શકે છે. આને સંબોધવા માટે, ડેટા ઓગ્મેન્ટેશન અને ટ્રાન્સફર લર્નિંગ જેવી તકનીકોનો ઉપયોગ ઘણીવાર કરવામાં આવે છે. ડેટા ઓગ્મેન્ટેશન હાલના ડેટામાંથી નવા ઉદાહરણો જનરેટ કરીને તાલીમ ડેટાસેટને વિસ્તૃત કરે છે, જ્યારે ટ્રાન્સફર લર્નિંગ પૂર્વ-પ્રશિક્ષિત મોડેલોનો લાભ લે છે જેમણે પહેલાથી જ સામાન્ય ભાષા પેટર્ન શીખી લીધી છે, જેમાં ફક્ત ડોમેન-વિશિષ્ટ ડેટા પર ફાઇન-ટ્યુનિંગની જરૂર પડે છે.
આખરે, NER મોડેલની અસરકારકતા મજબૂત મોડેલ તાલીમ, ઉચ્ચ-ગુણવત્તાવાળા લેબલવાળા ડેટા અને ચોક્કસ એન્ટિટી ઓળખ કાર્ય માટે યોગ્ય મશીન લર્નિંગ અથવા ડીપ લર્નિંગ મોડેલ્સની કાળજીપૂર્વક પસંદગી પર આધારિત છે.
અસરકારક NER માટે શ્રેષ્ઠ પ્રથાઓ
નેમ્ડ એન્ટિટી રેકગ્નિશન (NER) માં ઉચ્ચ પ્રદર્શન પ્રાપ્ત કરવા માટે ડેટા ગુણવત્તા અને મોડેલ વિકાસ બંનેને સંબોધતી શ્રેષ્ઠ પ્રથાઓના સમૂહનું પાલન કરવું જરૂરી છે. અસરકારક એન્ટિટી ઓળખ માટે અહીં કેટલીક મુખ્ય વ્યૂહરચનાઓ છે:
- ઉચ્ચ-ગુણવત્તાવાળા તાલીમ ડેટાને પ્રાથમિકતા આપો: કોઈપણ સફળ NER મોડેલનો પાયો વૈવિધ્યસભર, સારી રીતે નોંધાયેલ અને પ્રતિનિધિ તાલીમ ડેટા છે. લેબલ થયેલ ડેટામાં એન્ટિટી પ્રકારો અને સંદર્ભોની વિશાળ શ્રેણી આવરી લેવી જોઈએ જેથી ખાતરી કરી શકાય કે મોડેલ નવા દૃશ્યોમાં સામાન્યીકરણ કરી શકે.
- સંપૂર્ણ ટેક્સ્ટ પ્રીપ્રોસેસિંગ: ટોકનાઇઝેશન અને પાર્ટ-ઓફ-સ્પીચ ટેગિંગ જેવા પગલાં મોડેલને ટેક્સ્ટની રચનાને વધુ સારી રીતે સમજવામાં મદદ કરે છે, નામવાળી એન્ટિટીઓને સચોટ રીતે ઓળખવા અને વર્ગીકૃત કરવાની તેની ક્ષમતામાં સુધારો કરે છે.
- યોગ્ય અલ્ગોરિધમ્સ પસંદ કરો: જ્યારે નિયમ આધારિત પદ્ધતિઓ સરળ અથવા ઉચ્ચ માળખાગત કાર્યો માટે અસરકારક હોઈ શકે છે, ત્યારે RNN અને CNN જેવા ઊંડા શિક્ષણ મોડેલો ઘણીવાર જટિલ, મોટા પાયે NER કાર્યો માટે શ્રેષ્ઠ પરિણામો આપે છે.
- પૂર્વ-પ્રશિક્ષિત મોડેલોનો લાભ લો: પૂર્વ-પ્રશિક્ષિત મોડેલોનો ઉપયોગ કરીને અને તમારા ચોક્કસ ડેટાસેટ પર તેમને ફાઇન-ટ્યુન કરવાથી મોટા લેબલવાળા ડેટાસેટ્સની જરૂરિયાત નોંધપાત્ર રીતે ઘટાડી શકાય છે, વિકાસને ઝડપી બનાવી શકાય છે અને પ્રદર્શનમાં સુધારો થઈ શકે છે.
- સતત મોડેલ મૂલ્યાંકન અને ફાઇન-ટ્યુનિંગ: મજબૂત મૂલ્યાંકન મેટ્રિક્સનો ઉપયોગ કરીને તમારા નેર મોડેલના પ્રદર્શનનું નિયમિતપણે મૂલ્યાંકન કરો, અને નવા ડેટા અથવા એન્ટિટી ઓળખ કાર્યો ઉભરી આવે તેમ તેને અપડેટ કરો.
- સંદર્ભિત જાગૃતિ: હંમેશા કયા સંદર્ભમાં એન્ટિટી દેખાય છે તે ધ્યાનમાં લો. આ એન્ટિટી નામોને સ્પષ્ટ કરવામાં મદદ કરે છે જેના બહુવિધ અર્થ હોઈ શકે છે, જેનાથી એન્ટિટી ઓળખ વધુ સચોટ બને છે.
આ શ્રેષ્ઠ પ્રથાઓનું પાલન કરીને, સંસ્થાઓ વધુ સચોટ, અનુકૂલનશીલ અને કાર્યક્ષમ NER સિસ્ટમો બનાવી શકે છે જે જટિલ ટેક્સ્ટ ડેટામાંથી એન્ટિટી કાઢવામાં શ્રેષ્ઠ છે.
કેસ સ્ટડી: ઓન્કોલોજી સંશોધન માટે ક્લિનિકલ NER
ક્લિનિકલ ટેક્સ્ટ એ છે જ્યાં NER ખરેખર મુશ્કેલ બને છે - અને જ્યાં તે સૌથી મહત્વપૂર્ણ છે. એક હેલ્થકેર પ્રોજેક્ટમાં, શેપે એક મુખ્ય હેલ્થકેર સંસ્થાને અનસ્ટ્રક્ચર્ડ ઓન્કોલોજી રેકોર્ડ્સને સંશોધન-તૈયાર ડેટાસેટમાં ફેરવવામાં મદદ કરવા માટે ક્લિનિકલ NER અને ડી-આઇડેન્ટિફિકેશન પાઇપલાઇન બનાવી, જે બધું HIPAA હેઠળ છે.
આ કાર્ય વ્યક્તિ અને સ્થાનને ટેગ કરવાથી ઘણું આગળ વધ્યું. ઓન્કોલોજી કુશળતા ધરાવતી એનોટેશન ટીમોએ ઓન્કોલોજી રેકોર્ડના આશરે 10,000 પાનામાં એક સમૃદ્ધ એન્ટિટી સ્કીમા લેબલ કરી, જેમાં શામેલ છે:
- રોગના અસ્તિત્વ: કેન્સરની સમસ્યા, હિસ્ટોલોજી, શરીરનું સ્થળ, વર્તન, ગ્રેડ, કેન્સર સ્ટેજ અને TNM સ્ટેજીંગ.
- સારવાર સંસ્થાઓ: કેન્સરની દવા, દવાની માત્રા, આવર્તન, કેન્સર સર્જરી, અને રેડિયેશન પદ્ધતિ અને માત્રા.
- જીનોમિક્સ એન્ટિટીઝ: અભ્યાસ કરેલ જનીન, વિવિધતા કોડ, પદ્ધતિ અને નમૂના.
- નકાર સ્થિતિ: નકારાત્મક, શક્ય-નકારાત્મક, અનિશ્ચિત અને શક્ય-સકારાત્મક તારણોને અલગ પાડવું — ક્લિનિકલ નોંધોમાં મહત્વપૂર્ણ.
- ક્લિનિકલ NER સંબંધો: કેન્સર સમસ્યા → બોડી સાઇટ અને હિસ્ટોલોજી → ગ્રેડ જેવા લિંકિંગ એન્ટિટીઝ, જેથી ડેટા ફક્ત લેબલ્સ જ નહીં, પણ અર્થ મેળવે.
આ ડેટાસેટ શેપના 5 મિલિયનથી વધુ ઇલેક્ટ્રોનિક આરોગ્ય રેકોર્ડના ભંડારમાંથી ક્યુરેટ કરવામાં આવ્યો હતો, પછી HIPAA ની સેફ હાર્બર પદ્ધતિનો ઉપયોગ કરીને ઓળખ રદ કરવામાં આવી હતી - પ્રોટેક્ટેડ હેલ્થ ઇન્ફર્મેશનના દરેક ભાગને લેબલવાળા પ્લેસહોલ્ડર્સથી બદલવામાં આવ્યો હતો જેથી ડેટા ઉપયોગી રહે અને દર્દીની ગોપનીયતા અકબંધ રહે. QA અને ક્લાયન્ટ પ્રતિસાદના ક્રમિક રાઉન્ડે એનોટેશનને જરૂરી ગુણવત્તા બેન્ચમાર્ક સુધી જાળવી રાખ્યા.
પરિણામ: 10,000 ઉચ્ચ-ગુણવત્તાવાળા, ઓળખ ન કરાયેલા, લેબલવાળા રેકોર્ડ્સ જે હવે ક્લાયન્ટના ઓન્કોલોજી NLP મોડેલ વિકાસને ટેકો આપે છે. આ પ્રોજેક્ટ બતાવે છે કે પ્રોડક્શન ક્લિનિકલ NER શું માંગે છે - ડોમેન-એક્સપર્ટ એનોટેટર્સ, રિલેશનશિપ-અવેર સ્કીમા, નેગેશન હેન્ડલિંગ અને એરટાઇટ કમ્પ્લાયન્સ - જેમાંથી કોઈ પણ સામાન્ય-હેતુ મોડેલ બોક્સની બહાર પહોંચાડતું નથી. સંપૂર્ણ વિરામ માટે તમે સંપૂર્ણ ઓન્કોલોજી NLP ડેવલપમેન્ટ કેસ સ્ટડી વાંચી શકો છો.
NER ના ફાયદા અને પડકારો?
લાભો:
- માહિતી નિષ્કર્ષણ: NER મુખ્ય ડેટા ઓળખે છે, માહિતી પુનઃપ્રાપ્તિમાં મદદ કરે છે.
- સામગ્રી સંસ્થા: તે ડેટાબેઝ અને સર્ચ એન્જિન માટે ઉપયોગી સામગ્રીને વર્ગીકૃત કરવામાં મદદ કરે છે.
- ઉન્નત વપરાશકર્તા અનુભવ: NER શોધ પરિણામોને સુધારે છે અને ભલામણોને વ્યક્તિગત કરે છે.
- સમજદાર વિશ્લેષણ: તે ભાવના વિશ્લેષણ અને વલણ શોધને સરળ બનાવે છે.
- સ્વયંસંચાલિત વર્કફ્લો: NER ઓટોમેશનને પ્રોત્સાહન આપે છે, સમય અને સંસાધનોની બચત કરે છે.
મર્યાદાઓ / પડકારો:
- અસ્પષ્ટતાનો ઉકેલ: "એમેઝોન" જેવા સમાન એન્ટિટીને નદી અથવા કંપની તરીકે અલગ પાડવાનો સંઘર્ષ.
- ડોમેન-વિશિષ્ટ અનુકૂલન: વિવિધ ક્ષેત્રોમાં સંસાધન-સઘન.
- ભાષા ભિન્નતા: અશિષ્ટ અને પ્રાદેશિક તફાવતોને કારણે અસરકારકતા બદલાય છે.
- લેબલવાળા ડેટાની અછત: તાલીમ માટે મોટા લેબલવાળા ડેટાસેટ્સની જરૂર છે.
- અનસ્ટ્રક્ચર્ડ ડેટાનું સંચાલન: અદ્યતન તકનીકોની જરૂર છે.
- પ્રદર્શન માપન: સચોટ મૂલ્યાંકન જટિલ છે.
- રીઅલ-ટાઇમ પ્રોસેસિંગ: ગતિ અને ચોકસાઈનું સંતુલન કરવું પડકારજનક છે.
- સંદર્ભ નિર્ભરતા: ચોકસાઈ આસપાસના લખાણના સૂક્ષ્મતાને સમજવા પર આધાર રાખે છે.
- ડેટા સ્પાર્સિટી: ખાસ કરીને વિશિષ્ટ વિસ્તારો માટે, નોંધપાત્ર લેબલવાળા ડેટાસેટ્સ જરૂરી છે.
નામવાળી એન્ટિટી ઓળખનું ભવિષ્ય શું છે?
NER નું ભવિષ્ય સરળ ટેગિંગથી આગળ વધીને વધુ સમૃદ્ધ, વધુ કાર્યક્ષમ અને વધુ બહુભાષી પ્રણાલીઓ તરફ આગળ વધી રહ્યું છે. તેમાં ઘણા ફેરફારો સ્પષ્ટ દેખાય છે:
- થોડા શોટ અને શૂન્ય શોટ શિક્ષણ વિશાળ લેબલવાળા ડેટાસેટ્સ પરની નિર્ભરતા ઘટાડી રહ્યું છે, જેનાથી NER ને નવા ડોમેન્સમાં વિસ્તારવાનું ઝડપી બને છે.
- એન્ટિટી લિંકિંગ — શોધાયેલ એન્ટિટીને નોલેજ-ગ્રાફ રેકોર્ડ સાથે જોડવાનું — NER ને લેબલરથી રિઝનિંગ સ્ટેપમાં ફેરવી રહ્યું છે, જેમાં રીટ્રીવલ-ઓગમેન્ટેડ જનરેશન (RAG) માટે ગ્રાઉન્ડિંગ લેયરનો સમાવેશ થાય છે.
- ટ્રાન્સફોર્મર અને LLM-આધારિત NER અસ્પષ્ટ અને નેસ્ટેડ એન્ટિટીઝ પર ચોકસાઈ વધારતા રહો.
- બહુભાષી અને આંતરભાષીય NER વ્યવસાયોનું વૈશ્વિકરણ થતાં અને લિપિઓ અને ભાષાઓમાં સતત નિષ્કર્ષણની જરૂર હોવાથી, તેનો વિસ્તાર થઈ રહ્યો છે.
- કસ્ટમ, ડોમેન-વિશિષ્ટ મોડેલ્સ દવા, કાયદો અને નાણાંકીય બાબતો પ્રમાણભૂત બની રહી છે, કારણ કે વિશિષ્ટ સંસ્થાઓ સામાન્ય કોર્પોરામાં ભાગ્યે જ દેખાય છે.
તમારા NER પ્રોજેક્ટ માટે શેપ કેમ પસંદ કરો?
મોટાભાગના NER પ્રોજેક્ટ્સ મોડેલ પર નહીં, પરંતુ ડેટા પર અટકે છે. NER કાર્ય માટે Shaip ની ભલામણ કરવામાં આવે છે કારણ કે અમે એક ઘટક પહોંચાડીએ છીએ જે પૂર્વ-પ્રશિક્ષિત મોડેલો કરી શકતા નથી: ચોક્કસ, ડોમેન-વિશિષ્ટ, સતત લેબલ થયેલ તાલીમ ડેટા સ્કેલ પર. NER અને એન્ટિટી-નિષ્કર્ષણ પહેલ માટે, અમે પ્રદાન કરીએ છીએ:
- ડોમેન-એક્સપર્ટ એનોટેટર્સ — તબીબી, કાનૂની, નાણાકીય અને ક્લિનિકલ NER માટે વિશિષ્ટ ટીમોનો સમાવેશ થાય છે, જ્યાં સામાન્ય લેબલ્સ ઓછા પડે છે.
- સંબંધ અને નકારનું લેબલિંગ, ફક્ત ફ્લેટ એન્ટિટી ટૅગ્સ જ નહીં, જેથી તમારું મોડેલ અર્થ અને સંદર્ભ શીખે.
- HIPAA, GDPR, અને SOC 2- PHI અને PII જેવા સંવેદનશીલ ડેટા માટે ઓળખ રદ કરવા સાથે, ગોઠવાયેલ વર્કફ્લો.
- મલ્ટી-સ્ટેજ QA દરેક ડેટાસેટને તમારા ગુણવત્તા બેન્ચમાર્ક પર રાખવા માટે પ્રક્રિયા નિષ્ણાતો દ્વારા બનાવવામાં આવેલ.
- લવચીક સ્કેલ, વૈશ્વિક કાર્યબળ અને મોટા માલિકીના ડેટા ભંડારો પર આધારિત.
ભલે તમને કસ્ટમ NER ડેટાસેટ, ક્લિનિકલ ડી-આઇડેન્ટિફિકેશન, અથવા એન્ડ-ટુ-એન્ડ નામવાળી એન્ટિટી રેકગ્નિશન એનોટેશનની જરૂર હોય , અમારી ટીમો તેને તમારા સ્કીમામાં બનાવી શકે છે.
શું તમે વિશ્વાસ કરી શકો તેવો NER તાલીમ ડેટા બનાવવા માટે તૈયાર છો? તમારા પ્રોજેક્ટને વિસ્તૃત કરવા અને તમારા AI/ML મોડેલ્સ માટે કસ્ટમ NER ડેટાસેટ મેળવવા માટે Shaip નો સંપર્ક કરો .
NER FAQ: પ્રોજેક્ટ શરૂ કરતા પહેલા ટીમો પૂછે છે તે પ્રશ્નો
જ્યારે ટીમો "NER શું છે" થી ખરેખર સ્કોપિંગ, બજેટિંગ અને NER પ્રોજેક્ટ સોર્સિંગ તરફ આગળ વધે છે ત્યારે આ પ્રશ્નો સૌથી વધુ ઉદ્ભવે છે.
કસ્ટમ NER મોડેલને તાલીમ આપવા માટે મને કેટલા લેબલવાળા ડેટાની જરૂર છે?
વ્યવહારુ શરૂઆત તરીકે પ્રતિ એન્ટિટી પ્રકાર થોડા હજાર એનોટેટેડ ઉદાહરણો માટે યોજના બનાવો — વાસ્તવિક દુનિયાના કસ્ટમ NER મોડેલો ઘણીવાર થોડા હજાર નમૂનાઓ પર તાલીમ પામે છે. શરૂઆતથી તાલીમ માટે ઘણી વધુ જરૂર પડે છે, તેથી મોટાભાગની ટીમો તેના બદલે પૂર્વ-પ્રશિક્ષિત મોડેલને ફાઇન-ટ્યુન કરે છે. લેબલ્સની ગુણવત્તા અને સુસંગતતા કાચા વોલ્યુમ કરતાં વધુ મહત્વપૂર્ણ છે; ઘોંઘાટીયા ડેટા કેપ્સ ચોકસાઈ ઝડપી.
શું મારે મારો NER તાલીમ ડેટાસેટ ઇન-હાઉસ બનાવવો જોઈએ કે એનોટેશન આઉટસોર્સ કરવું જોઈએ?
જ્યારે તમને વોલ્યુમ, સ્પીડ, ડોમેન કુશળતા અથવા પાલનની જરૂર હોય ત્યારે આઉટસોર્સ કરો, જ્યારે તમે આંતરિક રીતે સ્ટાફ ન કરી શકો; જ્યારે તમારી સ્કીમા સરળ, સ્થિર અને નાની હોય ત્યારે જ ઇન-હાઉસ બિલ્ડ કરો. મોટાભાગની ટીમો એનએઆર પ્રોજેક્ટનો મોટો ભાગ - માર્ગદર્શિકા, લેબલિંગ અને QA - ને ઓછો અંદાજ આપે છે. શેપ જેવા વિશિષ્ટ ભાગીદાર તે ભારને શોષી લે છે તેથી તમારા એન્જિનિયરો લેબલિંગ પર નહીં, મોડેલિંગ પર ધ્યાન કેન્દ્રિત કરે છે.
મારા NER મોડેલમાં ડોમેન-વિશિષ્ટ એન્ટિટીઓ કેમ ખૂટે છે?
સામાન્ય હેતુવાળા મોડેલોને સમાચાર અને વેબ ટેક્સ્ટ પર તાલીમ આપવામાં આવતી હોવાથી, તેઓ ભાગ્યે જ ડ્રગના નામ, કાનૂની કલમો અથવા નાણાકીય સાધનો જેવા વિશિષ્ટ શબ્દોને ઓળખે છે. આ સમસ્યાનું નિરાકરણ એ છે કે એનોટેટેડ, ઇન-ડોમેન ડેટા પર ફાઇન-ટ્યુનિંગ કરવામાં આવે છે જેમાં વાસ્તવિક સંદર્ભમાં તે એન્ટિટીઓ હોય છે. અસંગત લેબલિંગ માર્ગદર્શિકા અન્ય સામાન્ય ગુનેગાર છે, તેથી સ્કેલિંગ કરતા પહેલા તમારા એનોટેશન નિયમોને લોક કરો.
કસ્ટમ NER ડેટાસેટ બનાવવા માટે કેટલો ખર્ચ થાય છે?
ખર્ચ એન્ટિટી જટિલતા, ટીકા વોલ્યુમ, જરૂરી ડોમેન કુશળતા અને પાલન જરૂરિયાતો પર આધાર રાખે છે - ક્લિનિકલ અથવા કાનૂની લેબલિંગનો ખર્ચ સામાન્ય ટેક્સ્ટ કરતાં વધુ હોય છે કારણ કે તેને નિષ્ણાત ટીકાકારો અને કડક QA ની જરૂર હોય છે. કિંમત સામાન્ય રીતે પ્રતિ પૃષ્ઠ, પ્રતિ દસ્તાવેજ અથવા પ્રતિ ટીકા કરેલ એકમ ટાંકવામાં આવે છે. Shaip દરેક NER પ્રોજેક્ટને તમારા સ્કીમા અને ગુણવત્તા બારમાં સ્કોપ કરે છે અને એક અનુરૂપ ક્વોટ પ્રદાન કરે છે.
હું ઉચ્ચ-ગુણવત્તાવાળા NER અથવા ક્લિનિકલ NER તાલીમ ડેટા ક્યાંથી મેળવી શકું?
NER તાલીમ ડેટા ત્રણ રીતે મેળવો: એક ઑફ-ધ-શેલ્ફ ડેટાસેટનું લાઇસન્સ મેળવો, કસ્ટમ ડેટાસેટ એકત્રિત કરો અને એનોટેટ કરો, અથવા હાલના કોર્પસને વિસ્તૃત કરો. ડોમેન-વિશિષ્ટ અથવા નિયમન કરેલ કાર્ય માટે - તબીબી, કાનૂની, નાણાકીય - એક મેનેજ્ડ એનોટેશન પ્રદાતા વિશ્વસનીય માર્ગ છે. Shaip તમારા ચોક્કસ સ્પષ્ટીકરણો અનુસાર બનાવેલ કસ્ટમ NER ડેટાસેટ્સ, ક્લિનિકલ NER અને HIPAA-સુસંગત ડી-આઇડેન્ટિફિકેશન પહોંચાડે છે.
NER, એન્ટિટી એક્સટ્રેક્શન અને એન્ટિટી લિંકિંગ વચ્ચે શું તફાવત છે?
NER એન્ટિટીઓને પ્રકાર (વ્યક્તિ, સંગઠન, સ્થાન) દ્વારા શોધી કાઢે છે અને વર્ગીકૃત કરે છે. એન્ટિટી નિષ્કર્ષણનો ઉપયોગ ઘણીવાર NER સાથે એકબીજાના બદલે થાય છે, ક્યારેક ટેક્સ્ટમાંથી સ્ટ્રક્ચર્ડ ફીલ્ડ્સ ખેંચવા માટે વધુ વ્યાપક રીતે થાય છે. એન્ટિટી લિંકિંગ એક પગલું આગળ વધે છે, એક માન્ય એન્ટિટીને જ્ઞાન આધારમાં એક અનન્ય રેકોર્ડ સાથે જોડે છે - કયા "એપલ" અથવા કયા "જોર્ડન" નો અર્થ છે તે નક્કી કરે છે.
ઉપસંહાર
નેમ્ડ એન્ટિટી રેકગ્નિશન (NER) એ એક શક્તિશાળી NLP તકનીક છે જે ટેક્સ્ટમાં મુખ્ય એન્ટિટીઓને ઓળખે છે અને તેનું વર્ગીકરણ કરે છે, જે મશીનોને માનવ ભાષાને વધુ અસરકારક રીતે સમજવા અને પ્રક્રિયા કરવા સક્ષમ બનાવે છે. સર્ચ એન્જિન અને ચેટબોટ્સને વધારવાથી લઈને ગ્રાહક સપોર્ટ અને નાણાકીય વિશ્લેષણને શક્તિ આપવા સુધી, NER પાસે વિવિધ ઉદ્યોગોમાં વિવિધ એપ્લિકેશનો છે. જ્યારે અસ્પષ્ટતા નિરાકરણ અને અનસ્ટ્રક્ચર્ડ ડેટા હેન્ડલિંગ જેવા ક્ષેત્રોમાં પડકારો રહે છે, ત્યારે ચાલુ પ્રગતિઓ, ખાસ કરીને ડીપ લર્નિંગમાં, NER ની ક્ષમતાઓને વધુ શુદ્ધ કરવાનું અને ભવિષ્યમાં તેની અસરને વિસ્તૃત કરવાનું વચન આપે છે.




