ઇન્ટરનેટ એક વિશાળ, હંમેશા ચાલુ રહેતું ફોકસ ગ્રુપ બની ગયું છે. ગ્રાહકો પ્રોડક્ટ સમીક્ષાઓ, એપ સ્ટોર ટિપ્પણીઓ, સપોર્ટ ચેટ્સ, સોશિયલ મીડિયા પોસ્ટ્સ અને કોમ્યુનિટી ફોરમમાં મંતવ્યો શેર કરે છે - ઘણીવાર એક જ વાતચીતમાં ભાષાઓ અને બોલીઓ વચ્ચે સ્વિચ કરે છે.
જો તમે ફક્ત અંગ્રેજીનું વિશ્લેષણ કરો છો, તો તમે તમારા ગ્રાહકો ખરેખર શું અનુભવે છે તેના મોટા ભાગને અવગણી રહ્યા છો.
તાજેતરના અંદાજો સૂચવે છે કે વિશ્વની વસ્તીના આશરે 13% લોકો અંગ્રેજી બોલે છે , અને લગભગ 25% લોકો તેને સમજે છે . તેનો અર્થ એ કે મોટાભાગની ગ્રાહક વાતચીત અન્ય ભાષાઓમાં થાય છે.
તે જ સમયે, વૈશ્વિક સેન્ટિમેન્ટ એનાલિટિક્સ બજાર ઝડપથી વિસ્તરી રહ્યું છે. 2024 માં તેનું મૂલ્ય ~ US$5.1 બિલિયન હતું અને 2030 સુધીમાં US$11.4 બિલિયન સુધી પહોંચવાનો અંદાજ છે . વ્યવસાયો સ્પષ્ટપણે લાગણીઓને સ્કેલ પર સમજવાના મૂલ્યને ઓળખે છે.
આ તે જગ્યા છે જ્યાં બહુભાષી ભાવના વિશ્લેષણનો ઉપયોગ થાય છે.
બહુભાષી ભાવના વિશ્લેષણ શું છે?
બહુભાષી ભાવના વિશ્લેષણ એ સમીક્ષાઓ, સોશિયલ મીડિયા, ચેટ લોગ અને સર્વેક્ષણો જેવી વપરાશકર્તા-જનરેટેડ સામગ્રીમાં બહુવિધ ભાષાઓમાં વ્યક્ત કરાયેલા મંતવ્યો - સકારાત્મક, નકારાત્મક અથવા તટસ્થ - આપમેળે ઓળખવા અને વર્ગીકૃત કરવાની પ્રક્રિયા છે.
તે સંયોજિત કરે છે:
- નેચરલ લેંગ્વેજ પ્રોસેસીંગ (એનએલપી)
- મશીન લર્નિંગ / ડીપ લર્નિંગ મોડેલ્સ
- ભાષા-વિશિષ્ટ ડેટા અને લેક્સિકોન્સ
એક સરળ પ્રશ્નનો જવાબ આપવા માટે, મોટા પાયે:
"લોકો મારા ઉત્પાદન, સેવા, બ્રાન્ડ અથવા મુદ્દા વિશે તેઓ જે પણ ભાષા વાપરે છે તે વિશે કેવું અનુભવે છે?"
2025 અને તે પછીના સમયમાં બહુભાષી ભાવના વિશ્લેષણ શા માટે મહત્વનું છે
૧. તમારા ગ્રાહકો અંગ્રેજીમાં વિચારી રહ્યા નથી
૧.૪-૧.૫ અબજથી વધુ લોકો અંગ્રેજી બોલે છે, પરંતુ તે હજુ પણ વિશ્વની વસ્તીના પાંચમા ભાગથી પણ ઓછી વસ્તીનું પ્રતિનિધિત્વ કરે છે. ઘણા ગ્રાહકો જ્યારે તેમની માતૃભાષામાં લખે છે ત્યારે તેઓ વધુ અભિવ્યક્ત અને વધુ પ્રમાણિક હોય છે.
જો તમે ફક્ત અંગ્રેજી સામગ્રીનું વિશ્લેષણ કરો છો, તો તમને જોખમ રહેલું છે:
- બિન-અંગ્રેજી બજારોમાં નકારાત્મક ભાવના નિર્માણનો અભાવ
- "શાંત" ભાગોને કેપ્ચર ન કરવામાં આવતાં સંતોષનો વધુ પડતો અંદાજ લગાવવો
- સ્થાનિક અપેક્ષાઓ અનુસાર ન હોય તેવી સુવિધાઓ અથવા ઝુંબેશો ડિઝાઇન કરવી
2. ગ્રાહક અનુભવ માટે AI પહેલેથી જ કેન્દ્રિય છે.
2023 ના ગાર્ટનર અભ્યાસમાં જાણવા મળ્યું છે કે 80% કંપનીઓ ગ્રાહક અનુભવ સુધારવા માટે AI નો ઉપયોગ કરી રહી છે, અને ગ્રાહક સેવા સર્વેક્ષણો દર્શાવે છે કે લગભગ અડધા સપોર્ટ ટીમો પહેલાથી જ AI નો ઉપયોગ કરે છે, 89% સંપર્ક કેન્દ્રો AI-સંચાલિત ચેટબોટ્સનો ઉપયોગ કરે છે.
જો AI પહેલાથી જ તમારા CX સ્ટેકમાં હોય, તો બહુભાષી ભાવના એ કુદરતી આગલું પગલું છે: તે તમને જણાવે છે કે ગ્રાહકો ફક્ત અંગ્રેજી બોલતા બજારોમાં જ નહીં, પરંતુ દરેક ચેનલમાં કેવું અનુભવે છે.
૩. લાગણી સંસ્કૃતિ સાથે જોડાયેલી છે, ફક્ત શબ્દો સાથે નહીં.
ભાષા સંસ્કૃતિ અને સ્થાનિક ધોરણો સાથે ગાઢ રીતે જોડાયેલી છે. એક સંસ્કૃતિમાં તટસ્થ શબ્દસમૂહ, ઇમોજી અથવા રૂઢિપ્રયોગ બીજી સંસ્કૃતિમાં અપમાનજનક, રમૂજી અથવા કટાક્ષપૂર્ણ હોઈ શકે છે. જો તમારું સેન્ટિમેન્ટ મોડેલ તે સૂક્ષ્મતાનો આદર નહીં કરે, તો તે ટીકાત્મક સંકેતોને ખોટી રીતે સમજશે અને વિશ્વાસને નુકસાન પહોંચાડશે.
બહુભાષી ભાવના વિશ્લેષણ કેવી રીતે કાર્ય કરે છે - ડેટાથી નિર્ણયો સુધી
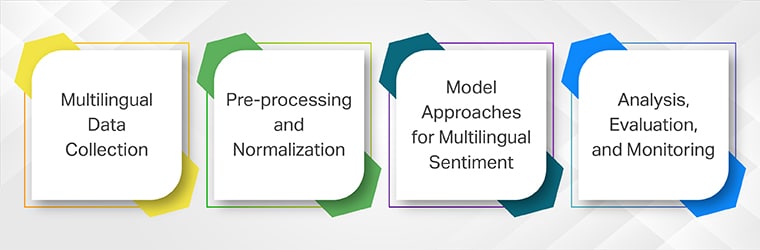
ઉચ્ચ સ્તરે, બહુભાષી ભાવના વિશ્લેષણ ચાર મુખ્ય પગલાંને અનુસરે છે:
- બહુવિધ ભાષાઓમાં ડેટા એકત્રિત કરો
- તે ડેટાને સાફ કરો અને સામાન્ય બનાવો
- એક અથવા વધુ સેન્ટિમેન્ટ મોડેલ લાગુ કરો
- પરિણામોને ડેશબોર્ડ અને રિપોર્ટ્સમાં એકત્રિત કરો
ચાલો દરેક પગલા પર ટૂંકમાં નજર કરીએ.
૧. બહુભાષી માહિતી સંગ્રહ
સારી બહુભાષી ભાવના પ્રણાલી બનાવવા માટે, તમારે પહેલા વિવિધ ચેનલો અને ભાષાઓમાંથી યોગ્ય ડેટાની જરૂર પડશે, ઉદાહરણ તરીકે:
- ઉત્પાદન સમીક્ષાઓ અને એપ સ્ટોર પ્રતિસાદ
- સોશિયલ મીડિયા પોસ્ટ્સ અને ટિપ્પણીઓ
- કોલ સેન્ટર ટ્રાન્સક્રિપ્ટ અને ચેટ લોગ
- NPS / CSAT સર્વેક્ષણો અને ખુલ્લા અંતવાળા પ્રતિસાદ
- ઉદ્યોગ-વિશિષ્ટ સ્ત્રોતો (દા.ત., તબીબી નોંધો, નાણાકીય સમાચાર, નીતિ મંચ)
દરેક ભાષા માટે, તમારે સામાન્ય રીતે આની જરૂર પડે છે:
- કાચો લખાણ, જે ઘણીવાર ઘોંઘાટીયા અને અસંગઠિત હોય છે
- તમારા મોડેલોને તાલીમ આપવા અને પરીક્ષણ કરવા માટે લેબલ થયેલ સેન્ટિમેન્ટ ડેટા (સકારાત્મક/નકારાત્મક/તટસ્થ અથવા વધુ વિગતવાર લેબલ્સ)
આધુનિક બહુભાષી ડેટાસેટ્સ ઘણીવાર ડઝનેક ભાષાઓને આવરી લે છે, પરંતુ ઘણી સંસ્થાઓને હજુ પણ કસ્ટમ, ડોમેન-વિશિષ્ટ ડેટાની જરૂર હોય છે. આ તે જગ્યા છે જ્યાં Shaip જેવા ભાગીદાર બહુવિધ ભાષાઓમાં સ્વચ્છ, ટીકાયુક્ત ટેક્સ્ટ પ્રદાન કરીને મદદ કરે છે જેથી તમારા મોડેલો શૂન્યથી શરૂ ન થાય.
2. પૂર્વ-પ્રોસેસિંગ અને નોર્મલાઇઝેશન
મોડેલિંગ કરતા પહેલા, ટેક્સ્ટને સાફ અને પ્રમાણિત કરવું આવશ્યક છે, ખાસ કરીને જ્યારે તે સોશિયલ મીડિયા જેવા અનૌપચારિક સ્ત્રોતોમાંથી આવે છે.
લાક્ષણિક પગલાંઓમાં શામેલ છે:
- અવાજ દૂર કરવો - HTML, બોઈલરપ્લેટ, જાહેરાતો વગેરે કાઢી નાખો.
- ભાષા શોધ - ટેક્સ્ટને યોગ્ય ભાષા પાઇપલાઇનમાં રૂટ કરો
- ટોકનાઇઝેશન અને નોર્મલાઇઝેશન - ઇમોજીસ, હેશટેગ્સ, URL, વિસ્તૃત શબ્દો ("cooooool"), જોડણીના પ્રકારો અને મિશ્ર-ભાષાના ટેક્સ્ટને હેન્ડલ કરો.
- ભાષાકીય પ્રક્રિયા - વાક્ય વિભાજન, શબ્દભંડોળ દૂર કરવું, લેમેટાઇઝેશન અથવા સ્ટેમિંગ, અને ભાષણનો ભાગ ટેગિંગ
બહુભાષી ભાવના માટે, પ્રી-પ્રોસેસિંગમાં ઘણીવાર ભાષા- અને ડોમેન-વિશિષ્ટ નિયમોનો સમાવેશ થાય છે જેથી કટાક્ષ અથવા સ્થાનિક અશિષ્ટ ભાષા જેવી બાબતોને વધુ સારી રીતે કેપ્ચર કરી શકાય.
૩. બહુભાષી ભાવના માટે મોડેલ અભિગમો
બહુભાષી ભાવનાનું મોડેલ બનાવવાની ચાર મુખ્ય રીતો છે:
- અનુવાદ-આધારિત પાઇપલાઇન્સ: દરેક વસ્તુનો એક જ ભાષામાં (સામાન્ય રીતે અંગ્રેજી) અનુવાદ કરો અને હાલના સેન્ટિમેન્ટ મોડેલ ચલાવો.
- ફાયદા: સેટઅપમાં ઝડપી, હાલના મોડેલોનો ફરીથી ઉપયોગ કરે છે
- ગેરફાયદા: અનુવાદમાં સૂક્ષ્મતા ગુમાવી શકાય છે, ખાસ કરીને રૂઢિપ્રયોગો, કટાક્ષ અને ઓછા સંસાધન ધરાવતી ભાષાઓ માટે.
- મૂળ બહુભાષી મોડેલો: બહુભાષી ટ્રાન્સફોર્મર મોડેલ્સ (દા.ત., mBERT, XLM-RoBERTa) નો ઉપયોગ કરો જે ઘણી ભાષાઓમાં તાલીમ પામેલા હોય.
- ફાયદા: ઘણી ભાષાઓને સીધી રીતે હેન્ડલ કરો, સૂક્ષ્મતાને વધુ સારી રીતે સાચવો, મજબૂત એકંદર પ્રદર્શન
- ગેરફાયદા: હજુ પણ ઉચ્ચ-સંસાધન ભાષાઓને પસંદ કરી શકે છે; બોલીઓ અને ઓછા-સંસાધન ભાષાઓને વધારાના ટ્યુનિંગની જરૂર છે
- આંતરભાષીય એમ્બેડિંગ્સ: વિવિધ ભાષાઓના ટેક્સ્ટને એક શેર કરેલ વેક્ટર સ્પેસમાં મેપ કરો જેથી સમાન અર્થો એકબીજાની નજીક આવે (દા.ત., "ખુશ", "ફેલિઝ", "હ્યુરેક્સ").
- ફાયદા: એક ભાષામાં તાલીમ પામેલો વર્ગીકરણ કરનાર ઘણીવાર અન્ય ભાષાને સામાન્ય બનાવી શકે છે.
- ગેરફાયદા: હજુ પણ સારા આંતરભાષીય ડેટા અને કવરેજ પર આધાર રાખે છે
- LLM-આધારિત / શૂન્ય-શોટ સેન્ટિમેન્ટ વિશ્લેષણ: મોટા ભાષા મોડેલો (LLMs) અને પ્રોમ્પ્ટનો ઉપયોગ કરીને લાગણીઓનું સીધું વર્ગીકરણ કરો, ઘણીવાર ઓછા અથવા કોઈ લેબલવાળા ડેટા સાથે.
- ફાયદા: લવચીક, ઘણી ભાષાઓ અને ક્ષેત્રોમાં કાર્ય કરે છે, શોધખોળ માટે સારું
- ગેરફાયદા: ભાષા પ્રમાણે પરિવર્તનશીલ કામગીરી, મોટા પાયે ઉત્પાદન માટે ધીમી અને વધુ ખર્ચાળ હોઈ શકે છે.
વ્યવહારમાં, ઘણી ટીમો હાઇબ્રિડ અભિગમનો ઉપયોગ કરે છે: - ઉચ્ચ-વોલ્યુમ ઉત્પાદન વર્કલોડ માટે બહુભાષી ટ્રાન્સફોર્મર્સ
- નવી ભાષાઓ, જટિલ મંતવ્યો અને ગુણવત્તા ચકાસણી માટે LLM
૪. વિશ્લેષણ, મૂલ્યાંકન અને દેખરેખ
તમારી બહુભાષી ભાવના પ્રણાલી પર વિશ્વાસ કરવા માટે, તમારે તેનું સતત માપન અને નિરીક્ષણ કરવું જોઈએ:
- ભાષા દીઠ મેટ્રિક્સ - ચોકસાઈ, ચોકસાઈ, રિકોલ, દરેક ભાષા માટે F1
- મેક્રો વિરુદ્ધ માઇક્રો એવરેજ - અસંતુલિત ડેટાસેટ્સ પર પ્રદર્શન સમજવા માટે
- ભૂલ વિશ્લેષણ - મોડેલ નકાર ("ખરાબ નથી"), કટાક્ષ, ઇમોજીસ, અશિષ્ટ ભાષા અને કોડ-સ્વિચ્ડ ટેક્સ્ટને કેવી રીતે હેન્ડલ કરે છે તે તપાસો.
- સતત દેખરેખ - ભાષા, અશિષ્ટ ભાષા અને ગ્રાહક વર્તનના વિકાસ સાથે મોડેલો અને ડેટાને અપડેટ કરો.
આ લૂપ ખાતરી કરે છે કે તમારી સિસ્ટમ સચોટ, ન્યાયી અને વાસ્તવિક વપરાશકર્તાઓ દરેક ભાષામાં કેવી રીતે વાતચીત કરે છે તેની સાથે સંરેખિત રહે.
બહુભાષી ભાવના વિશ્લેષણમાં પડકારો
૧. ભાષાકીય વિવિધતા અને સાંસ્કૃતિક સૂક્ષ્મતા
દરેક ભાષાની પોતાની હોય છે:
- લેક્સિકોન અને મોર્ફોલોજી
- વાક્યરચના અને શબ્દ ક્રમ
- રૂઢિપ્રયોગો, અશિષ્ટ ભાષા અને શિષ્ટાચારની વ્યૂહરચનાઓ
અસરકારક માર્કર્સ ઘણીવાર સૂક્ષ્મ અને સંસ્કૃતિમાં ઊંડાણપૂર્વક જડાયેલા હોય છે , જે બહુભાષી ભાવનાને ખાસ કરીને પડકારજનક બનાવે છે.
ઉદાહરણ: સાંસ્કૃતિક સંદર્ભના આધારે - અને ક્યારેક પ્લેટફોર્મ પર જ - સમાન ઇમોજી કૃતજ્ઞતા, માફી, કટાક્ષ અથવા ચીડ વ્યક્ત કરી શકે છે.
જેમ નોઆમ ચોમ્સ્કીએ પ્રખ્યાત રીતે કહ્યું હતું, "ભાષા ફક્ત શબ્દો નથી; તે એક સંસ્કૃતિ, પરંપરા, સમુદાયનું એકીકરણ છે."
સારી બહુભાષી ભાવના પ્રણાલીઓએ માત્ર શબ્દભંડોળ જ નહીં, પણ સંસ્કૃતિનું મોડેલ બનાવવું જોઈએ.
2. ઓછા સંસાધન ધરાવતી ભાષાઓ અને ડોમેન્સ
મોટાભાગના ખુલ્લા ડેટાસેટ્સ અને ટૂલ્સ મુઠ્ઠીભર ઉચ્ચ-સંસાધન ભાષાઓમાં કેન્દ્રિત છે.
ઘણી ભાષાઓ અને બોલીઓ માટે:
- ત્યા છે થોડા અથવા કોઈ લેબલવાળા ડેટાસેટ્સ નથી.
- સોશિયલ મીડિયા ટેક્સ્ટ ખૂબ જ ઘોંઘાટીયા અને કોડ-સ્વિચ્ડ છે.
- ડોમેન-વિશિષ્ટ પરિભાષા (તબીબી, નાણાકીય, કાનૂની) ઓછી રજૂ કરવામાં આવી છે.
તાજેતરના સંશોધનો મોટા બહુભાષી સંગઠનો સાથે આને સંબોધિત કરી રહ્યા છે, પરંતુ તે એક મુખ્ય અવરોધ રહે છે, ખાસ કરીને ઉભરતા બજારોમાં કાર્યરત કંપનીઓ માટે.
૩. અનુવાદ-પ્રેરિત ભાવનામાં પરિવર્તન
મશીન અનુવાદમાં નાટ્યાત્મક સુધારો થયો છે, પરંતુ:
- કટાક્ષ, રમૂજ અને સૂક્ષ્મતા હજુ પણ નિયમિતપણે તેને તોડે છે.
- કેટલીક ભાષાઓ ભાવનાની તીવ્રતાને અલગ રીતે સંકુચિત અથવા વિસ્તૃત કરે છે.
- સારાંશ અથવા આક્રમક લખાણ ટૂંકાણ ભાવનાને વિકૃત કરી શકે છે, ખાસ કરીને ફિનિશ અથવા અરબી જેવી વિકૃત ભાષાઓમાં.
૪. પક્ષપાત, ન્યાયીપણા અને નીતિશાસ્ત્ર
જો તાલીમ ડેટા ચોક્કસ સંસ્કૃતિઓ અથવા ભાષાની વિવિધતાઓનું વધુ પડતું પ્રતિનિધિત્વ કરે છે (દા.ત., યુએસ અંગ્રેજી, પશ્ચિમી યુરોપિયન ભાષાઓ), તો મોડેલો આ કરી શકે છે:
- ઓછા પ્રતિનિધિત્વ ધરાવતા જૂથોની ભાવનાનું ખોટું અર્થઘટન કરવું
- અમુક ભાષાઓમાંથી સામગ્રીને "ઝેરી" અથવા "નકારાત્મક" તરીકે વધુ પડતી ફ્લેગ કરવી
- માનસિક સ્વાસ્થ્ય અથવા આરોગ્યસંભાળ સંદર્ભોમાં તકલીફના સંકેતો શોધવામાં નિષ્ફળતા.
જવાબદાર બહુભાષી ભાવના વિશ્લેષણ માટે વિવિધ ડેટાસેટ્સ, સતત પૂર્વગ્રહ તપાસ અને મૂળ બોલનારાઓ સાથે સહયોગની જરૂર પડે છે.
[આ પણ વાંચો: શા માટે બહુભાષી AI ટેક્સ્ટ ડેટા એડવાન્સ્ડ AI મોડેલ્સને તાલીમ આપવા માટે મહત્વપૂર્ણ છે ]
બહુભાષી ભાવના વિશ્લેષણના વાસ્તવિક ઉપયોગના કિસ્સાઓ
અહીં વિવિધ ઉદ્યોગોના નક્કર ઉદાહરણો છે (તમે વિગતોને તમારા કેસ સ્ટડી અને NDA સાથે અનુકૂલિત કરી શકો છો).
વિચાર નેતૃત્વ: નિષ્ણાત દ્રષ્ટિકોણ
તમે થોડા ટૂંકા, વિશ્વસનીય દ્રષ્ટિકોણથી ગૂંથણ કરી શકો છો (૨૫ શબ્દોથી ઓછા સીધા અવતરણો રાખો):
- ભાષા અને સંસ્કૃતિ પર
ભાષાશાસ્ત્રીઓ અને કૃત્રિમ બુદ્ધિ સંશોધકો વારંવાર ભાર મૂકે છે કે ભાષા સંસ્કૃતિને એન્કોડ કરે છે; એક જ શબ્દો સમુદાયોમાં અલગ અલગ મૂલ્યો અને લાગણીઓને પ્રતિબિંબિત કરી શકે છે. - ઓછા સંસાધન ધરાવતી ભાષાઓ અને કોર્પોરેટ્સ પર
વિશાળ બહુભાષી ભાવના માપદંડો પર તાજેતરના કાર્ય પર ભાર મૂકે છે કે ઉચ્ચ-ગુણવત્તાવાળા તાલીમ ડેટાનું નિર્માણ ઓછી રજૂઆત કરાયેલી ભાષાઓ ખરેખર વૈશ્વિક ભાવના વિશ્લેષણ માટે "સૌથી મહત્વપૂર્ણ અવરોધ" છે. - બહુભાષી ભાવનાના ભવિષ્ય પર
સેન્ટિમેન્ટ વિશ્લેષણ સાધનો અને એપ્લિકેશનોના સર્વેક્ષણો ભવિષ્યના કાર્યને પ્રકાશિત કરે છે ભાષાઓ અને પ્લેટફોર્મ પર ન્યાય-જાગૃત તાલીમ, ક્ષેત્ર અનુકૂલન અને મજબૂતાઈ મુખ્ય દિશાઓ તરીકે.
આ કાં તો ટૂંકા પુલ ક્વોટ્સ તરીકે દેખાઈ શકે છે અથવા તમારા "ભવિષ્યના વલણો" અથવા "પડકારો" વિભાગોમાં સમજાવી શકાય છે.

બહુભાષી ભાવના પાઇપલાઇન બનાવવા માટેની શ્રેષ્ઠ પદ્ધતિઓ
વાચકો (અને સંભવિત ગ્રાહકો) ને સલાહ આપતી વખતે, તમે એક વ્યવહારુ ચેકલિસ્ટનો સમાવેશ કરી શકો છો:
૧. મોડેલ નહીં, પણ વ્યવસાયિક પ્રશ્નોથી શરૂઆત કરો
- ભાવના કયા નિર્ણયોને પ્રેરિત કરશે?
- કઈ ભાષાઓ અને પ્રદેશો સૌથી વધુ મહત્વપૂર્ણ છે?
2. વ્યૂહાત્મક રીતે ભાષાઓને પ્રાથમિકતા આપો
- ઉચ્ચ-પ્રભાવવાળા બજારોથી શરૂઆત કરો જ્યાં તમારી પાસે પૂરતો ડેટા અને આવક દાવ પર હોય.
૩. બહુભાષી તાલીમ ડેટામાં રોકાણ કરો
- Shaip જેવા પ્રદાતાઓ સાથે ભાગીદારી કરો મેન્યુઅલ એનોટેશન બહુવિધ ભાષાઓ અને ક્ષેત્રોમાં.
- ઝડપથી સ્કેલ કરવા માટે બુટસ્ટ્રેપિંગ (મશીન પ્રી-લેબલ, માનવ સુધારણા) નો ઉપયોગ કરો.
૪. યોગ્ય મોડેલ સ્ટેક પસંદ કરો
- બેઝલાઇન તરીકે અથવા લાંબી પૂંછડીવાળી ભાષાઓ માટે અનુવાદ-આધારિત અભિગમ.
- મુખ્ય ભાષાઓ માટે બહુભાષી ટ્રાન્સફોર્મર્સ (mBERT, XLM-R, વગેરે).
- જટિલ, સૂક્ષ્મ કાર્યો અથવા સંશોધન અને વિકાસ માટે LLM અને સંકેતો.
૫. ભાષા અને ચેનલ દીઠ મૂલ્યાંકન કરો
- ફક્ત વૈશ્વિક સરેરાશ જ નહીં, પણ ભાષા દીઠ મેટ્રિક્સનો અહેવાલ આપો.
- વાસ્તવિક ડેટા (ઘોંઘાટીયા સામાજિક, કોડ-સ્વિચ્ડ ચેટ લોગ, વગેરે) પર માન્યતા આપો.
૬. મોડેલો અને લેક્સિકોન્સને સતત અપડેટ કરો
- ભાષાઓ અને અશિષ્ટ ભાષાનો વિકાસ થાય છે; તમારી સિસ્ટમનો પણ વિકાસ થવો જોઈએ.
- સમયાંતરે તાલીમ ડેટા તાજું કરો અને ડ્રિફ્ટનું નિરીક્ષણ કરો.
શૈપ બહુભાષી ભાવના વિશ્લેષણમાં કેવી રીતે મદદ કરે છે
બહુભાષી ભાવના વિશ્લેષણ તેની પાછળના ડેટા જેટલું જ સારું છે .
શેપ પૂરી પાડે છે:
- વૈવિધ્યપૂર્ણ બહુભાષી ડેટા સંગ્રહ - સોશિયલ મીડિયા, સપોર્ટ લોગ, ડોમેન-વિશિષ્ટ સ્ત્રોતોમાંથી.
- નિષ્ણાત ટીકા અને ભાવના લેબલિંગ ભારતીય અને અન્ય ઉભરતી બજાર ભાષાઓ સહિત બહુવિધ ભાષાઓમાં.
- ગુણવત્તા-નિયંત્રિત, ડોમેન-વિશિષ્ટ ડેટાસેટ્સ જે તમારા ઉપયોગના કેસ સાથે મેળ ખાય છે (આરોગ્ય સંભાળ, વાતચીત AI, ઈકોમર્સ, ટેકનોલોજી, અને વધુ).
આ સંસ્થાઓને મદદ કરે છે:
- વિચારથી ઉત્પાદન મોડેલ સુધીનો સમય ઘટાડો
- ભાષાઓ અને બજારોમાં ચોકસાઈ વધારો
- વધુ ન્યાયી, વધુ પ્રતિનિધિત્વ કરતી AI સિસ્ટમો બનાવો
એક વ્યાપક બહુભાષી ડેટાસેટ એ મજબૂત બહુભાષી ભાવના વિશ્લેષણનો પાયો છે - અને શેપ તે જ પહોંચાડવામાં નિષ્ણાત છે.
અમારી લાગણી વિશ્લેષણ સેવાઓ કેવી રીતે કાર્ય કરે છે તેનું અન્વેષણ કરો.