AI, બિગ ડેટા અને મશીન લર્નિંગ વિશ્વભરના નીતિ નિર્માતાઓ, વ્યવસાયો, વિજ્ઞાન, મીડિયા હાઉસ અને વિવિધ ઉદ્યોગોને પ્રભાવિત કરવાનું ચાલુ રાખે છે. અહેવાલો સૂચવે છે કે 2022 માં AI નો વૈશ્વિક અપનાવવાનો દર હાલમાં 35% છે - જે 2021 થી 4% નો મોટો વધારો છે. અહેવાલ મુજબ, વધારાની 42% કંપનીઓ તેમના વ્યવસાય માટે AI ના ઘણા ફાયદાઓ શોધી રહી છે.
ઘણી બધી AI પહેલો અને મશીન લર્નિંગ સોલ્યુશન્સને ડેટા દ્વારા શક્તિ આપવામાં આવે છે. AI ફક્ત અલ્ગોરિધમને ફીડ કરતા ડેટા જેટલું જ સારું હોઈ શકે છે. ઓછી ગુણવત્તાવાળા ડેટાના પરિણામે ઓછી ગુણવત્તાવાળા પરિણામો અને ખોટી આગાહીઓ થઈ શકે છે.
જ્યારે ML અને AI સોલ્યુશન ડેવલપમેન્ટ પર ઘણું ધ્યાન આપવામાં આવ્યું છે, ત્યારે ગુણવત્તાયુક્ત ડેટાસેટ તરીકે શું લાયક ઠરે છે તેની જાગૃતિ ખૂટે છે. આ લેખમાં, અમે ગુણવત્તાયુક્ત AI તાલીમ ડેટાની સમયરેખાને નેવિગેટ કરીશું અને ડેટા સંગ્રહ અને તાલીમની સમજ દ્વારા AI ના ભવિષ્યને ઓળખીશું.
AI તાલીમ ડેટાની વ્યાખ્યા
ML સોલ્યુશન બનાવતી વખતે, તાલીમ ડેટાસેટનો જથ્થો અને ગુણવત્તા મહત્વપૂર્ણ છે. ML સિસ્ટમને માત્ર ગતિશીલ, નિષ્પક્ષ અને મૂલ્યવાન તાલીમ ડેટાના મોટા જથ્થાની જરૂર નથી, પરંતુ તેને તેની ઘણી જરૂર પણ છે.
પરંતુ AI તાલીમ ડેટા શું છે?
AI તાલીમ ડેટા એ લેબલવાળા ડેટાનો સંગ્રહ છે જેનો ઉપયોગ ML અલ્ગોરિધમને સચોટ આગાહીઓ કરવા માટે તાલીમ આપવા માટે થાય છે. ML સિસ્ટમ પેટર્નને ઓળખવા અને ઓળખવાનો, પરિમાણો વચ્ચેના સંબંધોને સમજવાનો, જરૂરી નિર્ણયો લેવાનો અને તાલીમ ડેટાના આધારે મૂલ્યાંકન કરવાનો પ્રયાસ કરે છે.
ઉદાહરણ તરીકે, સ્વ-ડ્રાઇવિંગ કારનું ઉદાહરણ લો. સ્વ-ડ્રાઇવિંગ ML મોડેલ માટેના તાલીમ ડેટાસેટમાં કાર, રાહદારીઓ, શેરી ચિહ્નો અને અન્ય વાહનોના લેબલવાળા છબીઓ અને વિડિઓઝ શામેલ હોવા જોઈએ.
ટૂંકમાં, ML અલ્ગોરિધમની ગુણવત્તા વધારવા માટે, તમારે મોટી માત્રામાં સારી રીતે સંરચિત, ટીકા કરેલ અને લેબલ થયેલ તાલીમ ડેટાની જરૂર છે.
ગુણવત્તાયુક્ત તાલીમ ડેટાનું મહત્વ અને તેનો વિકાસ
AI અને ML એપ્લિકેશન વિકાસમાં ઉચ્ચ-ગુણવત્તાવાળા તાલીમ ડેટા મુખ્ય ઇનપુટ છે. ડેટા વિવિધ સ્ત્રોતોમાંથી એકત્રિત કરવામાં આવે છે અને મશીન લર્નિંગ હેતુઓ માટે અયોગ્ય રીતે અસંગઠિત સ્વરૂપમાં રજૂ કરવામાં આવે છે. ગુણવત્તાયુક્ત તાલીમ ડેટા - લેબલ કરેલ, ટિપ્પણી કરેલ અને ટેગ કરેલ - હંમેશા સંગઠિત સ્વરૂપમાં હોય છે - ML તાલીમ માટે આદર્શ.
ગુણવત્તાયુક્ત તાલીમ ડેટા ML સિસ્ટમ માટે વસ્તુઓને ઓળખવાનું અને પૂર્વનિર્ધારિત સુવિધાઓ અનુસાર તેમને વર્ગીકૃત કરવાનું સરળ બનાવે છે. જો વર્ગીકરણ સચોટ ન હોય તો ડેટાસેટ ખરાબ મોડેલ પરિણામો આપી શકે છે.
AI તાલીમ ડેટાના શરૂઆતના દિવસો
વર્તમાન વ્યવસાય અને સંશોધન વિશ્વમાં AIનું પ્રભુત્વ હોવા છતાં, ML એ આર્ટિફિશિયલ ઇન્ટેલિજન્સનું પ્રભુત્વ મેળવ્યું તે પહેલાંના શરૂઆતના દિવસો તદ્દન અલગ હતા.
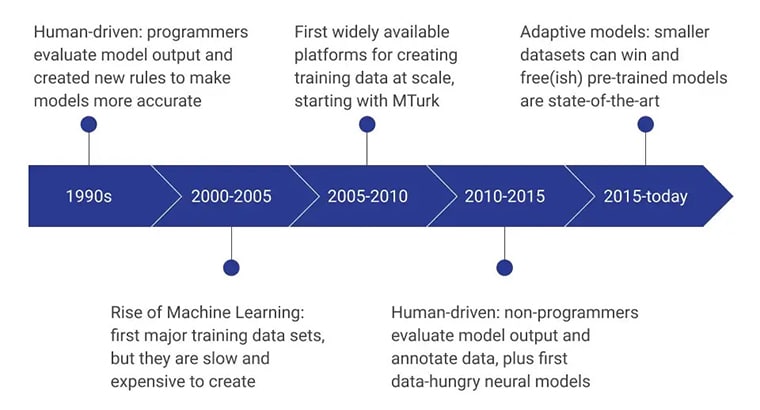
આગામી કેટલાક વર્ષોમાં, બિન-પ્રોગ્રામરો દ્વારા ડેટા મોડેલ બનાવવા અને તેનું મૂલ્યાંકન કરવા પર ધ્યાન કેન્દ્રિત કરવામાં આવ્યું. હાલમાં, અદ્યતન તાલીમ ડેટા સંગ્રહ પદ્ધતિઓનો ઉપયોગ કરીને વિકસાવવામાં આવેલા પૂર્વ-પ્રશિક્ષિત મોડેલો પર ધ્યાન કેન્દ્રિત કરવામાં આવ્યું છે.
ગુણવત્તા કરતાં જથ્થો
ભૂતકાળમાં AI તાલીમ ડેટાસેટ્સની અખંડિતતાનું મૂલ્યાંકન કરતી વખતે, ડેટા વૈજ્ઞાનિકો ગુણવત્તા કરતાં AI તાલીમ ડેટા જથ્થા પર ધ્યાન કેન્દ્રિત કરતા હતા.
ઉદાહરણ તરીકે, એક સામાન્ય ગેરસમજ હતી કે મોટા ડેટાબેઝ સચોટ પરિણામો આપે છે. ડેટાનું પ્રમાણ ડેટાના મૂલ્યનું સારું સૂચક માનવામાં આવતું હતું. ડેટાસેટનું મૂલ્ય નક્કી કરતા પ્રાથમિક પરિબળોમાંનું એક માત્ર જથ્થો છે - ડેટા ગુણવત્તાની ભૂમિકાને માન્યતા આપવામાં આવી હતી.
ડેટાની ગુણવત્તા ડેટાની સંપૂર્ણતા, વિશ્વસનીયતા, માન્યતા, ઉપલબ્ધતા અને સમયસરતા પર આધાર રાખે છે તે જાગૃતિ વધી. સૌથી અગત્યનું, પ્રોજેક્ટ માટે ડેટા યોગ્યતા એકત્રિત કરવામાં આવેલા ડેટાની ગુણવત્તા નક્કી કરે છે.
નબળા તાલીમ ડેટાને કારણે શરૂઆતની AI સિસ્ટમ્સની મર્યાદાઓ
પ્રારંભિક AI સિસ્ટમ્સના ઘણા અધૂરા વચનો માટે નબળા તાલીમ ડેટા, અદ્યતન કમ્પ્યુટિંગ સિસ્ટમ્સના અભાવ સાથે જોડાયેલા, એક કારણ હતું.
ગુણવત્તાયુક્ત તાલીમ ડેટાના અભાવને કારણે, ML સોલ્યુશન્સ દ્રશ્ય પેટર્નને ચોક્કસ રીતે ઓળખી શક્યા નહીં જે ન્યુરલ સંશોધનના વિકાસને અટકાવે છે. ઘણા સંશોધકોએ બોલાતી ભાષા ઓળખના વચનને ઓળખ્યું હોવા છતાં, ભાષણ ડેટાસેટ્સના અભાવને કારણે ભાષણ ઓળખવાના સાધનોનું સંશોધન અથવા વિકાસ સફળ થઈ શક્યું નહીં. ઉચ્ચ-સ્તરીય AI સાધનો વિકસાવવામાં બીજો મોટો અવરોધ કમ્પ્યુટર્સમાં ગણતરી અને સંગ્રહ ક્ષમતાઓનો અભાવ હતો.
ગુણવત્તાયુક્ત તાલીમ ડેટામાં પરિવર્તન
ડેટાસેટની ગુણવત્તા મહત્વપૂર્ણ છે તે જાગૃતિમાં નોંધપાત્ર પરિવર્તન આવ્યું છે. ML સિસ્ટમ માનવ બુદ્ધિ અને નિર્ણય લેવાની ક્ષમતાઓનું સચોટ અનુકરણ કરવા માટે, તેને ઉચ્ચ-વોલ્યુમ, ઉચ્ચ-ગુણવત્તાવાળા તાલીમ ડેટા પર વિકાસ કરવો પડશે.
તમારા ML ડેટાને એક સર્વે તરીકે વિચારો - ડેટા સેમ્પલનું કદ જેટલું મોટું હશે, તેટલી સારી આગાહી થશે. જો સેમ્પલ ડેટામાં બધા ચલો શામેલ ન હોય, તો તે પેટર્નને ઓળખી શકશે નહીં અથવા ખોટા તારણો લાવી શકશે નહીં.
AI ટેકનોલોજીમાં પ્રગતિ અને વધુ સારા તાલીમ ડેટાની જરૂરિયાત

વધુ સારી તાલીમ ડેટા વિશ્વસનીય ML મોડેલ્સની શક્યતા વધારે છે તે સમજણથી વધુ સારા ડેટા સંગ્રહ, ટીકા અને લેબલિંગ પદ્ધતિઓનો વિકાસ થયો. ડેટાની ગુણવત્તા અને સુસંગતતાએ AI મોડેલની ગુણવત્તા પર સીધી અસર કરી.

ડેટા ગુણવત્તા અને ચોકસાઈ પર વધુ ધ્યાન કેન્દ્રિત કરવું
ML મોડેલ સચોટ પરિણામો આપવાનું શરૂ કરવા માટે, તે ગુણવત્તાયુક્ત ડેટાસેટ્સ પર આધારિત છે જે પુનરાવર્તિત ડેટા રિફાઇનિંગ પગલાંઓમાંથી પસાર થાય છે.
ઉદાહરણ તરીકે, કોઈ વ્યક્તિ કૂતરાની ચોક્કસ જાતિનો પરિચય કરાવ્યા પછી થોડા દિવસોમાં જ તેને ઓળખી શકે છે - ચિત્રો, વિડિઓઝ દ્વારા અથવા વ્યક્તિગત રીતે. માણસો પોતાના અનુભવ અને સંબંધિત માહિતીમાંથી આ જ્ઞાન યાદ રાખવા અને જરૂર પડ્યે તેને ખેંચવા માટે ઉપયોગ કરે છે. છતાં, મશીન માટે તે એટલું સરળતાથી કામ કરતું નથી. મશીનને તે ચોક્કસ જાતિ અને અન્ય જાતિઓની સ્પષ્ટ રીતે ટીકા કરેલી અને લેબલવાળી છબીઓ - સેંકડો કે હજારો - થી ખવડાવવી પડે છે જેથી તે જોડાણ બનાવી શકે.
એક AI મોડેલ વાસ્તવિક દુનિયામાં રજૂ કરવામાં આવેલી માહિતી સાથે તાલીમ પામેલી માહિતીને સહસંબંધિત કરીને પરિણામની આગાહી કરે છે . જો તાલીમ ડેટામાં સંબંધિત માહિતી શામેલ ન હોય તો અલ્ગોરિધમ નકામું બની જાય છે.
વૈવિધ્યસભર અને પ્રતિનિધિ તાલીમ ડેટાનું મહત્વ
ડેટાસેટ ચોક્કસ વસ્તી, જાતિ, લિંગ, પસંદગી અને બૌદ્ધિક મંતવ્યો પ્રત્યે પક્ષપાતી હોઈ શકે છે, જે અચોક્કસ મોડેલ તરફ દોરી શકે છે.
વિષય પૂલની પસંદગી, ક્યુરેશન, ટીકા અને લેબલિંગ સહિત સમગ્ર ડેટા સંગ્રહ પ્રક્રિયાનો પ્રવાહ પૂરતા પ્રમાણમાં વૈવિધ્યસભર, સંતુલિત અને વસ્તીનું પ્રતિનિધિત્વ કરે તે સુનિશ્ચિત કરવું મહત્વપૂર્ણ છે.

AI તાલીમ ડેટાનું ભવિષ્ય
AI મોડેલ્સની ભાવિ સફળતા ML અલ્ગોરિધમ્સને તાલીમ આપવા માટે ઉપયોગમાં લેવાતા તાલીમ ડેટાની ગુણવત્તા અને જથ્થા પર આધારિત છે. એ ઓળખવું મહત્વપૂર્ણ છે કે ડેટા ગુણવત્તા અને જથ્થા વચ્ચેનો આ સંબંધ કાર્ય-વિશિષ્ટ છે અને તેનો કોઈ ચોક્કસ જવાબ નથી.
આખરે, તાલીમ ડેટા સેટની પર્યાપ્તતા તે જે હેતુ માટે બનાવવામાં આવી છે તે માટે વિશ્વસનીય રીતે સારી કામગીરી કરવાની ક્ષમતા દ્વારા વ્યાખ્યાયિત થાય છે.
ડેટા સંગ્રહ અને ટીકા તકનીકોમાં પ્રગતિ
ML ફેડ ડેટા પ્રત્યે સંવેદનશીલ હોવાથી, ડેટા સંગ્રહ અને ટીકા નીતિઓને સુવ્યવસ્થિત કરવી મહત્વપૂર્ણ છે. ડેટા સંગ્રહમાં ભૂલો, ક્યુરેશન, ખોટી રજૂઆત, અપૂર્ણ માપન, અચોક્કસ સામગ્રી, ડેટા ડુપ્લિકેશન અને ભૂલભરેલા માપન અપૂરતી ડેટા ગુણવત્તામાં ફાળો આપે છે.
ડેટા માઇનિંગ, વેબ સ્ક્રેપિંગ અને ડેટા એક્સ્ટ્રેક્શન દ્વારા ઓટોમેટેડ ડેટા કલેક્શન ઝડપી ડેટા જનરેશનનો માર્ગ મોકળો કરી રહ્યું છે. વધુમાં, પ્રી-પેકેજ્ડ ડેટાસેટ્સ ઝડપી-ફિક્સ ડેટા કલેક્શન તકનીક તરીકે કાર્ય કરે છે.
ક્રાઉડસોર્સિંગ એ ડેટા સંગ્રહની બીજી એક અજોડ પદ્ધતિ છે. જ્યારે ડેટાની સત્યતાની ખાતરી આપી શકાતી નથી, તે જાહેર છબી એકત્રિત કરવા માટે એક ઉત્તમ સાધન છે. છેલ્લે, વિશિષ્ટ ડેટા સંગ્રહ નિષ્ણાતો ચોક્કસ હેતુઓ માટે સ્ત્રોત કરેલ ડેટા પણ પ્રદાન કરે છે.
તાલીમ ડેટામાં નૈતિક વિચારણાઓ પર વધુ ભાર
ડેટામાં હવે ચહેરાના ફોટા, ફિંગરપ્રિન્ટ્સ, વૉઇસ રેકોર્ડિંગ્સ અને અન્ય મહત્વપૂર્ણ બાયોમેટ્રિક ડેટાનો સમાવેશ થતો હોવાથી, ખર્ચાળ મુકદ્દમા અને પ્રતિષ્ઠાને નુકસાન ટાળવા માટે કાનૂની અને નૈતિક પ્રથાઓનું પાલન સુનિશ્ચિત કરવું ખૂબ જ મહત્વપૂર્ણ બની રહ્યું છે.
ભવિષ્યમાં વધુ સારી ગુણવત્તા અને વૈવિધ્યસભર તાલીમ ડેટાની સંભાવના
ભવિષ્યમાં ઉચ્ચ-ગુણવત્તાવાળા અને વૈવિધ્યસભર તાલીમ ડેટા માટે વિશાળ સંભાવના છે . ડેટા ગુણવત્તા પ્રત્યે જાગૃતિ અને AI સોલ્યુશન્સની ગુણવત્તાની માંગને પૂર્ણ કરતા ડેટા પ્રદાતાઓની ઉપલબ્ધતાને કારણે.
વર્તમાન ડેટા પ્રદાતાઓ નૈતિક અને કાયદેસર રીતે વિવિધ ડેટાસેટ્સનો વિશાળ જથ્થો મેળવવા માટે ક્રાંતિકારી તકનીકોનો ઉપયોગ કરવામાં પારંગત છે. તેમની પાસે વિવિધ ML પ્રોજેક્ટ્સ માટે કસ્ટમાઇઝ્ડ ડેટાને લેબલ કરવા, ટીકા કરવા અને પ્રસ્તુત કરવા માટે ઇન-હાઉસ ટીમો પણ છે.

ઉપસંહાર
ઉચ્ચ-સ્તરીય AI મોડેલ્સ વિકસાવવા માટે ડેટા અને ગુણવત્તાની તીવ્ર સમજ ધરાવતા વિશ્વસનીય વિક્રેતાઓ સાથે ભાગીદારી કરવી મહત્વપૂર્ણ છે . Shaip એ અગ્રણી એનોટેશન કંપની છે જે તમારી AI પ્રોજેક્ટ જરૂરિયાતો અને ધ્યેયોને પૂર્ણ કરતા કસ્ટમાઇઝ્ડ ડેટા સોલ્યુશન્સ પ્રદાન કરવામાં નિષ્ણાત છે. અમારી સાથે ભાગીદારી કરો અને અમે જે ક્ષમતાઓ, પ્રતિબદ્ધતા અને સહયોગ લાવીએ છીએ તેનું અન્વેષણ કરો.