કૃત્રિમ બુદ્ધિ (AI) આરોગ્યસંભાળથી લઈને બેંકિંગ સુધી, દરેક ઉદ્યોગમાં સમસ્યાઓ હલ કરવાની રીત બદલી રહી છે. જોકે, એક મોટો પડકાર બાકી છે: AI સિસ્ટમ્સમાં પક્ષપાત . આવું ત્યારે થાય છે જ્યારે AI ને તાલીમ આપવા માટે વપરાતો ડેટા પૂરતો વૈવિધ્યસભર ન હોય. વિવિધ પ્રકારના ડેટા વિના, AI અન્યાયી નિર્ણયો લઈ શકે છે, ચોક્કસ જૂથોને બાકાત રાખી શકે છે અથવા અચોક્કસ પરિણામો આપી શકે છે.
AI ને વધુ સ્માર્ટ, ન્યાયી અને વધુ અસરકારક બનાવવા માટે, આપણે વિવિધ તાલીમ ડેટા પર ધ્યાન કેન્દ્રિત કરવું જોઈએ . આ બ્લોગમાં, અમે સમજાવીશું કે ડેટા વિવિધતા શા માટે મહત્વપૂર્ણ છે, તે પૂર્વગ્રહને કેવી રીતે દૂર કરવામાં મદદ કરે છે અને વધુ સારી AI સિસ્ટમ્સ બનાવવા માટે તમે કયા પગલાં લઈ શકો છો.
તાલીમ ડેટામાં વિવિધતા શા માટે મહત્વપૂર્ણ છે?
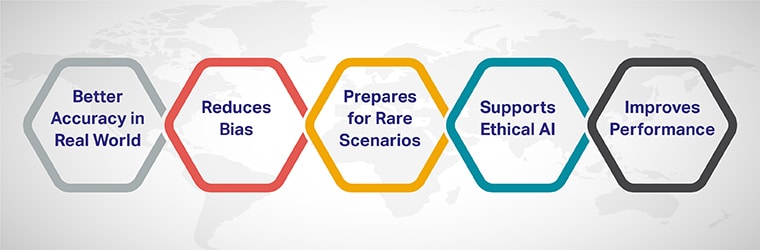
તાલીમ ડેટા એ છે જે AI મોડેલ્સને કેવી રીતે કાર્ય કરવું તે શીખવે છે. જો ડેટા મર્યાદિત અથવા એકતરફી હોય, તો AI ફક્ત તે સંકુચિત દ્રષ્ટિકોણથી જ શીખશે. આનાથી પક્ષપાતી નિર્ણયો અથવા વાસ્તવિક દુનિયાની પરિસ્થિતિઓમાં નબળા પ્રદર્શન જેવી સમસ્યાઓ થઈ શકે છે. વિવિધ ડેટા શા માટે આટલો મહત્વપૂર્ણ છે તે અહીં છે:
1. વાસ્તવિક દુનિયામાં વધુ સારી ચોકસાઈ
વિવિધ ડેટા પર તાલીમ પામેલા AI મોડેલો વિવિધ પરિસ્થિતિઓને વધુ સારી રીતે સંભાળી શકે છે. ઉદાહરણ તરીકે, બધી ઉંમર, ઉચ્ચારો અને લિંગના અવાજો પર તાલીમ પામેલા વૉઇસ સહાયક થોડા અવાજો પર તાલીમ પામેલા વ્યક્તિની તુલનામાં વધુ લોકો માટે કામ કરશે.
2. પૂર્વગ્રહ ઘટાડે છે
વિવિધતા વિના, AI ડેટામાં પૂર્વગ્રહોને પકડી શકે છે અને વધારી શકે છે. ઉદાહરણ તરીકે, જો ભરતી અલ્ગોરિધમ ફક્ત પુરુષોના રિઝ્યુમ પર જ તાલીમ આપવામાં આવે છે, તો તે સમાન લાયકાત ધરાવતી મહિલાઓ કરતાં અન્યાયી રીતે તેમની તરફેણ કરી શકે છે. બધા જૂથોના ડેટાનો સમાવેશ કરવાથી વધુ સારા પરિણામો મળે છે.
૩. દુર્લભ દૃશ્યો માટે તૈયારી કરે છે
વિવિધ ડેટાસેટ્સમાં એવા દુર્લભ કે અનોખા કિસ્સાઓનો સમાવેશ થાય છે જેનો AI સામનો કરી શકે છે. ઉદાહરણ તરીકે, સ્વ-ડ્રાઇવિંગ કારોને તમામ પ્રકારની રસ્તાની સ્થિતિઓ પર તાલીમ આપવાની જરૂર છે, જેમાં પાણી ભરાયેલા શેરીઓ અથવા ખાડાઓ જેવી અસામાન્ય પરિસ્થિતિઓનો સમાવેશ થાય છે.
4. એથિકલ AI ને સપોર્ટ કરે છે
આરોગ્યસંભાળ અને ફોજદારી ન્યાય જેવા ક્ષેત્રોમાં AI નો ઉપયોગ થાય છે, જ્યાં ન્યાયીતા અને નૈતિકતા મહત્વપૂર્ણ છે. વિવિધ તાલીમ ડેટા ખાતરી કરે છે કે AI એવા નિર્ણયો લે છે જે દરેક માટે ન્યાયી હોય, પછી ભલે તેમની પૃષ્ઠભૂમિ ગમે તે હોય.
5. પ્રદર્શન સુધારે છે
જ્યારે AI વિવિધ ડેટામાંથી શીખે છે, ત્યારે તે પેટર્નને ઓળખવામાં અને સચોટ આગાહી કરવામાં વધુ સારી બને છે. આનાથી વધુ સ્માર્ટ, વધુ વિશ્વસનીય સિસ્ટમો બને છે.
તાલીમ ડેટા સાથે વર્તમાન સમસ્યા
હાલમાં, ઘણી AI સિસ્ટમો નિષ્ફળ જાય છે કારણ કે તેમનો તાલીમ ડેટા પૂરતો વૈવિધ્યસભર નથી. ઉદાહરણોમાં ચહેરાની ઓળખ સિસ્ટમો શામેલ છે જે ઘાટા ત્વચાના રંગને ઓળખતી નથી અથવા ચેટબોટ્સ જે અપમાનજનક જવાબો આપે છે. આ નિષ્ફળતાઓ દર્શાવે છે કે આપણે AI તાલીમ પ્રક્રિયા દરમિયાન વધુ વૈવિધ્યસભર ડેટા શામેલ કરવા પર કેમ ધ્યાન કેન્દ્રિત કરવાની જરૂર છે.
તાલીમ ડેટાને વધુ વૈવિધ્યસભર કેવી રીતે બનાવવો
વિવિધ તાલીમ ડેટા બનાવવા માટે પ્રયત્નોની જરૂર પડે છે, પરંતુ યોગ્ય વ્યૂહરચનાથી તે શક્ય છે. તમારો ડેટા સમાવિષ્ટ અને સંતુલિત છે તેની ખાતરી તમે અહીં કરી શકો છો:
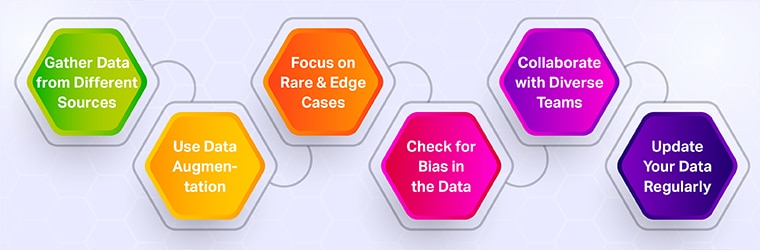
1. વિવિધ સ્ત્રોતોમાંથી ડેટા એકત્રિત કરો
ફક્ત એક જ ડેટા સ્ત્રોત પર આધાર રાખશો નહીં. વિવિધ પ્રદેશો, વય જૂથો, લિંગ અને વંશીયતાઓમાંથી માહિતી એકત્રિત કરો. ઉદાહરણ તરીકે, જો તમે ભાષા મોડેલ બનાવી રહ્યા છો, તો વિવિધ સંસ્કૃતિઓ અને ભાષાઓમાંથી ટેક્સ્ટ શામેલ કરો.
2. ડેટા ઓગમેન્ટેશનનો ઉપયોગ કરો
ડેટા ઓગ્મેન્ટેશન એ હાલના ડેટામાંથી નવો ડેટા બનાવવાની એક પદ્ધતિ છે. ઉદાહરણ તરીકે, તમે વધારાનો ડેટા એકત્રિત કર્યા વિના વધુ વિવિધતા બનાવવા માટે છબીઓને ફ્લિપ, ફેરવી અથવા ગોઠવી શકો છો.
૩. રેર અને એજ કેસો પર ધ્યાન કેન્દ્રિત કરો
તમારા તાલીમ ડેટામાં દુર્લભ પરિસ્થિતિઓના ઉદાહરણોનો સમાવેશ કરો. ઉદાહરણ તરીકે, જો તમે આરોગ્યસંભાળ AI ને તાલીમ આપી રહ્યા છો, તો મોડેલને વધુ વ્યાપક બનાવવા માટે દુર્લભ પરિસ્થિતિઓ ધરાવતા દર્દીઓનો ડેટા શામેલ કરો.
4. ડેટામાં પૂર્વગ્રહ તપાસો
ડેટાસેટનો ઉપયોગ કરતા પહેલા, તેની સમીક્ષા કરો જેથી ખાતરી કરી શકાય કે તે કોઈપણ જૂથની તરફેણ કરતું નથી અથવા બાકાત રાખતું નથી. ઉદાહરણ તરીકે, જો તમે ચહેરાની ઓળખ સોફ્ટવેરને તાલીમ આપી રહ્યા છો, તો ખાતરી કરો કે ડેટાસેટમાં બધા ત્વચા ટોન અને જાતિના ચહેરાઓ શામેલ છે.
5. વિવિધ ટીમો સાથે સહયોગ કરો
તમારા ડેટામાં રહેલા અંતરને ઓળખવામાં મદદ કરવા માટે વિવિધ પૃષ્ઠભૂમિના લોકો સાથે કામ કરો. એક વૈવિધ્યસભર ટીમ અનન્ય દ્રષ્ટિકોણ લાવી શકે છે અને AI વિકાસમાં ન્યાયીતા સુનિશ્ચિત કરી શકે છે.
6. તમારો ડેટા નિયમિતપણે અપડેટ કરો
સમય જતાં દુનિયા બદલાય છે, અને તમારો ડેટા પણ બદલાતો રહેવો જોઈએ. નવા વલણો, ટેકનોલોજીઓ અને સામાજિક ફેરફારોને પ્રતિબિંબિત કરવા માટે તમારા તાલીમ ડેટાને નિયમિતપણે અપડેટ કરો.
[ આ પણ વાંચો: મશીન લર્નિંગમાં તાલીમ ડેટા શું છે ]
ડેટા વિવિધતા સુનિશ્ચિત કરવામાં પડકારો
જ્યારે વિવિધ તાલીમ ડેટા આવશ્યક છે, તે પ્રાપ્ત કરવું હંમેશા સરળ નથી. અહીં કેટલાક સામાન્ય પડકારો છે:
- ઉચ્ચ ખર્ચ: વિવિધ ડેટા એકત્રિત કરવા અને લેબલ કરવા એ ખર્ચાળ અને સમય માંગી લે તેવું હોઈ શકે છે.
- કાનૂની પ્રતિબંધો: યુરોપમાં GDPR જેવા ડેટા કેવી રીતે એકત્રિત અને ઉપયોગ કરી શકાય તે અંગે વિવિધ દેશોમાં કાયદા છે.
- ડેટા ગેપ્સ: કેટલાક કિસ્સાઓમાં, ઓછા પ્રતિનિધિત્વ ધરાવતા જૂથો અથવા દુર્લભ પરિસ્થિતિઓ માટે ડેટા શોધવા મુશ્કેલ હોય છે.
આ પડકારોને દૂર કરવા માટે, તમારે એક વિચારશીલ યોજના અને નિષ્ણાતો સાથે સહયોગની જરૂર પડશે.
નૈતિક અને સમાવેશી AI નું નિર્માણ
તેના મૂળમાં, AI એ દરેકને મદદ કરવી જોઈએ, ફક્ત થોડાક જ નહીં. વિવિધ તાલીમ ડેટા પર ધ્યાન કેન્દ્રિત કરીને, આપણે એવી સિસ્ટમો બનાવી શકીએ છીએ જે વધુ સ્માર્ટ, ન્યાયી અને વધુ સમાવિષ્ટ હોય. આ ફક્ત એક તકનીકી ધ્યેય નથી. AI સમગ્ર સમાજને લાભ આપે તે સુનિશ્ચિત કરવાની જવાબદારી છે.
શેપ કેવી રીતે મદદ કરી શકે છે
Shaip ખાતે, અમે તમારી ચોક્કસ AI જરૂરિયાતોને અનુરૂપ ઉચ્ચ-ગુણવત્તાવાળા, વૈવિધ્યસભર ડેટાસેટ્સ પ્રદાન કરવામાં નિષ્ણાત છીએ. તમે હેલ્થકેર એપ્લિકેશન, ચેટબોટ અથવા ચહેરાની ઓળખ સિસ્ટમ બનાવી રહ્યા હોવ, અમે તમને સમાવિષ્ટ અને વિશ્વસનીય AI ઉકેલો બનાવવામાં મદદ કરી શકીએ છીએ.
ચાલો સાથે મળીને વધુ સ્માર્ટ AI બનાવીએ!
તમારી તાલીમ ડેટા જરૂરિયાતોની ચર્ચા કરવા માટે આજે જ અમારો સંપર્ક કરો. સાથે મળીને, આપણે AI ને વધુ ન્યાયી, સ્માર્ટ અને વધુ અસરકારક બનાવી શકીએ છીએ.