
પરિચય
કૃત્રિમ બુદ્ધિ (AI) હવે રોજિંદા કાર્યનો એક ભાગ છે - ચેટબોટ્સ, કોપાયલોટ્સ અને મલ્ટિમોડલ ટૂલ્સને પાવર આપે છે જે ટેક્સ્ટ, છબીઓ અને ઑડિઓને હેન્ડલ કરે છે. અપનાવવાની પ્રક્રિયા ઝડપી બની રહી છે: મેકકિન્સે અહેવાલ આપે છે કે 88% સંસ્થાઓ ઓછામાં ઓછા એક વ્યવસાયિક કાર્યમાં AI નો ઉપયોગ કરે છે . બજારનો વિકાસ પણ વધી રહ્યો છે, એક અંદાજ મુજબ 2025 માં AI નું મૂલ્યાંકન ~$390.9 બિલિયન અને 2033 સુધીમાં ~ $3.5 બિલિયન થવાનો અંદાજ છે.
દરેક મજબૂત AI સિસ્ટમ પાછળ એક જ પાયો હોય છે: ઉચ્ચ-ગુણવત્તાવાળા ડેટા . આ માર્ગદર્શિકા સમજાવે છે કે કેવી રીતે યોગ્ય ડેટા એકત્રિત કરવો, ગુણવત્તા અને પાલન જાળવી રાખવું, અને તમારા AI પ્રોજેક્ટ્સ માટે શ્રેષ્ઠ અભિગમ (ઇન-હાઉસ, આઉટસોર્સ્ડ અથવા હાઇબ્રિડ) કેવી રીતે પસંદ કરવો.
AI ડેટા કલેક્શન શું છે?
AI ડેટા કલેક્શન એ ડેટાસેટ્સ બનાવવાની પ્રક્રિયા છે જે મોડેલ તાલીમ અને મૂલ્યાંકન માટે તૈયાર હોય છે - યોગ્ય સિગ્નલો મેળવીને, તેમને સાફ કરીને અને માળખાગત કરીને, મેટાડેટા ઉમેરીને અને જ્યાં જરૂર હોય ત્યાં લેબલિંગ કરીને. તે ફક્ત "ડેટા મેળવવાનું" નથી. તે ખાતરી કરે છે કે ડેટા સુસંગત, વિશ્વસનીય, વાસ્તવિક દુનિયાના ઉપયોગ માટે પૂરતો વૈવિધ્યસભર છે, અને પછીથી ઓડિટ કરવા માટે પૂરતો દસ્તાવેજીકૃત છે.
AI પ્રોજેક્ટ્સ માટે સૌથી સામાન્ય ડેટા ફોર્મેટ
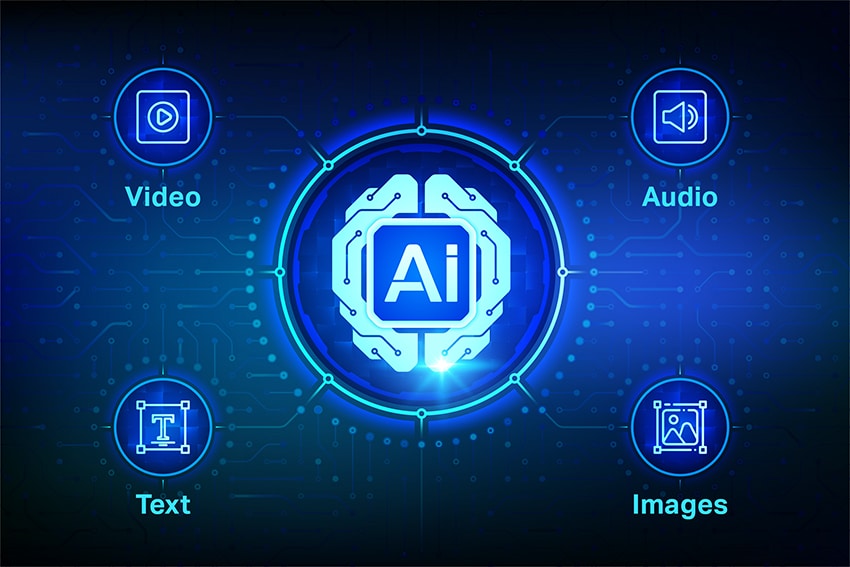
તમે જે સિસ્ટમ બનાવી રહ્યા છો તેના આધારે, AI ડેટાસેટ્સ સામાન્ય રીતે ચાર મુખ્ય શ્રેણીઓમાં આવે છે:
- ટેક્સ્ટ ડેટા: ટેક્સ્ટ એ તાલીમ ડેટાના સૌથી વધુ ઉપયોગમાં લેવાતા સ્વરૂપોમાંનું એક છે. તે હોઈ શકે છે સંરચિત (કોષ્ટકો, ડેટાબેઝ, CRM રેકોર્ડ્સ, ફોર્મ્સ) અથવા અનસ્ટ્રક્ચર્ડ (ઈમેઈલ, ચેટ લોગ, સર્વે, દસ્તાવેજો, સોશિયલ મીડિયા ટિપ્પણીઓ). LLM અને ચેટબોટ્સ માટે, ટેક્સ્ટ ડેટામાં ઘણીવાર જ્ઞાન-આધારિત લેખો, સપોર્ટ ટિકિટો અને પ્રશ્ન-જવાબ જોડીઓનો સમાવેશ થાય છે.
- ઓડિયો ડેટા: ઑડિઓ ડેટા વૉઇસ સહાયકો, કૉલ એનાલિટિક્સ અને વૉઇસ-આધારિત ચેટબોટ્સ જેવી સ્પીચ સિસ્ટમ્સને તાલીમ આપવામાં અને સુધારવામાં મદદ કરે છે. આ ડેટાસેટ્સ વાસ્તવિક દુનિયાની વિવિધતા જેમ કે ઉચ્ચારો, ઉચ્ચારણ, પૃષ્ઠભૂમિ અવાજ અને લોકો એક જ પ્રશ્ન પૂછે છે તે વિવિધ રીતોને કેપ્ચર કરે છે. સામાન્ય ઉદાહરણોમાં કૉલ સેન્ટર રેકોર્ડિંગ્સ, વૉઇસ કમાન્ડ્સ અને બહુભાષી સ્પીચ નમૂનાઓનો સમાવેશ થાય છે.
- છબી ડેટા: છબી ડેટાસેટ્સ કમ્પ્યુટર વિઝનને પાવર આપે છે જેમ કે ઑબ્જેક્ટ ડિટેક્શન, મેડિકલ ઇમેજિંગ વિશ્લેષણ, રિટેલ પ્રોડક્ટ ઓળખ અને ID ચકાસણી. છબીઓને ઘણીવાર ટૅગ્સ, બાઉન્ડિંગ બોક્સ અથવા સેગ્મેન્ટેશન માસ્ક જેવા લેબલ્સની જરૂર પડે છે જેથી મોડેલો તેઓ શું જોઈ રહ્યા છે તે જાણી શકે.
- વિડિઓ ડેટા: વિડિઓ એ મૂળભૂત રીતે સમય જતાં છબીઓનો ક્રમ છે, જે તેને ગતિવિધિ અને સંદર્ભની ઊંડી સમજ માટે ઉપયોગી બનાવે છે. વિડિઓ ડેટાસેટ્સ સ્વાયત્ત ડ્રાઇવિંગ, સર્વેલન્સ એનાલિટિક્સ, રમતગમત વિશ્લેષણ અને ઔદ્યોગિક સલામતી દેખરેખ જેવી એપ્લિકેશનોને સપોર્ટ કરે છે - ઘણીવાર ફ્રેમ-બાય-ફ્રેમ લેબલિંગ અથવા ઇવેન્ટ ટેગિંગની જરૂર પડે છે.
2026 માં, AI ડેટા સંગ્રહ અલગ દેખાય છે કારણ કે ઘણી બધી સિસ્ટમો LLM ચેટબોટ્સ, RAG (પુનઃપ્રાપ્તિ-સંવર્ધિત જનરેશન) અને મલ્ટિમોડલ મોડેલ્સ દ્વારા સંચાલિત છે . તેનો અર્થ એ કે ટીમો સમાંતર ત્રણ પ્રકારના ડેટા એકત્રિત કરે છે: શીખવાનો ડેટા (વર્તણૂક શીખવવા માટે), ગ્રાઉન્ડિંગ ડેટા (સચોટ જવાબો માટે RAG-તૈયાર દસ્તાવેજો), અને મૂલ્યાંકન ડેટા (પુનઃપ્રાપ્તિ ચોકસાઈ, ભ્રામકતા અને નીતિ સંરેખણ માપવા માટે).
AI ડેટા કલેક્શન પદ્ધતિઓના પ્રકારો
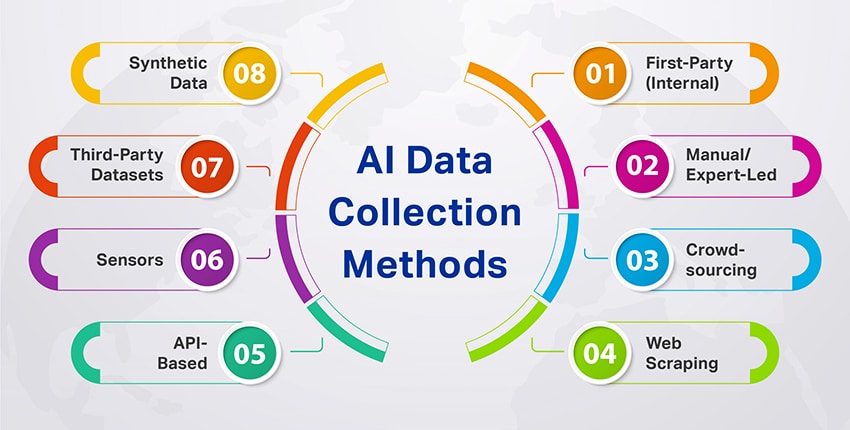
૧. ફર્સ્ટ-પાર્ટી (આંતરિક) ડેટા કલેક્શન
તમારા પોતાના ઉત્પાદન, વપરાશકર્તાઓ અને કામગીરીમાંથી એકત્રિત કરવામાં આવેલ ડેટા - સામાન્ય રીતે સૌથી મૂલ્યવાન હોય છે કારણ કે તે વાસ્તવિક વર્તનને પ્રતિબિંબિત કરે છે.
ઉદાહરણ: સપોર્ટ ટિકિટ, શોધ લોગ અને ચેટબોટ વાતચીત (સંમતિથી) નિકાસ કરવી, પછી LLM સપોર્ટ આસિસ્ટન્ટને સુધારવા માટે તેમને મુદ્દાના પ્રકાર દ્વારા ગોઠવવા.
2. મેન્યુઅલ/નિષ્ણાતના નેતૃત્વ હેઠળનું સંગ્રહ
જ્યારે ઊંડા સંદર્ભ, ક્ષેત્ર જ્ઞાન અથવા ઉચ્ચ ચોકસાઈની જરૂર હોય ત્યારે માનવીઓ જાણી જોઈને ડેટા એકત્રિત કરે છે અથવા બનાવે છે.
ઉદાહરણ: હેલ્થકેર NLP મોડેલને તાલીમ આપવા માટે તબીબી અહેવાલોની સમીક્ષા કરતા અને મુખ્ય તારણોને લેબલ કરતા ક્લિનિશિયન.
૪. ક્રાઉડસોર્સિંગ (વિતરણ કરાયેલ માનવ કાર્યબળ)
ઝડપથી ડેટા એકત્રિત કરવા અથવા લેબલ કરવા માટે કામદારોના મોટા સમૂહનો ઉપયોગ કરવો. સ્પષ્ટ માર્ગદર્શિકા, બહુવિધ સમીક્ષકો અને પરીક્ષણ પ્રશ્નોનો ઉપયોગ કરીને ગુણવત્તા જાળવવામાં આવે છે.
ઉદાહરણ: ભીડ કામદારો વાણી ઓળખ માટે હજારો ટૂંકી ઓડિયો ક્લિપ્સનું ટ્રાન્સક્રિપ્શન કરે છે, જેમાં ચોકસાઈ ચકાસવા માટે "ગોલ્ડ" ટેસ્ટ ક્લિપ્સનો ઉપયોગ થાય છે.
૫. વેબ ડેટા કલેક્શન (સ્ક્રેપિંગ)
જાહેર વેબસાઇટ્સમાંથી મોટા પાયે માહિતી આપમેળે કાઢવામાં આવે છે (ફક્ત નિયમો અને કાયદા દ્વારા પરવાનગી હોય ત્યારે). આ ડેટાને ઘણીવાર ભારે સફાઈની જરૂર પડે છે.
ઉદાહરણ: ઉત્પાદક પૃષ્ઠોમાંથી જાહેર ઉત્પાદન સ્પષ્ટીકરણો એકત્રિત કરવા અને ઉત્પાદન-મેચિંગ મોડેલ માટે અવ્યવસ્થિત વેબ સામગ્રીને સ્ટ્રક્ચર્ડ ફીલ્ડમાં રૂપાંતરિત કરવી.
5. API-આધારિત ડેટા સંગ્રહ
સત્તાવાર API દ્વારા ડેટા ખેંચવો, જે સામાન્ય રીતે સ્ક્રેપિંગ કરતાં વધુ સુસંગત, વિશ્વસનીય અને સંરચિત ડેટા પ્રદાન કરે છે.
ઉદાહરણ: આગાહી અથવા વિસંગતતા શોધવા માટે કિંમત/સમય-શ્રેણી ડેટા એકત્રિત કરવા માટે નાણાકીય બજાર API નો ઉપયોગ કરવો.
6. સેન્સર અને IoT ડેટા કલેક્શન
ઉપકરણો અને સેન્સર (તાપમાન, વાઇબ્રેશન, GPS, કેમેરા, વગેરે) માંથી સતત સ્ટ્રીમ્સ કેપ્ચર કરવા, ઘણીવાર રીઅલ-ટાઇમ નિર્ણયો માટે.
ઉદાહરણ: ફેક્ટરી મશીનોમાંથી કંપન અને તાપમાન સંકેતો એકત્રિત કરવા, પછી આગાહી જાળવણી માટે જાળવણી લોગનો લેબલ તરીકે ઉપયોગ કરવો.
7. તૃતીય-પક્ષ/લાઇસન્સ પ્રાપ્ત ડેટાસેટ્સ
વિકાસને ઝડપી બનાવવા અથવા કવરેજ ગેપ ભરવા માટે વિક્રેતાઓ અથવા બજારો પાસેથી તૈયાર ડેટાસેટ્સ ખરીદવા અથવા લાઇસન્સ આપવું.
ઉદાહરણ: વૉઇસ પ્રોડક્ટ લોન્ચ કરવા માટે બહુભાષી સ્પીચ ડેટાસેટનું લાઇસન્સ આપવું, પછી તમારા વપરાશકર્તાઓ માટે પ્રદર્શન સુધારવા માટે ફર્સ્ટ-પાર્ટી રેકોર્ડિંગ્સ ઉમેરવા.
8. સિન્થેટિક ડેટા જનરેશન
ગોપનીયતાના અવરોધો, દુર્લભ ઘટનાઓ અથવા વર્ગ અસંતુલનને નિયંત્રિત કરવા માટે કૃત્રિમ ડેટા બનાવવો. કૃત્રિમ ડેટાને વાસ્તવિક દુનિયાના દાખલાઓ સામે માન્ય કરવો જોઈએ.
ઉદાહરણ: જ્યારે વાસ્તવિક છેતરપિંડીના ઉદાહરણો મર્યાદિત હોય ત્યારે શોધ સુધારવા માટે દુર્લભ છેતરપિંડી વ્યવહાર પેટર્ન જનરેટ કરવી.

ડેટા સંગ્રહ પ્રક્રિયા: જરૂરિયાતોથી મોડેલ-તૈયાર ડેટાસેટ્સ સુધી
સ્કેલેબલ AI ડેટા કલેક્શન પ્રક્રિયા પુનરાવર્તિત, માપી શકાય તેવી અને સુસંગત છે - કાચી ફાઇલોનો એક વખતનો ડમ્પ નહીં. મોટાભાગની AI/ML પહેલ માટે, અંતિમ ધ્યેય સ્પષ્ટ છે: એક મશીન-તૈયાર ડેટાસેટ જેનો ટીમો સમય જતાં વિશ્વસનીય રીતે ફરીથી ઉપયોગ, ઑડિટ અને સુધારી શકે છે.
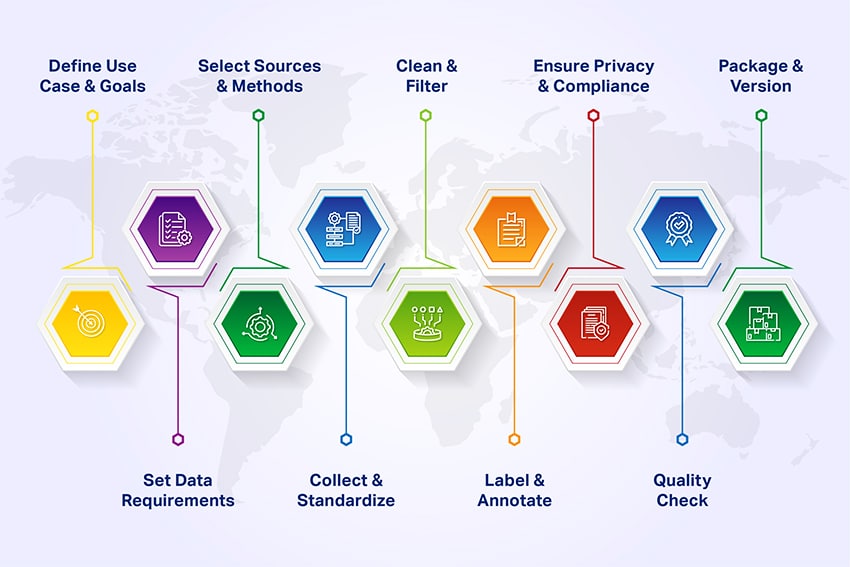
1. ઉપયોગ કેસ અને સફળતા મેટ્રિક્સ વ્યાખ્યાયિત કરો
વ્યવસાયની સમસ્યાથી શરૂઆત કરો, ડેટાથી નહીં.
- આ મોડેલ કઈ સમસ્યાનું નિરાકરણ લાવી રહ્યું છે?
- ઉત્પાદનમાં સફળતા કેવી રીતે માપવામાં આવશે?
ઉદાહરણો:
- "6 મહિનામાં સપોર્ટ એસ્કેલેશનમાં 15% ઘટાડો."
- "ટોચના 50 સ્વ-સેવા પ્રશ્નો માટે પુનઃપ્રાપ્તિની ચોકસાઈમાં સુધારો."
- "ઉત્પાદનમાં ખામી શોધ રિકોલ 10% વધારો."
આ લક્ષ્યો પાછળથી ડેટા વોલ્યુમ, કવરેજ અને ગુણવત્તા થ્રેશોલ્ડને ચલાવે છે.
2. ડેટા આવશ્યકતાઓનો ઉલ્લેખ કરો
ઉપયોગના કેસને કોંક્રિટ ડેટા સ્પેક્સમાં અનુવાદિત કરો.
- ડેટા પ્રકારો: ટેક્સ્ટ, ઑડિઓ, છબી, વિડિઓ, ટેબ્યુલર, અથવા મિશ્રણ
- વોલ્યુમ રેન્જ: પ્રારંભિક પાયલોટ વિરુદ્ધ સંપૂર્ણ રોલઆઉટ (દા.ત., 10K → 100K+ નમૂનાઓ)
- ભાષાઓ અને સ્થાનો: બહુભાષી, ઉચ્ચારો, બોલીઓ, પ્રાદેશિક સ્વરૂપો
- વાતાવરણ: શાંત વિરુદ્ધ ઘોંઘાટ, ક્લિનિકલ વિરુદ્ધ ગ્રાહક, ફેક્ટરી વિરુદ્ધ ઓફિસ
- એજ કેસ: દુર્લભ પરંતુ ઉચ્ચ-પ્રભાવવાળા દૃશ્યો જે તમે ચૂકી ન શકો
આ "ડેટા આવશ્યકતા સ્પેક" આંતરિક ટીમો અને બાહ્ય ડેટા વિક્રેતાઓ બંને માટે સત્યનો એકમાત્ર સ્ત્રોત બની જાય છે.
૩. સંગ્રહ પદ્ધતિઓ અને સ્ત્રોતો પસંદ કરો
આ તબક્કે, તમે નક્કી કરો છો કે તમારો ડેટા ક્યાંથી આવશે. સામાન્ય રીતે, ટીમો ત્રણ મુખ્ય સ્ત્રોતોને જોડે છે:
- મફત/જાહેર ડેટાસેટ્સ: પ્રયોગો અને બેન્ચમાર્કિંગ માટે ઉપયોગી છે, પરંતુ ઘણીવાર તમારા ડોમેન, લાઇસન્સિંગ જરૂરિયાતો અથવા સમયરેખા સાથે ખોટી રીતે ગોઠવાય છે.
- આંતરિક ડેટા: CRM, સપોર્ટ ટિકિટ, લોગ, મેડિકલ રેકોર્ડ, પ્રોડક્ટ વપરાશ ડેટા—અત્યંત સુસંગત, પરંતુ કાચો, છૂટોછવાયો અથવા સંવેદનશીલ હોઈ શકે છે.
- ચૂકવેલ/લાઇસન્સ પ્રાપ્ત ડેટા વિક્રેતાઓ: જ્યારે તમને ડોમેન-વિશિષ્ટ, ઉચ્ચ-ગુણવત્તાવાળા, ટિપ્પણીવાળા અને સુસંગત ડેટાસેટ્સની જરૂર હોય ત્યારે શ્રેષ્ઠ.
સૌથી સફળ પ્રોજેક્ટ્સમાં આનો સમાવેશ થાય છે:
- પ્રોટોટાઇપિંગ માટે જાહેર ડેટાનો ઉપયોગ કરો.
- ડોમેન સુસંગતતા માટે આંતરિક ડેટાનો ઉપયોગ કરો.
- જ્યારે તમને સ્કેલ, વિવિધતા, પાલન અને નિષ્ણાત ટીકાની જરૂર હોય ત્યારે આંતરિક ટીમોને ઓવરલોડ કર્યા વિના શેપ જેવા વિક્રેતાઓનો ઉપયોગ કરો.
કૃત્રિમ ડેટા કેટલાક દૃશ્યોમાં વાસ્તવિક દુનિયાના ડેટાને પણ પૂરક બનાવી શકે છે (દા.ત., દુર્લભ ઘટનાઓ, નિયંત્રિત ભિન્નતા), પરંતુ તે વાસ્તવિક ડેટાને સંપૂર્ણપણે બદલી ન શકે.
4. ડેટા એકત્રિત કરો અને પ્રમાણિત કરો
જેમ જેમ ડેટા આવવાનું શરૂ થાય છે, માનકીકરણ પછીથી અરાજકતાને અટકાવે છે.
- સુસંગત ફાઇલ ફોર્મેટ લાગુ કરો (દા.ત., ઑડિઓ માટે WAV, મેટાડેટા માટે JSON, ઇમેજિંગ માટે DICOM).
- સમૃદ્ધ મેટાડેટા કેપ્ચર કરો: તારીખ/સમય, લોકેલ, ઉપકરણ, ચેનલ, પર્યાવરણ, સંમતિ સ્થિતિ અને સ્ત્રોત.
- સ્કીમા અને ઓન્ટોલોજી પર સંરેખિત કરો: લેબલ્સ, વર્ગો, ઉદ્દેશ્યો અને એન્ટિટીઓને કેવી રીતે નામ આપવામાં આવે છે અને સંરચિત કરવામાં આવે છે.
આ તે જગ્યા છે જ્યાં એક સારો વિક્રેતા તમારી ટીમોને કાચી, વિજાતીય ફાઇલો મોકલવાને બદલે, તમારી પસંદગીની સ્કીમામાં ડેટા પહોંચાડશે.
5. સાફ કરો અને ફિલ્ટર કરો
કાચો ડેટા અવ્યવસ્થિત છે. સફાઈ ખાતરી કરે છે કે ફક્ત ઉપયોગી, ઉપયોગી અને કાયદેસર ડેટા જ આગળ વધે છે.
લાક્ષણિક ક્રિયાઓમાં શામેલ છે:
- ડુપ્લિકેટ્સ અને નજીકના ડુપ્લિકેટ્સ દૂર કરી રહ્યા છીએ
- દૂષિત, હલકી ગુણવત્તાવાળા અથવા અપૂર્ણ નમૂનાઓને બાકાત રાખવા
- કાર્યક્ષેત્રની બહારની સામગ્રીને ફિલ્ટર કરવી (ખોટી ભાષા, ખોટો ડોમેન, ખોટો હેતુ)
- ફોર્મેટનું સામાન્યકરણ (ટેક્સ્ટ એન્કોડિંગ, સેમ્પલિંગ રેટ, રિઝોલ્યુશન)
સફાઈ ઘણીવાર એવી જગ્યા છે જ્યાં આંતરિક ટીમો પ્રયત્નોને ઓછો અંદાજ આપે છે. આ પગલાને વિશિષ્ટ પ્રદાતાને આઉટસોર્સ કરવાથી સમય-થી-માર્કેટમાં નોંધપાત્ર ઘટાડો થઈ શકે છે.
૬. લેબલ અને ટીકા (જ્યારે જરૂરી હોય ત્યારે)
દેખરેખ હેઠળની અને માનવ-ઇન-ધ-લૂપ સિસ્ટમોને સુસંગત, ઉચ્ચ-ગુણવત્તાવાળા લેબલ્સની જરૂર હોય છે.
ઉપયોગના કેસના આધારે, આમાં શામેલ હોઈ શકે છે:
- ચેટબોટ્સ અને વર્ચ્યુઅલ સહાયકો માટે ઉદ્દેશ્યો અને એન્ટિટીઝ
- સ્પીચ અને કોલ એનાલિટિક્સ માટે ટ્રાન્સક્રિપ્ટ અને સ્પીકર લેબલ્સ
- કમ્પ્યુટર વિઝન માટે બાઉન્ડિંગ બોક્સ, બહુકોણ, અથવા સેગ્મેન્ટેશન માસ્ક
- શોધ અને RAG સિસ્ટમ્સ માટે સુસંગતતાના નિર્ણયો અને રેન્કિંગ લેબલ્સ
- આરોગ્યસંભાળ NLP માટે ICD કોડ, દવાઓ અને ક્લિનિકલ ખ્યાલો
સફળતાના મુખ્ય પરિબળો:
- સ્પષ્ટ, વિગતવાર ટીકા માર્ગદર્શિકા
- ટીકાકારો માટે તાલીમ અને વિષય નિષ્ણાતો સુધી પહોંચ
- અસ્પષ્ટ કેસો માટે સર્વસંમતિ નિયમો
- સુસંગતતાને ટ્રેક કરવા માટે ઇન્ટર-એનોટેટર કરારનું માપન
હેલ્થકેર અથવા ફાઇનાન્સ જેવા વિશિષ્ટ ક્ષેત્રો માટે, સામાન્ય ક્રાઉડ એનોટેશન પૂરતું નથી. તમારે SMEs અને ઑડિટેડ વર્કફ્લોની જરૂર છે - બરાબર જ્યાં Shaip જેવા ભાગીદાર મૂલ્ય લાવે છે.
૭. ગોપનીયતા, સુરક્ષા અને પાલન નિયંત્રણો લાગુ કરો
ડેટા સંગ્રહમાં પહેલા દિવસથી જ નિયમનકારી અને નૈતિક સીમાઓનું પાલન કરવું જોઈએ.
લાક્ષણિક નિયંત્રણોમાં શામેલ છે:
- વ્યક્તિગત અને સંવેદનશીલ ડેટાની ઓળખ રદ કરવી/ગુમીકરણ કરવું
- સંમતિ ટ્રેકિંગ અને ડેટા વપરાશ પ્રતિબંધો
- રીટેન્શન અને ડિલીટ કરવાની નીતિઓ
- ભૂમિકા-આધારિત ઍક્સેસ નિયંત્રણો અને ડેટા એન્ક્રિપ્શન
- GDPR, HIPAA, CCPA અને ઉદ્યોગ-વિશિષ્ટ નિયમો જેવા ધોરણોનું પાલન
એક અનુભવી ડેટા પાર્ટનર આ જરૂરિયાતોને સંગ્રહ, ટીકા, ડિલિવરી અને સંગ્રહમાં સમાવિષ્ટ કરશે, તેમને પાછળથી વિચારેલા તરીકે નહીં ગણશે.
8. ગુણવત્તા ખાતરી અને સ્વીકૃતિ પરીક્ષણ
ડેટાસેટને "મોડેલ-રેડી" જાહેર કરવામાં આવે તે પહેલાં, તે સ્ટ્રક્ચર્ડ QAમાંથી પસાર થવું જોઈએ.
સામાન્ય પ્રથાઓ:
- નમૂના લેવા અને ઓડિટ: દરેક બેચમાંથી રેન્ડમ નમૂનાઓની માનવ સમીક્ષા
- ગોલ્ડ સેટ્સ: એક નાનો, નિષ્ણાત-લેબલવાળો સંદર્ભ સેટ જેનો ઉપયોગ ટીકાકાર કામગીરીનું મૂલ્યાંકન કરવા માટે થાય છે.
- ખામી ટ્રેકિંગ: સમસ્યાઓનું વર્ગીકરણ (ખોટું લેબલ, ખૂટતું લેબલ, ફોર્મેટિંગ ભૂલ, પૂર્વગ્રહ, વગેરે)
- સ્વીકૃતિ માપદંડ: ચોકસાઈ, કવરેજ અને સુસંગતતા માટે પૂર્વ-નિર્ધારિત થ્રેશોલ્ડ
જ્યારે ડેટાસેટ આ માપદંડોને પૂર્ણ કરે છે ત્યારે જ તેને તાલીમ, માન્યતા અથવા મૂલ્યાંકન માટે પ્રમોટ કરવું જોઈએ.
9. પુનઃઉપયોગ માટે પેકેજ, દસ્તાવેજ અને સંસ્કરણ
છેલ્લે, ડેટા આજે ઉપયોગી અને કાલે પુનઃઉત્પાદનક્ષમ હોવો જોઈએ.
શ્રેષ્ઠ વ્યવહારો:
- સ્પષ્ટ સ્કીમા, લેબલ વર્ગીકરણ અને મેટાડેટા વ્યાખ્યાઓ સાથેનો પેકેજ ડેટા
- દસ્તાવેજીકરણ શામેલ કરો: ડેટા સ્ત્રોતો, સંગ્રહ પદ્ધતિઓ, જાણીતી મર્યાદાઓ અને હેતુપૂર્વકનો ઉપયોગ.
- વર્ઝન ડેટાસેટ્સ જેથી ટીમો ટ્રેક કરી શકે કે કયા મોડેલ, પ્રયોગ અથવા રિલીઝ માટે કયા વર્ઝનનો ઉપયોગ કરવામાં આવ્યો હતો.
- શેડો ડેટાસેટ્સ અને ડુપ્લિકેટ પ્રયાસ ટાળવા માટે ડેટાસેટ્સને આંતરિક રીતે (અને સુરક્ષિત રીતે) શોધી શકાય તેવા બનાવો.
એઆઈ ડેટા કલેક્શનના વાસ્તવિક-વિશ્વ ઉદાહરણો

ઉદાહરણ ૧: ગ્રાહક સપોર્ટ LLM ચેટબોટ (RAG + મૂલ્યાંકન)
- ઉદ્દેશ: ટિકિટનું પ્રમાણ ઘટાડવું અને સ્વ-સેવા રીઝોલ્યુશનમાં સુધારો કરવો.
- ડેટા: ક્યુરેટ કરેલા સહાય કેન્દ્ર લેખો, ઉત્પાદન દસ્તાવેજીકરણ, અને અનામી ઉકેલાયેલી ટિકિટો.
- વિશેષ: RAG ગુણવત્તા માપવા માટે એક સંરચિત પુનઃપ્રાપ્તિ મૂલ્યાંકન સમૂહ (વપરાશકર્તા પ્રશ્ન → સાચો સ્રોત દસ્તાવેજ).
- અભિગમ: ઉદ્દેશોને લેબલ કરવા, પ્રશ્નોના જવાબો મેપ કરવા અને પુનઃપ્રાપ્તિની સુસંગતતાનું મૂલ્યાંકન કરવા માટે વિક્રેતા-સમર્થિત એનોટેશન સાથે આંતરિક દસ્તાવેજોનું સંયોજન.
- પરિણામ: વધુ ગ્રાઉન્ડેડ જવાબો, ઘટાડો વધારો, અને ગ્રાહક સંતોષમાં માપી શકાય તેવા સુધારા.
ઉદાહરણ 2: વૉઇસ સહાયકો માટે સ્પીચ AI
- ઉદ્દેશ: બજારો, ઉચ્ચારો અને વાતાવરણમાં વાણી ઓળખમાં સુધારો કરો.
- ડેટા: વિવિધ વક્તાઓ, વાતાવરણ (શાંત ઘરો, વ્યસ્ત શેરીઓ, કાર) અને ઉપકરણોમાંથી હજારો કલાકોનું ભાષણ.
- વિશેષ: ઉચ્ચારણ અને ભાષા કવરેજ યોજનાઓ, પ્રમાણિત ટ્રાન્સક્રિપ્શન નિયમો, અને સ્પીકર/લોકેલ મેટાડેટા.
- અભિગમ: વૈશ્વિક સ્તરે સહભાગીઓની ભરતી કરવા, સ્ક્રિપ્ટેડ અને અનસ્ક્રિપ્ટેડ આદેશો રેકોર્ડ કરવા અને સંપૂર્ણપણે ટ્રાન્સક્રિપ્ટેડ, એનોટેટેડ અને ગુણવત્તા-ચકાસાયેલ કોર્પોરા પહોંચાડવા માટે સ્પીચ ડેટા પ્રદાતા સાથે ભાગીદારી.
- પરિણામ: વાસ્તવિક દુનિયાની પરિસ્થિતિઓમાં ઉચ્ચ ઓળખ ચોકસાઈ અને બિન-માનક ઉચ્ચારો ધરાવતા વપરાશકર્તાઓ માટે વધુ સારું પ્રદર્શન.
ઉદાહરણ ૩: હેલ્થકેર NLP (ગોપનીયતા-પ્રથમ)
- ઉદ્દેશ: ક્લિનિકલ નિર્ણય લેવામાં મદદ કરવા માટે અનસ્ટ્રક્ચર્ડ નોંધોમાંથી ક્લિનિકલ ખ્યાલો કાઢો.
- ડેટા: ઓળખ ન કરાયેલ ક્લિનિકલ નોંધો અને અહેવાલો, પરિસ્થિતિઓ, દવાઓ, પ્રક્રિયાઓ અને પ્રયોગશાળા મૂલ્યો માટે SME-સમીક્ષા કરાયેલ લેબલ્સથી સમૃદ્ધ.
- વિશેષ: HIPAA અને હોસ્પિટલ નીતિઓ સાથે સંરેખિત કડક ઍક્સેસ નિયંત્રણ, એન્ક્રિપ્શન અને ઓડિટ લોગ.
- અભિગમ: ઓળખ રદ કરવા, પરિભાષા મેપિંગ અને ડોમેન નિષ્ણાત એનોટેશનને હેન્ડલ કરવા માટે એક વિશિષ્ટ આરોગ્યસંભાળ ડેટા વિક્રેતાનો ઉપયોગ કર્યો, જેનાથી હોસ્પિટલના આઇટી અને ક્લિનિકલ સ્ટાફ પરનો બોજ ઓછો થયો.
- પરિણામ: ઉચ્ચ-ગુણવત્તાવાળા ક્લિનિકલ સિગ્નલ સાથે સુરક્ષિત મોડેલો, PHI ને ખુલ્લા પાડ્યા વિના અથવા પાલન સાથે સમાધાન કર્યા વિના ઉપયોગમાં લેવાય છે.
ઉદાહરણ ૪: ઉત્પાદનમાં કમ્પ્યુટર વિઝન
- ઉદ્દેશ: ઉત્પાદન લાઇનમાં ખામીઓ આપમેળે શોધો.
- ડેટા: વિવિધ શિફ્ટ, લાઇટિંગની સ્થિતિ, કેમેરા એંગલ અને પ્રોડક્ટ વેરિઅન્ટ્સમાં ફેક્ટરીઓની છબીઓ અને વિડિઓઝ.
- વિશેષ: ખામીના પ્રકારો માટે સ્પષ્ટ ઓન્ટોલોજી અને QA અને મોડેલ મૂલ્યાંકન માટે ગોલ્ડ સેટ.
- અભિગમ: દુર્લભ પરંતુ ગંભીર ફોલ્ટ પ્રકારો સહિત, "સામાન્ય" અને "ખામીયુક્ત" બંને ઉત્પાદનો પર ધ્યાન કેન્દ્રિત કરીને, વિવિધ દ્રશ્ય ડેટા એકત્રિત અને ટિપ્પણી કરેલ.
- પરિણામ: ખામી શોધમાં ઓછા ખોટા હકારાત્મક અને ખોટા નકારાત્મક, વધુ વિશ્વસનીય ઓટોમેશનને સક્ષમ બનાવે છે અને મેન્યુઅલ નિરીક્ષણ પ્રયાસ ઘટાડે છે.
AI ડેટા કલેક્શન વિક્રેતાઓનું મૂલ્યાંકન કેવી રીતે કરવું
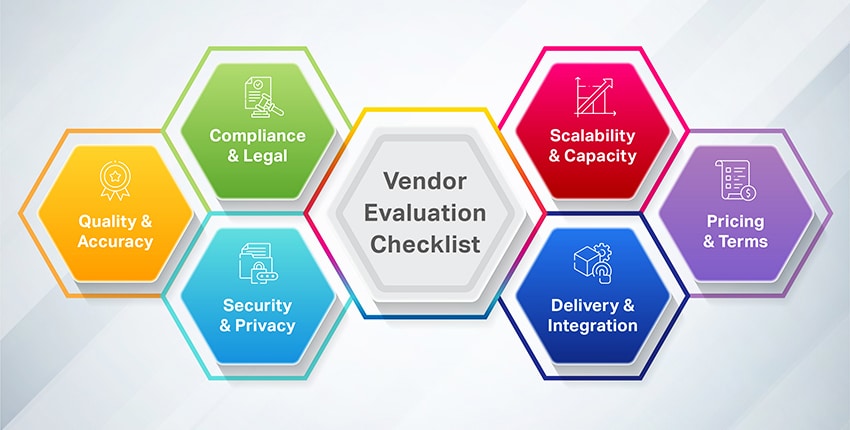
વિક્રેતા મૂલ્યાંકન ચેકલિસ્ટ
વિક્રેતા મૂલ્યાંકન દરમિયાન આ ચેકલિસ્ટનો ઉપયોગ કરો:
ગુણવત્તા અને ચોકસાઈ
- દસ્તાવેજીકૃત ગુણવત્તા ખાતરી પ્રક્રિયા (બહુ-સ્તરીય સમીક્ષા, સ્વચાલિત તપાસ)
- ઇન્ટર-એનોટેટર કરાર મેટ્રિક્સ ઉપલબ્ધ છે
- ભૂલ સુધારણા અને પ્રતિસાદ લૂપ પ્રક્રિયાઓ
- પ્રતિબદ્ધતા પહેલાં નમૂના ડેટા સમીક્ષા
પાલન અને કાનૂની
- ડેટા મૂળ દસ્તાવેજીકરણ સાફ કરો
- ડેટા વિષયો માટે સંમતિ પદ્ધતિઓ
- GDPR, CCPA, અને સંબંધિત પ્રાદેશિક પાલન
- ડેટા લાઇસન્સિંગ શરતો જે તમારા હેતુપૂર્વકના ઉપયોગને આવરી લે છે
- ડેટા IP સમસ્યાઓ માટે વળતર કલમો
સુરક્ષા અને ગોપનીયતા
- SOC 2 પ્રકાર II પ્રમાણપત્ર (અથવા સમકક્ષ)
- આરામ અને પરિવહનમાં ડેટા એન્ક્રિપ્શન
- ઍક્સેસ નિયંત્રણો અને ઑડિટ લોગિંગ
- ઓળખ રદ કરવા અને PII હેન્ડલિંગ પ્રક્રિયાઓ
- ડેટા રીટેન્શન અને ડિલીટ કરવાની નીતિઓ
માપનીયતા અને ક્ષમતા
- તમારા જરૂરી સ્કેલ પર સાબિત ટ્રેક રેકોર્ડ
- સમય-સંવેદનશીલ પ્રોજેક્ટ્સ માટે ક્ષમતામાં વધારો
- બહુભાષી અને બહુ-પ્રદેશ ક્ષમતાઓ
- તમારા લક્ષ્ય ડોમેનમાં કાર્યબળની ઊંડાઈ
ડિલિવરી અને એકીકરણ
- API ઍક્સેસ અથવા સ્વચાલિત ડિલિવરી વિકલ્પો
- તમારી ML પાઇપલાઇન સાથે સુસંગતતા (ફોર્મેટ, સ્કીમા)
- ઉપાય પ્રક્રિયાઓ સાથે SLA સાફ કરો
- પારદર્શક પ્રોજેક્ટ મેનેજમેન્ટ અને સંદેશાવ્યવહાર
કિંમત અને શરતો
- પારદર્શક કિંમત મોડેલ (પ્રતિ-યુનિટ, પ્રતિ-કલાક, પ્રોજેક્ટ-આધારિત)
- સુધારા, ફોર્મેટમાં ફેરફાર અથવા ઉતાવળમાં ડિલિવરી માટે કોઈ છુપી ફી નથી
- લવચીક કરારની શરતો (પાયલોટ વિકલ્પો, સ્કેલેબલ પ્રતિબદ્ધતાઓ)
- ડિલિવરેબલ્સની સ્પષ્ટ માલિકી
વેન્ડર સ્કોરિંગ રૂબ્રિક
વિક્રેતાઓની વ્યવસ્થિત સરખામણી કરવા માટે આ નમૂનાનો ઉપયોગ કરો:
