એવી દુનિયામાં જ્યાં વ્યાપારી સાહસો કૃત્રિમ બુદ્ધિમત્તા ઉકેલો લાગુ કરીને તેમની વ્યવસાયિક પદ્ધતિઓમાં પરિવર્તન લાવવા માટે એકબીજા સામે ટક્કર આપી રહ્યા છે, ડેટા લેબલિંગ એ એક કાર્ય છે જેમાં દરેક વ્યક્તિ મુશ્કેલી અનુભવે છે. કદાચ, એટલા માટે કે તમે તમારા AI મોડેલોને જે ડેટાની ગુણવત્તા પર તાલીમ આપી રહ્યા છો તે તેમની ચોકસાઈ અને સફળતા નક્કી કરે છે.
ડેટા લેબલિંગ અથવા ડેટા એનોટેશન ક્યારેય એક વખતની ઘટના નથી. તે એક સતત પ્રક્રિયા છે. એવો કોઈ મહત્વપૂર્ણ મુદ્દો નથી જ્યાં તમને લાગે કે તમે પૂરતી તાલીમ લીધી છે અથવા તમારા AI મોડેલ્સ પરિણામો પ્રાપ્ત કરવામાં સચોટ છે.
પરંતુ, નવી તકોનો ઉપયોગ કરવાનું AI નું વચન ક્યાં ખોટું પડે છે? ક્યારેક ડેટા લેબલિંગ પ્રક્રિયા દરમિયાન.
AI સોલ્યુશન્સનો ઉપયોગ કરતા વ્યવસાયોમાં એક મુખ્ય મુશ્કેલી ડેટા એનોટેશન છે. તો ચાલો ટાળવા માટે ટોચની 5 ડેટા લેબલિંગ ભૂલો પર એક નજર કરીએ.
ટાળવા માટેની ટોચની 5 ડેટા લેબલિંગ ભૂલો
પ્રોજેક્ટ માટે પૂરતો ડેટા એકત્રિત ન કરવો
ડેટા આવશ્યક છે, પરંતુ તે તમારા પ્રોજેક્ટ લક્ષ્યો સાથે સુસંગત હોવો જોઈએ. મોડેલ સચોટ પરિણામો આપવા માટે, તેને તાલીમ આપવામાં આવેલ ડેટાને લેબલ થયેલ હોવો જોઈએ, ચોકસાઈ સુનિશ્ચિત કરવા માટે ગુણવત્તા તપાસવી જોઈએ.
જો તમે કાર્યરત, વિશ્વસનીય AI સોલ્યુશન વિકસાવવા માંગતા હો, તો તમારે તેને મોટી માત્રામાં ઉચ્ચ-ગુણવત્તાવાળા, સંબંધિત ડેટા ફીડ કરવો પડશે. અને, તમારે આ ડેટાને તમારા મશીન લર્નિંગ મોડેલ્સને સતત ફીડ કરવો પડશે જેથી તેઓ તમે પ્રદાન કરો છો તે માહિતીના વિવિધ ટુકડાઓને સમજી શકે અને સહસંબંધિત કરી શકે.
દેખીતી રીતે, તમે જેટલો મોટો ડેટા સેટ વાપરો છો, તેટલી સારી આગાહીઓ થશે.
ડેટા લેબલિંગ પ્રક્રિયામાં એક મુશ્કેલી એ છે કે ઓછા સામાન્ય ચલ માટે ખૂબ જ ઓછો ડેટા એકત્રિત કરવામાં આવે છે. જ્યારે તમે કાચા દસ્તાવેજોમાં સામાન્ય રીતે ઉપલબ્ધ ચલના આધારે છબીઓને લેબલ કરો છો, ત્યારે તમે તમારા ડીપ લર્નિંગ AI મોડેલને અન્ય ઓછા સામાન્ય ચલ પર તાલીમ આપી રહ્યા નથી.
ડીપ લર્નિંગ મોડેલો માટે હજારો ડેટા પીસની જરૂર પડે છે જેથી મોડેલ વાજબી રીતે સારું પ્રદર્શન કરી શકે. ઉદાહરણ તરીકે, જ્યારે જટિલ મશીનરી ચલાવવા માટે AI-આધારિત રોબોટિક આર્મને તાલીમ આપવામાં આવે છે, ત્યારે કામમાં દરેક નાના ફેરફાર માટે તાલીમ ડેટા સેટના બીજા બેચની જરૂર પડી શકે છે. પરંતુ, આવા ડેટા એકત્ર કરવા ખર્ચાળ અને ક્યારેક સંપૂર્ણપણે અશક્ય હોઈ શકે છે, અને કોઈપણ વ્યવસાય માટે ટીકા કરવી મુશ્કેલ હોઈ શકે છે.
ડેટા ગુણવત્તા માન્ય ન કરવી
ડેટા હોવો એક વાત છે, પણ તમે જે ડેટા સેટનો ઉપયોગ કરો છો તેને માન્ય કરવું પણ ખૂબ જ મહત્વપૂર્ણ છે જેથી ખાતરી કરી શકાય કે તે ઉચ્ચ ગુણવત્તા સાથે સુસંગત છે. જોકે, વ્યવસાયોને ગુણવત્તાયુક્ત ડેટા સેટ મેળવવામાં મુશ્કેલી પડે છે. સામાન્ય રીતે, બે મૂળભૂત પ્રકારના ડેટા સેટ હોય છે - વ્યક્તિલક્ષી અને ઉદ્દેશ્ય.

ઉદ્દેશ્ય ડેટા દ્વારા રજૂ કરાયેલ પડકાર એ છે કે લેબલર પાસે સાચા જવાબો ઓળખવા માટે ડોમેન અનુભવ અથવા જ્ઞાન ન હોવાનો જોખમ છે. માનવ ભૂલોને સંપૂર્ણપણે દૂર કરવી અશક્ય છે, તેથી ધોરણો અને બંધ-લૂપ પ્રતિસાદ પદ્ધતિ હોવી મહત્વપૂર્ણ બની જાય છે.

કાર્યબળ વ્યવસ્થાપન પર ધ્યાન કેન્દ્રિત ન કરવું
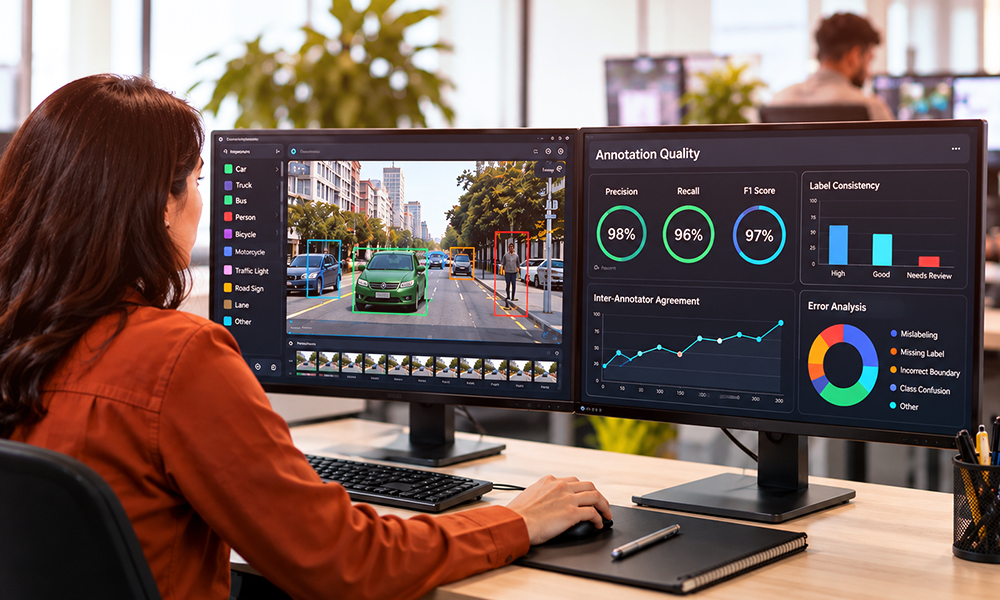
મશીન લર્નિંગ મોડેલો વિવિધ પ્રકારના મોટા ડેટા સેટ પર આધાર રાખે છે જેથી દરેક પરિસ્થિતિને પૂર્ણ કરી શકાય. જો કે, સફળ ઇમેજ એનોટેશન કાર્યબળ વ્યવસ્થાપન પડકારોના પોતાના સેટ સાથે આવે છે.
એક મુખ્ય સમસ્યા એ છે કે વિશાળ કાર્યબળનું સંચાલન કરવું જે મોટા અનસ્ટ્રક્ચર્ડ ડેટા સેટ્સને મેન્યુઅલી પ્રોસેસ કરી શકે છે. આગળનો મુદ્દો એ છે કે કાર્યબળમાં ઉચ્ચ-ગુણવત્તાના ધોરણો જાળવવા. ડેટા એનોટેશન પ્રોજેક્ટ્સ દરમિયાન ઘણી સમસ્યાઓ આવી શકે છે.
કેટલાક છે:
- નવા લેબલરોને એનોટેશન ટૂલ્સનો ઉપયોગ કરવા માટે તાલીમ આપવાની જરૂરિયાત
- કોડબુકમાં સૂચનાઓનું દસ્તાવેજીકરણ
- ટીમના બધા સભ્યો દ્વારા કોડબુકનું પાલન થાય તેની ખાતરી કરવી
- કાર્યપ્રણાલીને વ્યાખ્યાયિત કરવી - કોણ શું કરે છે તેની ક્ષમતાઓના આધારે ફાળવણી કરવી
- ક્રોસ-ચેકિંગ અને ટેકનિકલ સમસ્યાઓનું નિરાકરણ
- ડેટા સેટ્સની ગુણવત્તા અને માન્યતા સુનિશ્ચિત કરવી
- લેબલર ટીમો વચ્ચે સરળ સહયોગ પૂરો પાડવો
- લેબલર પૂર્વગ્રહ ઓછો કરવો
આ પડકારમાંથી પસાર થવા માટે, તમારે તમારા કાર્યબળ વ્યવસ્થાપન કૌશલ્ય અને ક્ષમતાઓમાં વધારો કરવો જોઈએ.
યોગ્ય ડેટા લેબલિંગ ટૂલ્સ પસંદ ન કરવા
2020 માં ડેટા એનોટેશન ટૂલ્સ માર્કેટનું કદ $1 બિલિયનથી વધુ હતું , અને 2027 સુધીમાં આ સંખ્યા 30% થી વધુ CAGR ના દરે વધવાની અપેક્ષા છે. ડેટા લેબલિંગ ટૂલ્સમાં જબરદસ્ત વૃદ્ધિ એ છે કે તે AI અને મશીન લર્નિંગના પરિણામને પરિવર્તિત કરે છે.
ઉપયોગમાં લેવાતી ટૂલિંગ તકનીકો એક ડેટા સેટથી બીજા ડેટા સેટમાં બદલાય છે. અમે જોયું છે કે મોટાભાગની સંસ્થાઓ ઇન-હાઉસ લેબલિંગ ટૂલ્સ વિકસાવવા પર ધ્યાન કેન્દ્રિત કરીને ડીપ લર્નિંગ પ્રક્રિયા શરૂ કરે છે. પરંતુ ખૂબ જ ટૂંક સમયમાં, તેમને ખ્યાલ આવે છે કે જેમ જેમ એનોટેશનની જરૂરિયાતો વધવા લાગે છે, તેમ તેમ તેમના ટૂલ્સ ગતિ જાળવી શકતા નથી. ઉપરાંત, ઇન-હાઉસ ટૂલ્સ વિકસાવવા ખર્ચાળ, સમય માંગી લેનાર અને વ્યવહારીક રીતે બિનજરૂરી છે.
મેન્યુઅલ લેબલિંગના રૂઢિચુસ્ત માર્ગે જવાને બદલે અથવા કસ્ટમ લેબલિંગ ટૂલ્સ વિકસાવવામાં રોકાણ કરવાને બદલે, તૃતીય પક્ષ પાસેથી ઉપકરણો ખરીદવા એ સમજદારી છે. આ પદ્ધતિ સાથે, તમારે ફક્ત તમારી જરૂરિયાત, પૂરી પાડવામાં આવતી સેવાઓ અને સ્કેલેબિલિટીના આધારે યોગ્ય સાધન પસંદ કરવાનું છે.
ડેટા સુરક્ષા માર્ગદર્શિકાનું પાલન ન કરવું
વધુ કંપનીઓ અનસ્ટ્રક્ચર્ડ ડેટાના મોટા સેટ એકત્રિત કરશે તેમ ડેટા સુરક્ષા પાલનમાં ટૂંક સમયમાં નોંધપાત્ર વધારો થશે. CCPA , DPA અને GDPR એ એન્ટરપ્રાઇઝ દ્વારા ઉપયોગમાં લેવાતા કેટલાક આંતરરાષ્ટ્રીય ડેટા સુરક્ષા પાલન ધોરણો છે.
લેબલિંગ કાર્યોને તૃતીય-પક્ષ પ્રદાતાઓને આઉટસોર્સ કરવાની વાત આવે ત્યારે સુરક્ષા પાલન એક મુખ્ય સમસ્યા બની જાય છે. ડેટા સુરક્ષા પ્રોજેક્ટની જટિલતામાં વધારો કરે છે, અને લેબલિંગ સેવા પ્રદાતાઓએ વ્યવસાયના નિયમોનું પાલન કરવું પડે છે.

તો, શું તમારો આગામી મોટો AI પ્રોજેક્ટ યોગ્ય ડેટા લેબલિંગ સેવાની રાહ જોઈ રહ્યો છે?
અમે માનીએ છીએ કે કોઈપણ AI પ્રોજેક્ટની સફળતા મશીન લર્નિંગ અલ્ગોરિધમમાં આપણે જે ડેટા સેટ ફીડ કરીએ છીએ તેના પર આધાર રાખે છે. અને, જો AI પ્રોજેક્ટ સચોટ પરિણામો અને આગાહીઓ આપશે તેવી અપેક્ષા રાખવામાં આવે છે, તો ડેટા એનોટેશન અને લેબલિંગ ખૂબ જ મહત્વપૂર્ણ છે. તમારા ડેટા એનોટેશન કાર્યોને આઉટસોર્સ કરીને , અમે તમને ખાતરી આપીએ છીએ કે તમે આ પડકારોને અસરકારક રીતે ઉકેલી શકો છો.
ઉચ્ચ-ગુણવત્તાવાળા ડેટા સેટ્સને સતત જાળવવા, ક્લોઝ્ડ-લૂપ પ્રતિસાદ આપવા અને કાર્યબળને અસરકારક રીતે સંચાલિત કરવા પર અમારા ધ્યાન સાથે, તમે ઉચ્ચ સ્તરની ચોકસાઈ લાવતા ઉચ્ચ-સ્તરીય AI પ્રોજેક્ટ્સ પહોંચાડી શકશો.
[આ પણ વાંચો: ઇન-હાઉસ અથવા આઉટસોર્સ્ડ ડેટા એનોટેશન - કયું વધુ સારા AI પરિણામો આપે છે? ]