ઓપ્ટિકલ કેરેક્ટર રેકગ્નિશન હવે રસીદ સ્કેનિંગ, ID વેરિફિકેશન, ઇન્વોઇસ ઓટોમેશન, ઐતિહાસિક આર્કાઇવ ડિજિટાઇઝેશન અને સ્ટાઇલસ-આધારિત નોટ એપ્સને સશક્ત બનાવે છે. OCR માર્કેટ 2030 સુધીમાં 14.8% CAGR (ગ્રાન્ડ વ્યૂ રિસર્ચ, 2024) પર $32.90 બિલિયન સુધી પહોંચવાનો અંદાજ છે, જેમાં બુદ્ધિશાળી કેરેક્ટર રેકગ્નિશન - OCR ની હસ્તલેખન-વાંચન શાખા - સૌથી ઝડપથી વિકસી રહી છે. તમે દસ્તાવેજ પાર્સિંગ, દ્રશ્ય-ટેક્સ્ટ શોધ, અથવા હસ્તલેખન ટ્રાન્સક્રિપ્શન બનાવી રહ્યા છો, તમે જે OCR ડેટાસેટ પર તાલીમ આપો છો તે તમારી ચોકસાઈ ટોચમર્યાદા નક્કી કરે છે. આ માર્ગદર્શિકા 22 મફત, ઓપન-સોર્સ OCR ડેટાસેટ્સનો સમાવેશ કરે છે - જેમાં શ્રેષ્ઠ હસ્તલેખન ડેટાસેટ્સનો સમાવેશ થાય છે - ઉપયોગ કેસ દ્વારા ગોઠવાયેલ છે અને 2024 સુધી સૌથી મજબૂત પ્રકાશનો સાથે તાજું કરવામાં આવ્યું છે.
કી ટેકવેઝ
- OCR (ઓપ્ટિકલ કેરેક્ટર રેકગ્નિશન): એવી ટેકનોલોજી જે મુદ્રિત, દ્રશ્ય અથવા હસ્તલિખિત ટેક્સ્ટની છબીઓને મશીન-વાંચી શકાય તેવા ડેટામાં રૂપાંતરિત કરે છે.
- OCR ડેટાસેટ્સ પાંચ જૂથોમાં વિભાજિત થાય છે: દસ્તાવેજ/સ્વરૂપ, દ્રશ્ય ટેક્સ્ટ, અંક/અક્ષર, હસ્તલેખન અને બહુભાષી.
- દસ્તાવેજ OCR ડેટાસેટ્સ ફોર્મ અને રસીદો જેવા માળખાગત પૃષ્ઠોને કેપ્ચર કરો; દ્રશ્ય-ટેક્સ્ટ ડેટાસેટ્સ "જંગલમાં" ટેક્સ્ટ કેપ્ચર કરો.
- IAM, MNIST, ICDAR, અને SROIE સંશોધનમાં સૌથી વધુ ટાંકવામાં આવતા OCR બેન્ચમાર્ક છે.
- લાયસન્સની શરતો વ્યાપકપણે બદલાય છે — વાણિજ્યિક તાલીમ પહેલાં દરેક OCR ડેટાસેટ ચકાસો.
OCR (ઓપ્ટિકલ કેરેક્ટર રેકગ્નિશન) શું છે?
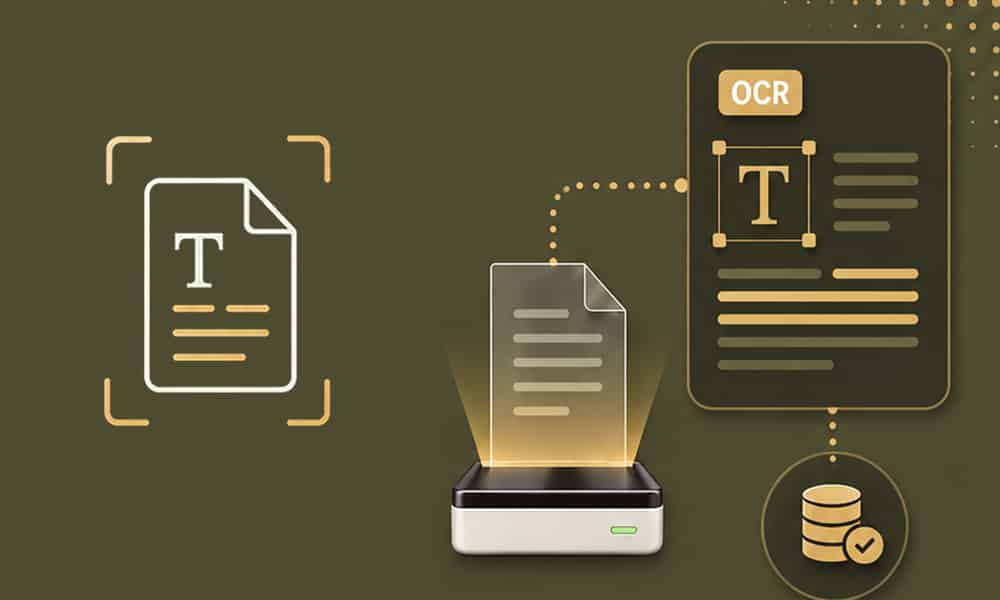
OCR એક એવી ટેકનોલોજી છે જે વિવિધ પ્રકારના દસ્તાવેજો, જેમ કે સ્કેન કરેલા કાગળના દસ્તાવેજો, PDF અથવા ટેક્સ્ટની છબીઓને સંપાદનયોગ્ય અને શોધી શકાય તેવા ડેટામાં રૂપાંતરિત કરે છે. તે આ રીતે કાર્ય કરે છે:
- છબીમાં ટેક્સ્ટની રચનાનું વિશ્લેષણ કરવું
- ટેક્સ્ટને લીટીઓ અને અક્ષરોમાં વિભાજીત કરવું
- આ દ્રશ્ય અક્ષરોને મશીન-વાંચી શકાય તેવા ટેક્સ્ટમાં રૂપાંતરિત કરવા
સામાન્ય ઉપયોગોમાં નીચેનાનો સમાવેશ થાય છે:
- સ્કેન કરેલા દસ્તાવેજોને સંપાદનયોગ્ય ટેક્સ્ટ ફાઇલોમાં રૂપાંતરિત કરવા
- છાપેલા પુસ્તકોનું ડિજિટાઇઝેશન
- ફોટામાંથી ટેક્સ્ટ કાઢી રહ્યા છીએ
- હસ્તલિખિત પ્રિસ્ક્રિપ્શનોને ડિજિટલ ટેક્સ્ટમાં રૂપાંતરિત કરવા
- લાઇસન્સ પ્લેટ ઓળખ
તમે યોગ્ય OCR ડેટાસેટ કેવી રીતે પસંદ કરશો?
OCR ડેટાસેટ પસંદ કરવાનું ચાર પરિબળો પર આધાર રાખે છે: ટેક્સ્ટ પ્રકાર, કેપ્ચર વાતાવરણ, એનોટેશન ગ્રેન્યુલારિટી અને લાઇસન્સ. પ્રિન્ટેડ-ડોક્યુમેન્ટ OCR ને હસ્તલિખિત કર્સિવ અથવા વક્ર દ્રશ્ય ટેક્સ્ટ કરતાં અલગ તાલીમ ડેટાની જરૂર છે. દસ્તાવેજ ડેટાસેટ્સ ઇન્વોઇસ, ફોર્મ્સ અને રસીદોને અનુકૂળ કરે છે; દ્રશ્ય-ટેક્સ્ટ ડેટાસેટ્સ સાઇનેજ અને પ્રોડક્ટ વાંચનને અનુકૂળ કરે છે; હસ્તલેખન ડેટાસેટ્સ નોંધો, હસ્તપ્રતો અને સ્ટાઇલસ ઇનપુટને અનુકૂળ કરે છે. શબ્દ-સ્તર અને રેખા-સ્તર એનોટેશન સંપૂર્ણ OCR પાઇપલાઇન્સને સપોર્ટ કરે છે, જ્યારે અક્ષર-સ્તર સેટ વર્ગીકરણ બેઝલાઇનને ફિટ કરે છે. હંમેશા લાઇસન્સ શરતોની પુષ્ટિ કરો, કારણ કે કેટલાક OCR ડેટાસેટ્સ ફક્ત સંશોધન માટે હોય છે અથવા નોંધણીની જરૂર હોય છે.
શ્રેષ્ઠ દસ્તાવેજ અને ફોર્મ OCR ડેટાસેટ્સ કયા છે?
દસ્તાવેજ OCR ડેટાસેટ્સ મોડેલ્સને ઇન્વોઇસ, ફોર્મ, રસીદો અને ID જેવા માળખાગત પૃષ્ઠોનું વિશ્લેષણ કરવા માટે તાલીમ આપે છે. આ વ્યવસાય દસ્તાવેજ ઓટોમેશન અને કી-વેલ્યુ નિષ્કર્ષણને શક્તિ આપે છે.
- ફનએસડી — ઘોંઘાટીયા, વાસ્તવિક દુનિયાના દેખાવ સાથે ૧૯૯ એનોટેટેડ સ્કેન કરેલા ફોર્મ. ફોર્મ સમજણ અને કી-મૂલ્ય નિષ્કર્ષણ માટે માનક બેન્ચમાર્ક.
- સ્રોઇ — ICDAR 2019 સ્કેન કરેલ-રસીદ ડેટાસેટ આશરે 1,000 રસીદોનો છે, જે એક જ સેટમાં ટેક્સ્ટ શોધ, ઓળખ અને માહિતી નિષ્કર્ષણને સપોર્ટ કરે છે.
- કોર્ડ — ઇન્વોઇસ અને રિસિપ્ટ ઓટોમેશન માટે સમૃદ્ધ ફીલ્ડ-લેવલ લેબલ્સ સાથે, પોસ્ટ-ઓસીઆર પાર્સિંગ માટે બનાવેલ એક સંકલિત રસીદ ડેટાસેટ.
- XFUND — FUNSD નું બહુભાષી વિસ્તરણ જે સાત ભાષાઓ (જર્મન, સ્પેનિશ, ફ્રેન્ચ, ઇટાલિયન, જાપાનીઝ, પોર્ટુગીઝ, ચાઇનીઝ) ને આવરી લે છે, જેમાં પ્રત્યેક ૧૯૯ પાના છે. બહુભાષી દસ્તાવેજ AI માટે આદર્શ.
- ડીડીઆઈ-100 — સ્ક્યુ, બ્લર અને નોઇઝ જેવા વાસ્તવિક-દુનિયાના અધોગતિ હેઠળ શોધ અને ઓળખ માટે લગભગ 100,000 વિકૃત દસ્તાવેજ છબીઓ.
શ્રેષ્ઠ સીન ટેક્સ્ટ OCR ડેટાસેટ્સ કયા છે?
સીન-ટેક્સ્ટ OCR ડેટાસેટ્સ મોડેલોને કુદરતી છબીઓ જેમ કે ચિહ્નો, ઉત્પાદનો અને શેરી દ્રશ્યોમાં ટેક્સ્ટ વાંચવા માટે તાલીમ આપે છે. આ જંગલી OCR માટે આવશ્યક છે જ્યાં પૃષ્ઠભૂમિ અવ્યવસ્થિત હોય છે.
- ICDAR રોબસ્ટ રીડિંગ — મોટાભાગના દ્રશ્ય-ટેક્સ્ટ સંશોધન પાછળનો બેન્ચમાર્ક પરિવાર, જેમાં ફોકસ્ડ અને આકસ્મિક દ્રશ્ય ટેક્સ્ટનો સમાવેશ થાય છે, તે શબ્દ-સ્તરના બાઉન્ડિંગ બોક્સ અને ટ્રાન્સક્રિપ્શન સાથેના પડકારોનો સામનો કરે છે.
- COCO-ટેક્સ્ટ — MS-COCO છબીઓ પર સ્તરવાળી મોટા પાયે દ્રશ્ય-ટેક્સ્ટ એનોટેશન. કુદરતી દ્રશ્યોમાં સ્કેલ પર ટેક્સ્ટ શોધ માટે મજબૂત.
- કુલ-ટેક્સ્ટ — વક્ર અને મનસ્વી રીતે લક્ષી ટેક્સ્ટમાં નિષ્ણાત, જે જૂના OCR મોડેલો માટે જાણીતું નબળું બિંદુ છે.
- SVT (સ્ટ્રીટ વ્યૂ ટેક્સ્ટ) — ગૂગલ સ્ટ્રીટ વ્યૂમાંથી લેવામાં આવેલી વર્ડ છબીઓ, ઘણીવાર ઓછી રીઝોલ્યુશન અને ઉચ્ચ ચલતા. પેપર્સ વિથ કોડ મિરર્સ દ્વારા ઉપલબ્ધ.
- હાઇરટેક્સ્ટ — ફકરાથી વાક્ય સુધીના શબ્દ સુધીના હાયરાર્કિકલ એનોટેશન, હસ્તલિખિત અને મુદ્રિત દ્રશ્ય ટેક્સ્ટ બંનેને આવરી લે છે. લેઆઉટ-જાગૃત OCR માટે ઉપયોગી.
શ્રેષ્ઠ અંક અને અક્ષર OCR ડેટાસેટ્સ કયા છે?
અંક અને અક્ષર OCR ડેટાસેટ્સ મોડેલોને નિયંત્રિત સેટિંગ્સમાં વ્યક્તિગત પ્રતીકોને ઓળખવા માટે તાલીમ આપે છે. વર્ગીકરણ બેઝલાઇન માટે આ પ્રમાણભૂત પ્રારંભિક બિંદુઓ છે.
- MNIST — ૭૦,૦૦૦ ગ્રેસ્કેલ હસ્તલિખિત અંક છબીઓ. અંક વર્ગીકૃતને માન્ય કરવા માટે સૌથી ઝડપી આધારરેખા.
- અર્થશાસ્ત્રી — NIST સ્પેશિયલ ડેટાબેઝ 19 માંથી મેળવેલા 814,255 હસ્તલિખિત અક્ષરો અને અંકો સાથે MNIST ને વિસ્તૃત કરે છે.
- SVHN (સ્ટ્રીટ વ્યૂ હાઉસ નંબર્સ) — ઘરના નંબરોમાંથી 600,000 થી વધુ વાસ્તવિક-વિશ્વના અંકોની છબીઓ. ઘોંઘાટીયા વાતાવરણ માટે MNIST તરફથી એક વ્યવહારુ પગલું.
- અક્ષરો74K — કુદરતી છબીઓ અને કમ્પ્યુટર ફોન્ટ્સમાંથી અંગ્રેજી અને કન્નડ અક્ષરોને આવરી લેતી 74,107 છબીઓ.
- NIST સ્પેશિયલ ડેટાબેઝ 19 — ૩,૬૦૦ લેખકો દ્વારા ૮૧૦,૦૦૦+ હાથથી છાપેલા પાત્ર ચિત્રો. ઘણા અંગ્રેજી OCR બેન્ચમાર્ક જે સ્ત્રોતમાંથી લેવામાં આવ્યા છે.
OCR માટે શ્રેષ્ઠ હસ્તલેખન ડેટાસેટ્સ કયા છે?
હસ્તલેખન ડેટાસેટ્સ OCR મોડેલોને કર્સિવ, પ્રિન્ટેડ અને ઐતિહાસિક હસ્તલેખિત ટેક્સ્ટ વાંચવા માટે તાલીમ આપે છે. સૌથી મજબૂત ઓપન હેન્ડરાઇટિંગ ડેટાસેટ્સ હસ્તલેખિત ટેક્સ્ટ ઓળખ (HTR) માટે સૌથી વધુ ટાંકવામાં આવતા બેન્ચમાર્ક રહે છે.
- IAM હસ્તલેખન ડેટાબેઝ — અંગ્રેજી હસ્તલેખન સુવર્ણ માનક, જેમાં 657 લેખકો દ્વારા 13,353 ટેક્સ્ટ લાઇનો છે. 2024-2025 OCR સંશોધનમાં હજુ પણ સૌથી વધુ ટાંકવામાં આવેલ હસ્તલેખન ડેટાસેટ છે.
- IAM-OnDB — IAM નું ઓનલાઈન પેન-સ્ટ્રોક વર્ઝન, ટ્રેજેક્ટરી ડેટા કેપ્ચર કરે છે. સ્ટાઇલસ અને ટેબ્લેટ ઓળખ માટે કેનોનિકલ હેન્ડરાઇટિંગ ડેટાસેટ.
- બેન્થમ પેપર્સ — ફિલોસોફર જેરેમી બેન્થમ દ્વારા લખાયેલી ઐતિહાસિક અંગ્રેજી હસ્તપ્રતો. ઐતિહાસિક હસ્તલેખન OCR માટેનો અગ્રણી માપદંડ, ટ્રાન્સક્રિબસ દ્વારા સુલભ.
- GNHK (ગુડનોટ્સ હસ્તલેખન સંગ્રહ) — 2021નો ડેટાસેટ જે વાસ્તવિક દુનિયાની અંગ્રેજી હસ્તલિખિત નોંધોનો અનિયંત્રિત ભાગ છે. લેબ-ક્લીન IAM કરતાં અવ્યવસ્થિત ઉત્પાદન ડેટાની નજીક.
શ્રેષ્ઠ બહુભાષી અને બિન-લેટિન OCR ડેટાસેટ્સ કયા છે?
બહુભાષી OCR ડેટાસેટ્સ અંગ્રેજી ઉપરાંતની સ્ક્રિપ્ટો પર મોડેલો તાલીમ આપે છે, જેમાં ચાઇનીઝ, અરબી અને ગાણિતિક સંકેતનો સમાવેશ થાય છે. આ વૈશ્વિક દસ્તાવેજ અને હસ્તલેખન ઓળખ માટે આવશ્યક છે.
- કેસિયા-એચડબલ્યુડીબી — પ્રમાણભૂત ચાઇનીઝ OCR બેન્ચમાર્ક, ૧,૦૨૦ લેખકોના ૧.૧૭ મિલિયન હસ્તલિખિત પાત્ર નમૂનાઓ સાથે.
- ખાટ — ૧,૦૦૦ અલગ-અલગ લેખકોના ૧,૦૦૦ અરબી હસ્તલિખિત ફોર્મ, બહુવિધ રિઝોલ્યુશન પર સ્કેન કરવામાં આવ્યા. સૌથી વ્યાપક ઓપન અરબી OCR ડેટાસેટ.
- ક્રોમ — ઓનલાઈન હસ્તલિખિત ગાણિતિક અભિવ્યક્તિઓની ઓળખ પર સ્પર્ધા: ૧૦૧+ ગણિત પ્રતીકોમાં ૧૦,૦૦૦+ અભિવ્યક્તિઓ, ઓનલાઈન અને ઓફલાઈન બંને પ્રકારોમાં. હસ્તલિખિત સમીકરણ OCR માટે આવશ્યક.
મફત OCR ડેટાસેટ્સનો ઉપયોગ કરતી વખતે સામાન્ય મુશ્કેલીઓ શું છે?
મોટાભાગની ટીમોને ત્રણ મુશ્કેલીઓનો સામનો કરવો પડે છે.
ડોમેન મિસમેચ: સ્વચ્છ IAM અથવા COCO-ટેક્સ્ટ પર તાલીમ આપવી અને ચોળાયેલા ઇન્વોઇસ પર ડિપ્લોય કરવાથી નબળી ચોકસાઈની ખાતરી મળે છે.
લાઇસન્સ બ્લાઇન્ડનેસ: ઘણા દ્રશ્ય-ટેક્સ્ટ અને ઐતિહાસિક OCR ડેટાસેટ્સ ફક્ત સંશોધન માટે છે અથવા વ્યાપારી ઉપયોગ પહેલાં નોંધણીની જરૂર છે.
ટીકાઓમાં ખામીઓ: ઘણા OCR ડેટાસેટ્સમાં ઉત્પાદન સિસ્ટમોને જરૂરી લેઆઉટ મેટાડેટા, લાઇન-લેવલ બાઉન્ડિંગ બોક્સ અથવા ફીલ્ડ લેબલ્સનો અભાવ હોય છે.
એક મધ્યમ કદની લોજિસ્ટિક્સ ફર્મની કલ્પના કરો જે શિપિંગ-લેબલ રીડિંગને સ્વચાલિત કરે છે. જાહેર દ્રશ્ય-ટેક્સ્ટ તાલીમ તેમને બેન્ચમાર્ક પર 80% સુધી પહોંચાડે છે, પરંતુ ઝગઝગાટ અને ફોલ્ડ્સવાળા વાસ્તવિક લેબલ્સ તેમને 58% સુધી ઘટાડી દે છે. આ અંતરને પૂર્ણ કરવા માટે લોન્ચ પહેલાં 6,000 ઇન-ડોમેન લેબલ છબીઓનું લક્ષિત ડેટા એનોટેશન જરૂરી છે.
ઓપન-સોર્સ ડેટાસેટ્સના ફાયદા અને પડકારો
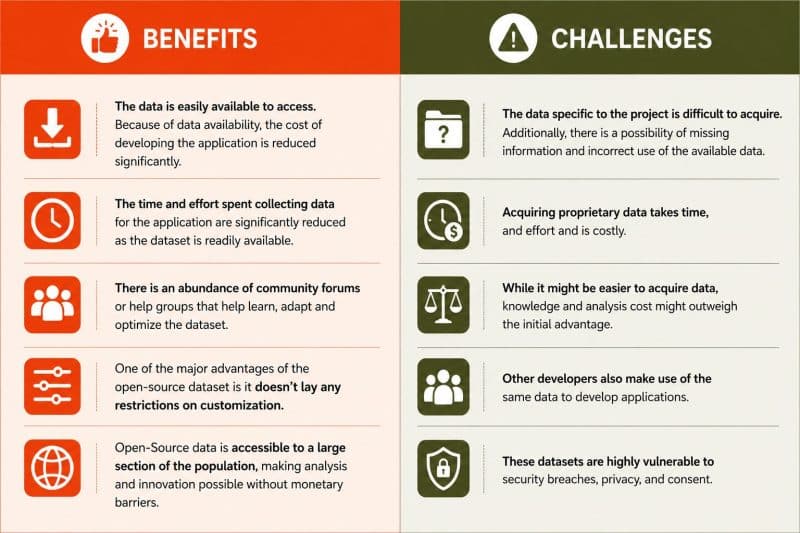
વ્યવસાયોએ તેમના ML એપ્લિકેશનો માટે ફ્રી-ટુ-યુઝ ડેટા પસંદ કરવો જોઈએ કે નહીં તે સમજવા માટે એકબીજા સામે ફાયદા અને પડકારોનો સામનો કરવાની જરૂર છે.
લાભો
- ડેટા સરળતાથી ઉપલબ્ધ છે. ડેટા ઉપલબ્ધતાને કારણે, એપ્લિકેશન વિકસાવવાનો ખર્ચ નોંધપાત્ર રીતે ઓછો થાય છે.
- ડેટાસેટ સરળતાથી ઉપલબ્ધ હોવાથી એપ્લિકેશન માટે ડેટા એકત્રિત કરવામાં ખર્ચવામાં આવતો સમય અને મહેનત નોંધપાત્ર રીતે ઓછી થાય છે.
- ડેટાસેટ શીખવા, અનુકૂલન કરવા અને ઑપ્ટિમાઇઝ કરવામાં મદદ કરતા સમુદાય મંચો અથવા સહાય જૂથોની વિપુલતા છે.
- ઓપન-સોર્સ ડેટાસેટનો એક મોટો ફાયદો એ છે કે તે કસ્ટમાઇઝેશન પર કોઈ નિયંત્રણો લાદતો નથી.
- ઓપન-સોર્સ ડેટા વસ્તીના મોટા ભાગ માટે સુલભ છે, જે નાણાકીય અવરોધો વિના વિશ્લેષણ અને નવીનતા શક્ય બનાવે છે.
પડકારો
- પ્રોજેક્ટ માટે વિશિષ્ટ ડેટા મેળવવો મુશ્કેલ છે. વધુમાં, ગુમ થયેલ માહિતી અને ઉપલબ્ધ ડેટાનો ખોટો ઉપયોગ થવાની સંભાવના છે.
- માલિકીનો ડેટા મેળવવામાં સમય અને પ્રયત્ન લાગે છે અને તે ખર્ચાળ પણ છે.
- ડેટા મેળવવાનું સરળ હોઈ શકે છે, પરંતુ જ્ઞાન અને વિશ્લેષણનો ખર્ચ શરૂઆતના ફાયદા કરતાં વધી શકે છે.
- અન્ય ડેવલપર્સ પણ એપ્લિકેશન વિકસાવવા માટે સમાન ડેટાનો ઉપયોગ કરે છે.
- આ ડેટાસેટ્સ સુરક્ષા ભંગ, ગોપનીયતા અને સંમતિ માટે ખૂબ જ સંવેદનશીલ છે.
શેપ OCR અને હસ્તલેખન ઓળખ પ્રોજેક્ટ્સને કેવી રીતે સમર્થન આપે છે?
શેપની OCR તાલીમ ડેટા સેવાઓ 60+ ભાષાઓમાં કસ્ટમ ડેટા સંગ્રહ સાથે ઓપન-ડેટાસેટ ક્યુરેશનને જોડે છે , જેમાં પ્રિન્ટેડ દસ્તાવેજો, હસ્તલેખન, રસીદો અને IDનો સમાવેશ થાય છે. શેપના એનોટેશન વર્કફ્લો જાહેર OCR ડેટાસેટ્સ ચૂકી ગયેલા સ્તરોને ઉમેરે છે: લાઇન-લેવલ બાઉન્ડિંગ બોક્સ, ફીલ્ડ-લેવલ લેબલ્સ, ટ્રાન્સક્રિપ્શન QC અને રાઇટર મેટાડેટા.
ઉપસંહાર
ઉપરોક્ત 22 OCR ડેટાસેટ્સ તમને 2026 માટે દસ્તાવેજ, દ્રશ્ય ટેક્સ્ટ, અંક, હસ્તલેખન અને બહુભાષી ઓળખ માટે સંપૂર્ણ ઓપન-સોર્સ પાયો આપે છે. તમારા ટેક્સ્ટ પ્રકાર અને કેપ્ચર વાતાવરણ સાથે મેળ ખાતા OCR ડેટાસેટથી શરૂઆત કરો, તમારા વાસ્તવિક ડેટાના રાખવામાં આવેલા નમૂના સામે માન્ય કરો અને ડોમેન ગેપને બંધ કરવા માટે કસ્ટમ એનોટેશન માટે બજેટ બનાવો. આ સંયોજન શરૂઆતથી બનાવવા કરતાં વધુ ઝડપથી આવે છે.